18. Diagnóstico integral: seguir evidencia por capas#
Este diagnóstico no es un examen de velocidad ni un trámite burocrático de certificación. El objetivo fundamental es modelar cómo razona un ingeniero de software principal ante fallas complejas y entrelazadas en producción: separar hechos observables de suposiciones intuitivas, predecir consecuencias operativas, formular hipótesis científicamente falsables y diseñar el cambio de código mínimo que restaure las invariantes del sistema sin introducir efectos secundarios.
Objetivo#
Al finalizar esta lección podrás:
- Conducir una investigación forense transversal a lo largo de las 6 capas del stack: formulario web, asincronía en TypeScript, contrato HTTP, autorización de recursos en Rust, transacciones ACID en PostgreSQL y mecanismos de entrega en red.
- Distinguir de forma sistemática entre observaciones empíricas irrefutables e hipótesis causales, formulando pruebas de refutación (falsifiers) antes de tocar el código de producción.
- Diagnosticar y erradicar la carrera de respuestas fuera de orden en el frontend mediante números de secuencia o señales de cancelación (
AbortController). - Prevenir la anomalía de Actualización Perdida (Lost Update) en bases de datos concurrentes mediante Control de Concurrencia Optimista (OCC) atómico en SQL.
- Resolver el problema de la doble escritura (Dual-Write Problem) entre PostgreSQL y servicios remotos mediante el patrón de diseño Transactional Outbox.
- Mitigar la ambigüedad de los tiempos de espera de red (network timeouts) implementando contratos de mutación idempotente con claves de deduplicación (
Idempotency-Key).
Antes de empezar#
Debes articular con fluidez los conocimientos acumulados a lo largo de las lecciones 01 a 17:
- Modelo de concurrencia y préstamos de Rust (módulo 01).
- Contratos REST, middleware y manejo transaccional de errores (módulos 02 y 04).
- Manejo de asincronía en el DOM y ciclo de vida de componentes React (módulo 03).
- Autorización por objeto y telemetría estructurada sin filtración de secretos (lecciones 16 y 17).
El escenario de esta lección es un diagnóstico forense completo. No necesitas levantar servicios en la nube ni bases de datos remotas: trabajaremos sobre trazas de ejecución, capturas de red, consultas SQL y modelos ejecutables en Rust estándar (std-only). Resuelve cada etapa de razonamiento antes de avanzar a la siguiente.
Si encuentras términos desconocidos durante el estudio de esta lección, consulta el glosario técnico.
Diccionario de conceptos de la lección (Glosario desde cero)#
Para estructurar una investigación metódica sin caer en el ensayo y error caótico (shotgun debugging), definimos los conceptos fundamentales bajo cuatro dimensiones: intuición cotidiana, definición técnica formal, ejemplo concreto y concepción errónea frecuente.
1. Hipótesis refutable / Falsabilidad en diagnóstico de sistemas#
- Intuición cotidiana: Si sospechas que una lámpara no enciende porque la bombilla está quemada, puedes desenroscarla y probarla en otra lámpara que sí funcione: si enciende en la otra lámpara, tu hipótesis queda refutada de inmediato en 5 segundos. Si en cambio afirmas: "La lámpara no enciende porque hay malas energías en la habitación", ninguna prueba física puede refutarlo y nunca sabrás si el problema era el enchufe o el cable cortado.
- Definición técnica precisa: Principio epistemológico fundamental (propuesto por Karl Popper) aplicado a la ingeniería de sistemas: una hipótesis diagnóstica solo es útil y científica si define con precisión una observación empírica o experimento que, de ocurrir, demostraría sin ambigüedades que la hipótesis es falsa. Toda hipótesis que no pueda ser refutada mediante una prueba concreta carece de valor operativo y desvía la investigación.
- Ejemplo en diagnóstico:
- Hipótesis no falsable (Inútil): "El frontend anda raro y a veces no sincroniza bien".
- Hipótesis falsable (Útil): "La respuesta HTTP de la petición A (título viejo) llegó al navegador 200 ms después que la respuesta de B, y el manejador
fetch.then()sobrescribió el estado local. Prueba de refutación: Inspeccionar los identificadores y timestamps en la pestaña Network de DevTools; si la respuesta de A llegó antes que la de B, la hipótesis queda refutada". - Concepción errónea: Tratar las corazonadas o la intuición de culpabilidad ("seguro es culpa de la base de datos") como hipótesis de trabajo. Modificar código al azar basándose en suposiciones no verificadas destruye la evidencia causal y suele introducir defectos adicionales.
2. Problema de los Dos Generales y Ambigüedad de timeout en red#
- Intuición cotidiana: Dos generales en colinas opuestas deben atacar una fortaleza al mismo tiempo para ganar. El General 1 envía un mensajero a pie que cruza territorio enemigo con una carta que dice: "Ataquemos a las 09:00". Si el mensajero no regresa, el General 1 no sabe si: (a) el mensajero fue capturado antes de entregar el mensaje, (b) el mensaje fue entregado pero capturaron al mensajero de regreso con la confirmación, o (c) el General 2 aceptó y atacará puntualmente. Ningún número de cartas puede garantizar certidumbre absoluta a través de un canal no confiable.
- Definición técnica precisa: Teorema fundamental de la computación distribuida que demuestra la imposibilidad de alcanzar consenso garantizado entre dos partes conectadas por un canal de comunicación con pérdidas. En HTTP, cuando un cliente experimenta un tiempo de espera agotado (timeout), se enfrenta a una incertidumbre tripartita irreducible:
- La petición se perdió antes de llegar al servidor (el servidor nunca procesó nada).
- El servidor procesó la mutación y la persistió en la base de datos, pero la respuesta de confirmación se perdió en el cable de regreso.
- El servidor continúa procesando la transacción de forma extraordinariamente lenta y aún no termina.
- Concepción errónea: Asumir que cuando
fetch()arroja una excepción de TimeoutError, la operación en el servidor "falló o no se ejecutó". Si el cliente reintenta ciegamente una petición de cobro financiero tras un timeout, cobrará dos veces al usuario.
3. Anomalía de Actualización Perdida (Lost Update) y Last-Write-Wins (LWW)#
- Intuición cotidiana: Dos personas editan al mismo tiempo un documento impreso de 100 páginas que fotocopiaron a las 10:00. La persona B corrige una errata en la página 10 y entrega su fotocopia a las 10:05. La persona A cambia un párrafo en la página 80 y entrega su fotocopia a las 10:06. Si el archivista simplemente sustituye el documento completo con la fotocopia de A porque fue la última en llegar, la corrección que hizo B en la página 10 se destruye silenciosamente y se pierde para siempre.
- Definición técnica precisa: Anomalía de concurrencia clásica en bases de datos donde dos transacciones concurrentes leen la misma fila, calculan modificaciones independientes basadas en esa lectura y ambas escriben sus cambios mediante operaciones
UPDATE. La transacción que escribe en último lugar sobrescribe completamente los cambios de la primera sin haberlos considerado, provocando pérdida de datos. La estrategia pasiva de permitir esto se conoce como Last-Write-Wins (LWW). - Ejemplo en SQL vulnerable:
  -- Alicia y Bob leen: version = 1
  -- Bob ejecuta y persiste a las 10:05:
  UPDATE notes SET title = 'Bob title' WHERE id = 52;
  -- Alicia ejecuta a las 10:06 sin validar versión:
  UPDATE notes SET title = 'Alicia title' WHERE id = 52;
-- ¡La actualización de Bob se perdió completamente!- Concepción errónea: Pensar que configurar el nivel de aislamiento de transacciones de PostgreSQL en
READ COMMITTEDpreviene las actualizaciones perdidas entre solicitudes HTTP distintas. El aislamiento de transacciones solo aplica mientras dura una única conexión SQL; no protege entre peticiones HTTP desacopladas en el tiempo.
4. Control de Concurrencia Optimista (OCC con columna version o ETag)#
- Intuición cotidiana: Cuando retiras un libro de la biblioteca para editar notas, el libro tiene un sello que dice: "Edición 4". Cuando regresas con tus correcciones, el bibliotecario comprueba: "¿Sigue el libro en la edición 4?". Si alguien más ya publicó la edición 5 mientras tú leías en casa, el bibliotecario rechaza tus notas y te pide: "Revisa primero los cambios de la edición 5 antes de aplicar los tuyos".
- Definición técnica precisa: Estrategia de control de concurrencia que asume que los conflictos son infrecuentes (por ende, optimista). En lugar de bloquear la fila en la base de datos mientras el usuario edita en su navegador, el registro incluye un número de versión monótonamente creciente (
version: BIGINT) o un hash (ETag). La mutación se ejecuta atómicamente condicionada a que la versión no haya cambiado:
  UPDATE notes
  SET title = $1, version = version + 1
  WHERE id = $2 AND version = $3;
Si otra transacción modificó la fila primero, version ya no coincidirá, la consulta afectará exactamente 0 filas, y el servidor retornará un error semántico HTTP 409 Conflict.
- Concepción errónea: Confundir el control optimista con bloqueos pesimistas (
SELECT ... FOR UPDATE). OCC no retiene locks de base de datos durante los segundos o minutos que el usuario tarda en escribir en el navegador; el chequeo ocurre en microsegundos exclusivamente al ejecutar elUPDATE.
5. Problema de la Doble Escritura (Dual-Write Problem)#
- Intuición cotidiana: Tienes que depositar dinero en un banco local y al salir cruzar la calle para avisar a la oficina de impuestos. Depositas el dinero con éxito en la ventanilla, pero al cruzar la calle un camión bloquea la avenida o la oficina de impuestos está cerrada por huelga. El dinero ya está en el banco, pero el registro de impuestos nunca se enteró. No puedes "deshacer" mágicamente el dinero ya depositado.
- Definición técnica precisa: Imposibilidad de garantizar consistencia atómica sin coordinación transaccional distribuida (como el costoso protocolo 2PC) cuando una aplicación intenta modificar dos sistemas de almacenamiento independientes (por ejemplo: una base de datos relacional PostgreSQL y una llamada HTTP a un servicio externo de auditoría o una cola de mensajería Kafka). Si el proceso falla o la red se interrumpe después de escribir en el primer sistema pero antes de escribir en el segundo, los sistemas quedan en un estado permanentemente inconsistente.
- Concepción errónea: Intentar resolver la doble escritura envolviendo la llamada HTTP externa dentro de un bloque
BEGIN ... COMMITde PostgreSQL. Si la transacción SQL haceCOMMITcon éxito y milisegundos después se corta la conexión HTTP con el servicio externo, el commit ya es irreversible en disco y la auditoría se perdió.
6. Patrón Transactional Outbox y entrega At-Least-Once#
- Intuición cotidiana: En lugar de caminar hasta la oficina de impuestos cada vez que haces un trámite, colocas una copia del recibo en una bandeja metálica sellada ("Outbox") dentro de tu propia oficina bancaria. Una vez al día, un cartero toma los recibos pendientes de la bandeja, viaja a la oficina de impuestos y no saca el recibo de su lista hasta que el inspector le firma un acuse de recibo. Si el cartero se retrasa, lo reintenta mañana.
- Definición técnica precisa: Patrón de integración donde los eventos destinados a sistemas externos (auditoría, colas, analítica) se insertan en una tabla dedicada (
outbox) dentro de la misma transacción ACID de PostgreSQL que modifica los datos del negocio. Dado que ambas escrituras ocurren en el mismo motor de base de datos, la atomicidad está 100% garantizada. Un proceso en segundo plano (worker) lee periódicamente los eventos con estadoPENDING, los despacha al servicio externo mediante HTTP con reintentos exponenciales, y solo cuando recibe confirmación exitosa (200 OK), marca el evento comoDISPATCHED. - Concepción errónea: Asumir que el patrón Outbox ofrece entrega exactamente una vez (Exactly-Once). Debido a la ambigüedad de red de los timeouts, el worker puede reenviar un evento cuya confirmación previa se perdió, provocando que el servicio remoto reciba el evento más de una vez (At-Least-Once delivery). Por ello, el receptor debe ser obligatoriamente un consumidor idempotente.
7. Consumidor idempotente (Idempotency-Key)#
- Intuición cotidiana: El botón de un elevador: no importa si una persona impaciente presiona el botón de "Piso 5" una sola vez o veinte veces seguidas; el elevador registra la llamada una única vez y viaja al piso 5 exactamente igual.
- Definición técnica precisa: Propiedad de una operación donde el efecto de ejecutarla múltiples veces consecutivas con los mismos parámetros es idéntico al efecto de ejecutarla una sola vez. En APIs REST para operaciones mutantes (
POST), se implementa mediante la cabeceraIdempotency-Key: <UUID>. El servidor almacena la clave en una tabla transaccional junto con el resultado de la operación: si recibe una petición con una clave ya procesada, no reejecuta la lógica de negocio ni inserta registros duplicados; simplemente retorna la respuesta previamente calculada. - Concepción errónea: Creer que las operaciones
POSTson idempotentes por naturaleza. En el estándar HTTP (RFC 7231),GET,PUTyDELETEdeben ser idempotentes, peroPOSTno lo es a menos que se implemente explícitamente un mecanismo de deduplicación por clave.
8. Máquina de estados de interfaz (UI State Machine) y número de secuencia de solicitud#
- Intuición cotidiana: Un tablero de llegadas en una estación de tren que solo actualiza la información si el telegrama recibido tiene una marca de hora más reciente que la que ya está proyectada en la pantalla: si llega una carta vieja con retraso de hace 3 horas, el operador la descarta de inmediato para no desorientar a los pasajeros.
- Definición técnica precisa: Patrón de diseño en el cliente (React/TypeScript) donde cada mutación asíncrona lanzada incrementa un contador monotónico de secuencia local (
sequenceNumber). Al resolver la promesa de red, el componente compara el número de secuencia de la respuesta recibida con el número de secuencia más reciente activo en el estado: si la respuesta corresponde a una petición anterior (response.seq < current.seq), la respuesta se descarta silenciosamente, evitando que una respuesta lenta de una solicitud vieja sobrescriba un estado más nuevo de la pantalla. - Concepción errónea: Confiar únicamente en
AbortController.abort()para gestionar la concurrencia en la interfaz. Aunqueabort()cancela la recepción de bytes en el navegador, no impide que la petición haya alcanzado al servidor y haya mutado el estado remoto antes de ser abortada.
Modelo mental y análisis en profundidad#
flowchart TD
  B[Form submit] --> T[Client validation]
  T --> H[HTTP request]
  H --> I[Verified identity]
  I --> Z[Resource authorization]
  Z --> DB[(Transaction and constraints)]
  DB --> O[Response and UI state]
  O --> L[Safe correlated evidence]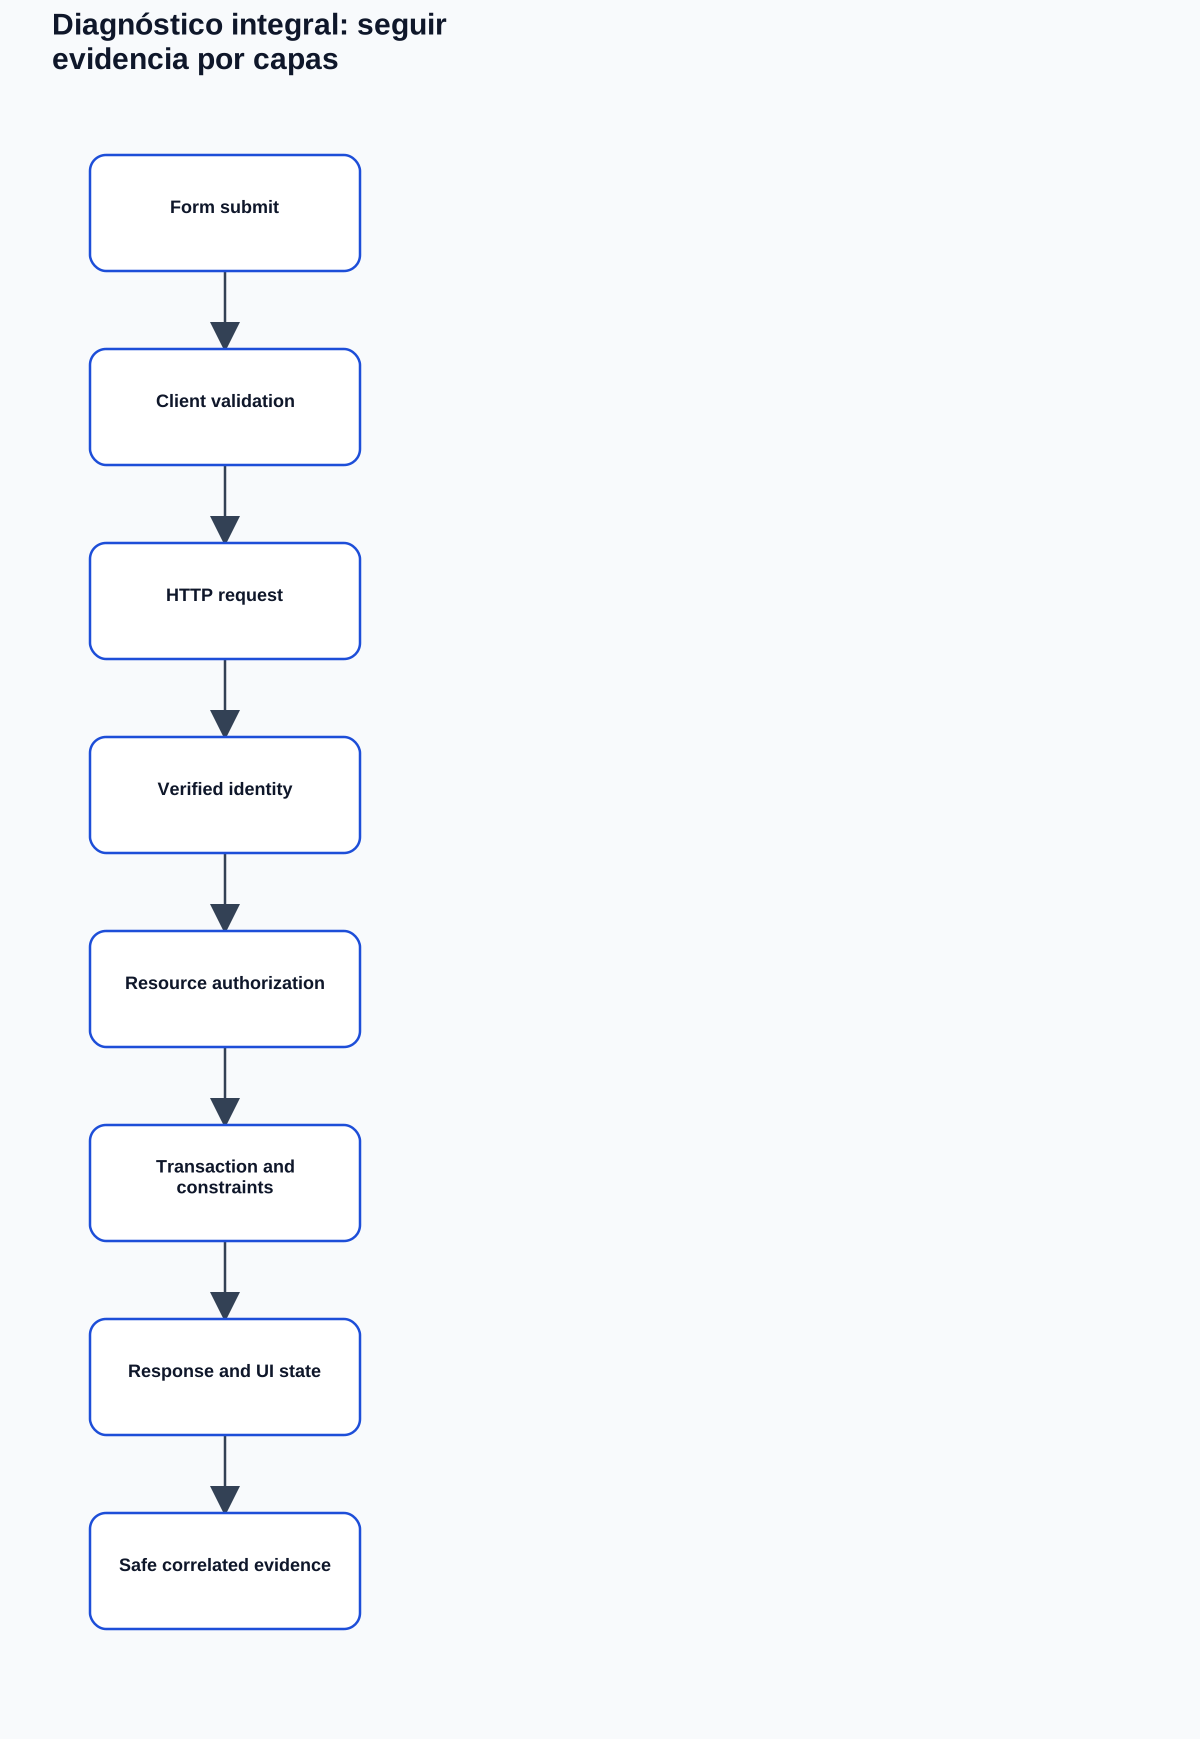
Cronología forense: El encadenamiento de 4 fallos en el escenario integral#
Examinemos la autopsia técnica de un incidente común reportado en producción: "Dos usuarios reportan que editaron notas concurrentemente; la pantalla regresó a un borrador antiguo, en la base de datos se perdió el texto de uno de ellos, y el registro de auditoría legal desapareció".
Tiempo  Cliente 1 (Alicia)          Cliente 2 (Bob)            Backend Rust / PostgreSQL           Servicio Remoto Audit
------------------------------------------------------------------------------------------------------------------------
t0      Abre nota 52 (v1)           Abre nota 52 (v1)
t1      Escribe "Draft A" (Req A)                              Recibe Req A (lenta por red)
t2                                  Escribe "Draft B" (Req B)  Recibe Req B (rápida)
t3                                                             Persiste "Draft B" (v2 en DB)
t4                                  Recibe 200 (UI="Draft B")
t5                                                             Persiste "Draft A" (¡Sobrescribe v2!)
t6      Recibe 200 (UI="Draft A")                              Intenta HTTP POST Audit ------------> [TIMEOUT DE RED]
t7      UI de Alicia sobreescrita   UI de Bob sobreescrita     Transacción DB confirmada,            Auditoría perdida
                                                               pero audit falló silenciosamente
Analicemos la causa raíz en cada una de las 4 fronteras involucradas:
1. Capa Cliente / Frontend: Respuestas fuera de orden (Out-of-Order Race)#
- Mecanismo: El navegador emite peticiones asíncronas independientes utilizando
fetch(). La duración de una petición en red no es determinista ni garantiza orden FIFO (First-In, First-Out). - El defecto: El manejador de la promesa en React actualiza ciegamente el estado local cuando la promesa se resuelve. Como la petición A tardó más que la B, la respuesta de A llega al final y sobrescribe en pantalla el contenido de B, retrocediendo la interfaz a un estado obsoleto (state regression).
- La solución: Asignar un número de secuencia monotónico a cada petición emitida. Al recibir la respuesta, descartarla si su número de secuencia es menor que el último procesado, o utilizar un
AbortControllerpara abortar formalmente la petición A en el instante en que el usuario dispara la mutación B.
2. Capa Backend / Persistencia: Actualización Perdida (Lost Update)#
- Mecanismo: Tanto Alicia como Bob leyeron la nota en la versión 1. Bob escribió su cambio elevando la versión conceptual a 2. Alicia, ignorando que Bob ya había modificado la fila, ejecutó un
UPDATEciego:
UPDATE notes SET title = 'Draft A' WHERE id = 52;- El defecto: El motor SQL ejecutó la instrucción sin errores porque la fila 52 existe. El trabajo de Bob quedó destruido silenciosamente en la base de datos.
- La solución: Control de Concurrencia Optimista (OCC). Exigir que la mutación valide atómicamente la versión que el cliente tenía en memoria antes de editar:
  UPDATE notes
  SET title = $1, version = version + 1
  WHERE id = $2 AND version = $3;
Cuando Alicia envía su petición con version = 1, la base de datos detecta que la versión actual en disco ya es 2. La consulta afecta exactamente 0 filas. El backend detecta esto y devuelve de inmediato HTTP 409 Conflict, obligando a la interfaz de Alicia a recargar los cambios de Bob y resolver el conflicto.
3. Capa Integración: El dilema de la doble escritura y la auditoría perdida#
- Mecanismo: El servicio de notas necesita persistir el cambio en PostgreSQL y notificar a un microservicio de auditoría externo para cumplir con normativas regulatorias.
- El defecto: El desarrollador ejecutó la transacción SQL y, tras cerrarla con éxito, lanzó una llamada HTTP al servicio de auditoría:
  // DUAL-WRITE ANTI-PATTERN
  db_tx.commit().await?;
audit_client.send_event(&event).await?; // <-- Si esto falla por timeout, ¡la DB ya cambió y el audit se perdió!- La solución: El patrón Transactional Outbox. La notificación no se envía directamente por red durante el procesamiento de la petición del usuario. En su lugar, el evento se inserta en una tabla
outboxen la misma transacción de PostgreSQL que muta la nota:
  BEGIN;
  UPDATE notes SET title = $1, version = version + 1 WHERE id = $2 AND version = $3;
  INSERT INTO outbox (aggregate_id, event_type, payload, status)
  VALUES ($2, 'NoteUpdated', $4, 'PENDING');
  COMMIT;
Un worker en segundo plano extrae los registros PENDING, los despacha al servicio de auditoría y los marca como DISPATCHED. Si la red falla, el evento permanece seguro en PostgreSQL para reintentarse automáticamente.
4. Capa de Red: Ambigüedad de timeout y reintentos ciegos#
- Mecanismo: Un cliente envía una solicitud para crear un recurso. El servidor la procesa con éxito y hace commit, pero el paquete TCP de respuesta
HTTP 201 Createdse pierde por un corte de enlace. - El defecto: El cliente recibe un error de timeout. El usuario o un interceptor de reintentos automático reenvía la petición completa. El servidor la recibe como una nueva solicitud y crea una segunda nota duplicada en la base de datos.
- La solución: Uso de la cabecera
Idempotency-Key: <UUID>generada en el cliente antes del primer intento. El servidor valida la clave: si ya fue procesada, retorna la respuesta almacenada previamente sin reejecutar la inserción.
Ejemplo razonado de arquitectura integral y OCC en Rust#
A continuación se presenta un modelo conceptual completo y verificable en Rust estándar (std-only) que simula la interacción atómica entre control de versiones optimista (OCC) y el patrón Transactional Outbox:
// Compilable and verified with rustc --test
use std::collections::HashMap;

#[derive(Debug, Clone, PartialEq, Eq)]
pub struct NoteRecord {
    pub id: u64,
    pub title: String,
    pub version: u64,
}

#[derive(Debug, Clone, PartialEq, Eq)]
pub enum OutboxStatus {
    Pending,
    Dispatched,
    Failed { attempts: u32 },
}

#[derive(Debug, Clone, PartialEq, Eq)]
pub struct OutboxRecord {
    pub id: u64,
    pub aggregate_id: u64,
    pub event_type: String,
    pub payload: String,
    pub status: OutboxStatus,
}

#[derive(Debug, Clone, PartialEq, Eq)]
pub enum ConcurrencyError {
    NotFound,
    OptimisticLockConflict { expected_version: u64, actual_version: u64 },
}

pub struct FullStackStore {
    notes: HashMap<u64, NoteRecord>,
    outbox: Vec<OutboxRecord>,
    next_outbox_id: u64,
}

impl FullStackStore {
    pub fn new() -> Self {
        Self {
            notes: HashMap::new(),
            outbox: Vec::new(),
            next_outbox_id: 1,
        }
    }

    pub fn seed_note(&mut self, id: u64, title: &str) {
        self.notes.insert(
            id,
            NoteRecord {
                id,
                title: title.to_string(),
                version: 1,
            },
        );
    }

    pub fn get_note(&self, id: u64) -> Option<&NoteRecord> {
        self.notes.get(&id)
    }

    /// Simulates atomic execution of:
    /// BEGIN;
    /// UPDATE notes SET title = $1, version = version + 1 WHERE id = $2 AND version = $3;
    /// INSERT INTO outbox (aggregate_id, event_type, payload, status) VALUES ($2, 'NoteUpdated', $4, 'PENDING');
    /// COMMIT;
    pub fn update_note_occ(
        &mut self,
        id: u64,
        expected_version: u64,
        new_title: &str,
    ) -> Result<u64, ConcurrencyError> {
        let note = self.notes.get_mut(&id).ok_or(ConcurrencyError::NotFound)?;

        // Optimistic concurrency check: if current version != client version, abort!
        if note.version != expected_version {
            return Err(ConcurrencyError::OptimisticLockConflict {
                expected_version,
                actual_version: note.version,
            });
        }

        // Apply mutation and increment version
        note.title = new_title.to_string();
        note.version += 1;
        let new_version = note.version;

        // Transactional Outbox: insert event in the exact same atomic transaction boundary
        let outbox_id = self.next_outbox_id;
        self.next_outbox_id += 1;
        self.outbox.push(OutboxRecord {
            id: outbox_id,
            aggregate_id: id,
            event_type: "NoteUpdated".to_string(),
            payload: format!("{{\"title\":\"{}\",\"version\":{}}}", new_title, new_version),
            status: OutboxStatus::Pending,
        });

        Ok(new_version)
    }

    pub fn pending_outbox_events(&self) -> Vec<&OutboxRecord> {
        self.outbox
            .iter()
            .filter(|r| matches!(r.status, OutboxStatus::Pending))
            .collect()
    }

    pub fn process_outbox_worker(&mut self, simulate_remote_success: bool) {
        for record in self.outbox.iter_mut() {
            if matches!(record.status, OutboxStatus::Pending) {
                if simulate_remote_success {
                    record.status = OutboxStatus::Dispatched;
                } else {
                    record.status = OutboxStatus::Failed { attempts: 1 };
                }
            }
        }
    }
}
Práctica independiente#
Escenario de diagnóstico completo#
Un cliente web lanza dos actualizaciones consecutivas sobre la nota 52:
- Petición A: Envía
"Draft A"basado en la versión1. - Petición B: Envía
"Draft B"basado en la versión1. - Debido a variaciones de enrutamiento en la red, la Petición B llega primero al servidor y se procesa. La Petición A llega milisegundos más tarde. Además, el servicio de auditoría externo experimenta un corte de red durante la operación.
Matriz de diagnóstico de 4 cuadrantes#
| Dimensión | Registro del Ingeniero |
|---|---|
| 1. Hecho observable irrefutable | La respuesta HTTP de B retornó 200 OK a las 14:00:01 con version: 2. La respuesta de A retornó posteriormente. La interfaz gráfica mostró "Draft A" durante unos segundos antes de parpadear. En la tabla de auditoría remota no figura ningún evento de guardado. |
| 2. Hipótesis causal falsable | El backend no utilizó OCC y permitió que A sobrescribiera la versión 2 con versión 1 (Lost Update), y la llamada de auditoría se ejecutó fuera de una transacción atómica perdiéndose ante el fallo de red. |
| *3. Prueba de refutación (Falsifier)* | Si al inspeccionar la fila id=52 en PostgreSQL la columna version es 2 y el título es "Draft B", y la consulta de A devolvió HTTP 409 Conflict, la hipótesis de Lost Update queda refutada. |
| 4. Cambio mínimo verificable | Incorporar WHERE id = $1 AND version = $2 en el UPDATE, encolar auditoría en la tabla outbox en la misma transacción, y en el cliente asociar el renderizado al número de secuencia de solicitud. |
Disciplina TDD: RED arrow GREEN arrow REFACTOR#
- Fase RED: Escribe una prueba donde dos clientes intenten actualizar concurrentemente partiendo de la versión 1. En una implementación ingenua sin OCC, ambas operaciones retornan éxito y la segunda sobrescribe a la primera. Comprueba que el arnés de pruebas capture el fallo de conflicto.
- Fase GREEN: Aplica la verificación de versión en
update_note_occ. Verifica que la Petición B sea aceptada (version = 2) y la Petición A sea rechazada conErr(OptimisticLockConflict). Comprueba que el evento de auditoría quede registrado con estadoPending. - Fase REFACTOR: Simula un fallo de red en el worker de auditoría. Comprueba que el evento en el Outbox permanezca intacto con estado
Failed { attempts: 1 }, listo para reintento automático, demostrando desacoplamiento resiliente.
Arnés de pruebas automatizado verificable (rustc --test)#
#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn concurrent_updates_prevent_lost_update_via_occ() {
        let mut store = FullStackStore::new();
        store.seed_note(52, "Initial Title");

        let base_version = 1;

        // Client 2 (Request B) succeeds first
        let v2 = store.update_note_occ(52, base_version, "Draft B").unwrap();
        assert_eq!(v2, 2);

        // Client 1 (Request A) arrives late, still presenting version 1
        let conflict_result = store.update_note_occ(52, base_version, "Draft A");
        assert_eq!(
            conflict_result,
            Err(ConcurrencyError::OptimisticLockConflict {
                expected_version: 1,
                actual_version: 2
            })
        );

        // Verify that Draft B was preserved in storage!
        let note = store.get_note(52).unwrap();
        assert_eq!(note.title, "Draft B");
        assert_eq!(note.version, 2);

        // Exactly 1 audit record generated for Draft B
        assert_eq!(store.outbox.len(), 1);
        assert_eq!(store.outbox[0].status, OutboxStatus::Pending);
    }

    #[test]
    fn outbox_worker_retains_events_on_downstream_failure() {
        let mut store = FullStackStore::new();
        store.seed_note(52, "Initial Title");
        store.update_note_occ(52, 1, "Draft B").unwrap();

        assert_eq!(store.pending_outbox_events().len(), 1);

        // Simulate remote audit service experiencing a network timeout
        store.process_outbox_worker(false);

        // Event was NOT lost; it remains safely in storage marked as failed for retry
        assert_eq!(store.outbox[0].status, OutboxStatus::Failed { attempts: 1 });
        assert_eq!(store.outbox[0].payload.contains("Draft B"), true);
    }
}
Code smell: Colapso de errores heterogéneos en el cliente (Catch-All Blanking)#
El síntoma en el código#
// DELIBERATELY HARMFUL FRONTEND CODE SMELL
async function saveNote(noteId: string, title: string) {
  try {
    await fetch(`/api/notes/${noteId}`, {
      method: 'PATCH',
      body: JSON.stringify({ title }),
    });
    showToast("Note saved!");
  } catch (error) {
    // ANTI-PATTERN: Catching all errors, wiping user work and showing a vague message!
    showToast("Failed to save note");
    resetFormToEmpty(); // Destroys all user typing!
  }
}
Diagnóstico de ingeniería#
- Evidencia empírica: El usuario escribe un borrador largo de 500 palabras; ocurre un parpadeo de red de 100 ms o el backend devuelve
409 Conflict, y el formulario se borra por completo, destruyendo el texto ingresado. - Hipótesis del fallo: El autor del frontend asumió erróneamente que cualquier excepción o código de error representa el mismo fenómeno ("el guardado falló, volvamos al estado inicial").
- Consecuencia destructiva: Destrucción irreversible del trabajo del usuario en memoria y generación de frustración crítica.
- Corrección arquitectónica mínima:
- Conservar siempre los datos ingresados: Jamás borrar el formulario ante un fallo.
- Discriminar semánticamente:
- Si la respuesta es
422 Unprocessable Entity: Resaltar los campos inválidos en la interfaz. - Si la respuesta es403 Forbidden: Informar que la sesión ha expirado o que no posee permisos sobre esa nota. - Si la respuesta es409 Conflict: Mostrar un diálogo de resolución de conflictos permitiendo al usuario comparar su borrador con los cambios recién guardados por el otro colaborador. - Si la excepción es de red (Timeout/Failed to fetch): Presentar un estado de reintento offline conservando el borrador intacto.
Preguntas de comprensión profunda y diagnóstico socrático#
Pregunta 1: La carrera asíncrona de respuestas fuera de orden en el cliente#
- Escenario: En una aplicación de notas, el usuario escribe en un campo con autoguardado rápido. Se disparan dos peticiones
PATCH: Petición Aa las 10:00:00.000 enviando"Título Corto".Petición Ba las 10:00:00.300 enviando"Título Largo y Completo".- La respuesta de B retorna
200 OKa las 10:00:00.500. La respuesta de A experimenta congestión de red y retorna200 OKa las 10:00:00.900. - Inciso A: Si el código en React hace
fetch(...).then(res => setLocalTitle(res.data.title)), ¿qué título queda finalmente renderizado en la pantalla a las 10:00:01? Explica el concepto de regresión de estado. - Inciso B: Si utilizas
AbortControllerpara abortar la Petición A en el instante en que se dispara la Petición B, ¿garantiza esto que la Petición A no haya mutado la base de datos en el servidor? Explica la diferencia entre cancelar una promesa en el cliente y revertir una transacción en el backend. - Guía de razonamiento: Modela el desacoplamiento físico entre el hilo de eventos de JavaScript y el socket TCP del servidor.
Pregunta 2: Control de concurrencia optimista y código de conflicto HTTP#
- Escenario: Dos operadores en un centro de soporte abren simultáneamente el ticket de un cliente (ambos leen
version: 4). El Operador 1 cambia el estado a"En Proceso"y guarda a las 11:00:01. El Operador 2 cambia el estado a"Cancelado por Cliente"y guarda a las 11:00:02. - Inciso A: Si la base de datos ejecuta
UPDATE tickets SET status = $1, version = version + 1 WHERE id = $2 AND version = $3, ¿qué valor devuelve la base de datos para la cantidad de filas afectadas (rows_affected) en la petición del Operador 2? - Inciso B: ¿Qué código de estado HTTP (
HTTP Status Code) y qué cuerpo de error debe retornar el backend al Operador 2? ¿Qué debe hacer la interfaz de usuario del Operador 2 en lugar de simplemente sobrescribir el ticket? - Guía de razonamiento: Analiza la semántica formal de
HTTP 409 Conflict(RFC 7231) y la necesidad de conciliación interactiva entre dos usuarios humanos concurrentes.
Pregunta 3: El patrón Transactional Outbox frente al problema de la doble escritura#
- Escenario: Un sistema financiero debe: (1) debitar $100 dólares de la cuenta de un usuario en PostgreSQL, y (2) publicar un mensaje en un broker Kafka externo para que el servicio de prevención de fraude audite el movimiento.
- Inciso A: Describe el escenario de fallo donde debitar la cuenta y luego llamar a Kafka deja al sistema en un estado de inconsistencia grave si el broker Kafka está caído.
- Inciso B: ¿Por qué no se puede simplemente colocar la llamada a la librería de Kafka dentro del bloque
BEGIN ... COMMITde PostgreSQL? - Inciso C: Explica paso a paso cómo el patrón Transactional Outbox resuelve este problema garantizando que el débito y el evento queden indisolublemente ligados bajo las propiedades ACID de la base de datos.
- Guía de razonamiento: Reconoce la frontera transaccional. Comprende por qué las llamadas de red externas no pueden participar en transacciones relacionales locales sin protocolos pesados de consenso distribuido.
Pregunta 4: La ambigüedad del timeout de red y el Problema de los Dos Generales#
- Escenario: Una aplicación móvil de comercio electrónico envía un
POST /api/orderspara procesar una compra de $500 dólares. A los 10 segundos, la conexión celular se interrumpe y la aplicación captura un error de timeout de red. - Inciso A: Basándote en el Problema de los Dos Generales, explica los tres estados físicos posibles en los que puede encontrarse el servidor de compras en este instante.
- Inciso B: Si la aplicación móvil implementa un botón "Reintentar pago" que simplemente vuelve a invocar
POST /api/orderscon un cuerpo nuevo sin cabeceras especiales, ¿qué catástrofe financiera puede ocurrir? ¿Cómo la cabeceraIdempotency-Keypreviene este escenario? - Guía de razonamiento: Recuerda que un timeout solo demuestra que el cliente dejó de esperar la respuesta; no demuestra que el servidor haya abortado o no haya completado la transacción.
Pregunta 5: La disciplina de la falsabilidad en el diagnóstico forense#
- Escenario: Durante un incidente crítico donde el sistema de autenticación rechaza aleatoriamente al 5% de los usuarios, un desarrollador en la sala de crisis afirma: "El framework web tiene un bug interno en el manejo de memoria que causa pérdidas de paquetes".
- Inciso A: ¿Por qué culpar al framework o al compilador sin presentar un caso de reproducción mínimo ni telemetría contradice el principio de falsabilidad científica?
- Inciso B: Formula una hipótesis estructurada y falsable en 4 cuadrantes (Hecho observado, Hipótesis causal, Prueba refutadora, Evidencia decisiva) para investigar este mismo incidente enfocándote en la saturación del pool de conexiones de la base de datos.
- Guía de razonamiento: Aplica el método científico de depuración: aislar variables, formular predicciones medibles y buscar activamente evidencia que desmienta la explicación preliminar.
Criterio de salida#
Puedes considerar superada esta lección y el módulo cuando:
- Eres capaz de descomponer un incidente de producción complejo en una matriz de hechos empíricos, hipótesis falsables y pruebas refutadoras.
- Implementas mecanismos en cliente y servidor para evitar regresiones de estado causadas por respuestas fuera de orden.
- Diseñas e implementas consultas atómicas con Control de Concurrencia Optimista (OCC) en PostgreSQL, manejando adecuadamente el código
HTTP 409 Conflict. - Explicas el problema de la doble escritura y modelas el patrón Transactional Outbox para garantizar consistencia atómica entre bases de datos y servicios remotos.
- Defiendes la arquitectura frente a la ambigüedad de los timeouts de red mediante mutaciones idempotentes con
Idempotency-Key. - Todas las pruebas de concurrencia y Outbox compilan y pasan en verde con
rustc --test.
Lecturas oficiales#
- PostgreSQL Transaction Isolation: anomalías de concurrencia, lectura repetible y serializabilidad.
- RFC 7231 - HTTP/1.1 Semantics and Content (Section 6.5.8: 409 Conflict): definición normativa del código de estado 409.
- Microservices.io - Pattern: Transactional Outbox: arquitectura de eventos atómicos y entrega asíncrona confiable.
- IETF Draft - The Idempotency-Key HTTP Header Field: especificación estándar para mutaciones idempotentes en la web.
Siguiente paso#
¡Felicidades por completar las lecciones del curso! Revisa la guía de respuestas de operaciones para contrastar tus modelos de diagnóstico y verificar el solucionario completo. Puedes regresar al mapa general en la ruta del curso o consultar el glosario técnico.