Sesión 03: Cracking the Coding Interview (Capítulo 1, Parte 1) — Memoria, Arrays y Strings en Rust y Python#
Navegación rápida:
- ← Sesión 02: Big O y Análisis Espacial
- Sesión 04: Hash Maps y Tablas de Frecuencia →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 50-65 minutos.
- Código fuente compilado y probado:
practica-rust/dia_03.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Antes de manipular bytes y caracteres, comprendamos cómo se almacenan físicamente en el silicio de la memoria RAM. Consulta el Glosario Maestro.
Arreglo Contiguo en Memoria (Contiguous Array)#
- (a) En palabras simples (intuición): Una hilera de casilleros postales idénticos pegados uno junto al otro en la pared. Si sabes dónde está el casillero 0 y cuánto mide cada casillero, puedes ir con los ojos cerrados directo al casillero 5 sin mirar los intermedios.
- (b) Definición técnica paso a paso: Estructura de datos fundamental que asigna un bloque de memoria física continuo y secuencial. El acceso a cualquier posición i toma tiempo constante O(1) mediante cálculo aritmético de desplazamiento de dirección:
- (c) Cómo funciona en Rust (memoria y tipos): Los arreglos de tamaño fijo
[T; N]se alojan íntegramente en el Stack. Los vectoresVec<T>reservan el búfer contiguo en el Heap, manteniendo un descriptor de 24 bytes en el Stack (ptr: *mut T,cap: usize,len: usize). - (d) Error típico de Junior: Creer que una lista enlazada o un diccionario tienen el mismo costo de acceso a memoria que un arreglo contiguo, ignorando la penalización por fallos de caché (cache misses).
Slice en Rust (&[T] y &str)#
- (a) En palabras simples (intuición): Una ventana o visor de cartón que colocas sobre una parte de un libro abierto. No eres dueño del libro ni fotocopias sus páginas; solo estás mirando una sección específica sin alterar nada.
- (b) Definición técnica paso a paso: Vista o referencia no propietaria a una secuencia contigua de elementos en memoria. Es un fat pointer compuesto de dos campos de 64 bits en el Stack (16 bytes en total): un puntero de inicio (
*const T) y la cantidad de elementos (len: usize). - (c) Cómo funciona en Rust (memoria y tipos): Los slices no poseen los datos, por lo que nunca los liberan al destruirse. El borrow checker de Rust asegura estáticamente que la memoria a la que apunta el slice no pueda ser mutada ni destruida mientras el slice esté vivo, erradicando los dangling pointers.
- (d) Error típico de Junior: Intentar devolver un slice apuntando a una variable local creada dentro de la misma función, lo cual es rechazado por el compilador porque el valor se destruye al salir de la función.
String vs &str en Rust#
- (a) En palabras simples (intuición):
Stringes una libreta comprada por ti que puedes rayar, alargar y borrar (dueño de la memoria).&stres una etiqueta adhesiva con una cita de solo lectura que alguien te permite ver. - (b) Definición técnica paso a paso:
Stringes una estructura propietaria de tamaño dinámico mutable que vive en el Stack (24 bytes) y posee un búfer de bytes UTF-8 en el Heap.&stres una referencia prestada inmutable de 16 bytes a una secuencia válida de bytes UTF-8 (puede apuntar al Heap, al Stack o al segmento.rodatade constantes del binario). - (c) Cómo funciona en Rust (memoria y tipos): Toda cadena en Rust está garantizada por el compilador de contener UTF-8 estricto. Por ello, en Rust no se puede indexar una cadena con enteros directos (
s[i]), porque los caracteres UTF-8 pueden ocupar entre 1 y 4 bytes cada uno; indexar un byte a ciegas podría partir un glifo a la mitad y corromper la memoria. - (d) Error típico de Junior: Concatenar cadenas dentro de un bucle usando
s += &otraos = s + "a", lo cual copia todo el string en cada iteración y degrada un algoritmo lineal a un rendimiento cuadrático desastroso O(N²).
Vector de Bits / Máscara de Bits (Bit Vector / Bitmask)#
- (a) En palabras simples (intuición): Un tablero con 128 pequeños interruptores de luz. Cada vez que ves un carácter, enciendes el interruptor correspondiente a su número. Si el interruptor ya estaba encendido, sabes que encontraste un duplicado.
- (b) Definición técnica paso a paso: Uso de los bits individuales de uno o más enteros primitivos para almacenar valores booleanos de forma ultra-compacta. Un entero
u128almacena 128 banderas booleanas ocupando apenas 16 bytes de memoria en el Stack. - (c) Cómo funciona en Rust (memoria y tipos): Encender el bit k:
checker |= (1u128 << k). Comprobar si el bit k está encendido:(checker & (1u128 << k)) != 0. Ambas instrucciones se ejecutan en 1 solo ciclo de reloj de la ALU de la CPU. - (d) Error típico de Junior: Intentar desplazar más bits de los que tiene el tipo (por ejemplo, hacer
1u32 << 65), lo que produce desbordamiento de desplazamiento (shift overflow).
Principio del Palomar (Pigeonhole Principle)#
- (a) En palabras simples (intuición): Si tienes 10 palomas y solo 9 jaulas, al menos una jaula tendrá obligatoriamente 2 o más palomas.
- (b) Definición técnica paso a paso: Teorema combinatorio: Si n elementos se distribuyen en m contenedores y n > m, existe al menos un contenedor que almacena ≥ 2 elementos.
- (c) Cómo funciona en Rust (memoria y tipos): En problemas de unicidad de caracteres (CTCI 1.1), si la cadena de entrada tiene más de 128 caracteres ASCII (
s.len() > 128), podemos retornarfalsede inmediato en O(1) sin examinar la cadena. - (d) Error típico de Junior: Olvidar esta comprobación inicial al inicio de la función en entrevistas técnicas, perdiendo la oportunidad de responder en O(1) para entradas gigantes.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Matemática de la Memoria Contigua y el Acceso O(1)#
¿Por qué leer arr[i] cuesta exactamente lo mismo si el arreglo tiene 5 elementos o 500,000,000 de elementos? La memoria física RAM es un circuito electrónico matricial direccionable. Cuando el procesador ejecuta arr[i]:
- Toma la dirección base del puntero (almacenada en un registro de 64 bits de la CPU).
- Multiplica el índice i por el tamaño del elemento en bytes (
size_of::<T>()). - Suma ambos valores en la Unidad Aritmético Lógica (ALU) en un solo ciclo de reloj.
- Envía la dirección resultante al bus de memoria.
Dado que la operación matemática toma 1 solo paso independientemente de la longitud total del arreglo, el acceso aleatorio es formalmente O(1).
La Catástrofe Cuadrática de la Concatenación Ingenua de Cadenas#
Analicemos qué ocurre en la memoria cuando alguien escribe en Python o Rust:
// Código ingenuo ineficiente O(N^2):
let mut s = String::new();
for word in words {
    s = s + word; // Reasigna y copia todo en cada iteración
}
En la iteración 1: Copia longitud L₁. En la iteración 2: Copia longitud L₁ + L₂. En la iteración 3: Copia longitud L₁ + L₂ + L₃. En la iteración N: Copia longitud sum_{j=1}^{N} Lⱼ. Si cada palabra tiene longitud promedio k:
¡Un bucle de N palabras tarda tiempo cuadrático O(N²) en lugar de lineal!
La solución canónica: Calcular de antemano el tamaño total de bytes requeridos y reservar la capacidad exacta una sola vez con String::with_capacity(total_bytes). De esta forma, cada inserción toma O(k) y el tiempo total es estrictamente lineal O(N).
3. Visualización Paso a Paso y Gráfica de Memoria en Rust#
Disposición de Memoria en Rust: String vs &str#
Consulta el diagrama de arquitectura vectorial y su código fuente:
- Gráfico SVG:
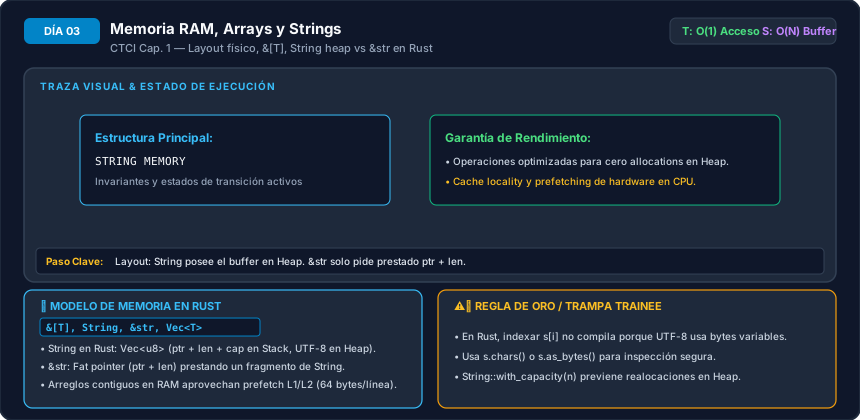 - Enlace al código fuente Mermaid: Fuente Mermaid
flowchart TD
    subgraph Stack["Stack (Memoria Local de Hilo)"]
        STR["String (24 Bytes)<br/>ptr: 0x5555_2000<br/>len: 4<br/>cap: 8"]
        SLI["&str Slice (16 Bytes)<br/>ptr: 0x5555_2000<br/>len: 4"]
    end
    subgraph Heap["Heap (Bloque Contiguo UTF-8)"]
        BUF["0x5555_2000: ['H', 'o', 'l', 'a', _, _, _, _]"]
    end
    STR -.->|Posee y libera con Drop| BUF
    SLI -.->|Referencia de solo lectura| BUF
Visualización Cuadro por Cuadro de Memoria: URLify In-Place (CTCI 1.3)#
Entrada: chars = ['M', 'r', ' ', 'J', 'o', 'h', 'n', ' ', ' ', ' ', ' '], true_length = 7. Cantidad de espacios: 1 (' '). Longitud final: 7 + 1 × 2 = 9.
ESTADO INICIAL:
Índices:     0    1    2    3    4    5    6    7    8
Valores:   ['M', 'r', ' ', 'J', 'o', 'h', 'n',  _,   _ ]
                        ^                  ^         ^
                        |                  |         |
                  (espacio)             old_idx   new_len

PASO 1: chars[6] es 'n' (distinto de espacio).
        Copiar chars[6] a chars[8]. Decrementar punteros.
Índices:     0    1    2    3    4    5    6    7    8
Valores:   ['M', 'r', ' ', 'J', 'o', 'h', 'n',  _,  'n']

PASO 2: chars[5] es 'h'. Copiar a chars[7].
Índices:     0    1    2    3    4    5    6    7    8
Valores:   ['M', 'r', ' ', 'J', 'o', 'h', 'n', 'h', 'n']

PASO 3: chars[4] es 'o'. Copiar a chars[6].
Valores:   ['M', 'r', ' ', 'J', 'o', 'h', 'o', 'h', 'n']

PASO 4: chars[3] es 'J'. Copiar a chars[5].
Valores:   ['M', 'r', ' ', 'J', 'o', 'J', 'o', 'h', 'n']

PASO 5: chars[2] es ' ' (¡Espacio detectado!).
        Escribir '0', '2', '%' hacia atrás en posiciones 4, 3, 2.
Valores:   ['M', 'r', '%', '2', '0', 'J', 'o', 'h', 'n']

PASOS RESTANTES: Copiar 'r' y 'M' a sus mismas posiciones.
Resultado final: "Mr%20John" sin requerir memoria extra O(1) espacio.
4. Implementación Canónica en Rust + Comparativa con Python#
Implementación en Rust (practica-rust/dia_03.rs)#
//! Implementación canónica de algoritmos sobre arrays y strings en Rust.
//! Compilable y verificable con `rustc --test`.

use std::collections::HashSet;

/// CTCI 1.1: Comprueba unicidad de caracteres mediante HashSet.
pub fn is_unique_set(s: &str) -> bool {
    let mut seen = HashSet::new();
    for c in s.chars() {
        if !seen.insert(c) {
            return false;
        }
    }
    true
}

/// CTCI 1.1: Comprueba unicidad en O(1) espacio auxiliar con u128 Bitmask para ASCII.
pub fn is_unique_bit_vector(s: &str) -> bool {
    if s.len() > 128 {
        return false; // Principio del Palomar
    }

    let mut checker: u128 = 0;
    for b in s.bytes() {
        if b >= 128 {
            return is_unique_set(s);
        }
        let bit = 1u128 << b;
        if (checker & bit) != 0 {
            return false;
        }
        checker |= bit;
    }
    true
}

/// CTCI 1.1: Comprobación estricta sin ninguna estructura de datos adicional O(N^2).
pub fn is_unique_no_extra_ds(s: &str) -> bool {
    let chars: Vec<char> = s.chars().collect();
    let n = chars.len();
    for i in 0..n {
        for j in (i + 1)..n {
            if chars[i] == chars[j] {
                return false;
            }
        }
    }
    true
}

/// CTCI 1.3: URLify in-place trabajando de derecha a izquierda sobre un slice mutable.
pub fn urlify(chars: &mut [char], true_length: usize) {
    let mut space_count = 0;
    for i in 0..true_length {
        if chars[i] == ' ' {
            space_count += 1;
        }
    }

    if space_count == 0 {
        return;
    }

    let mut new_len = true_length + space_count * 2;
    let mut old_idx = true_length;

    while old_idx > 0 {
        old_idx -= 1;
        new_len -= 1;

        if chars[old_idx] == ' ' {
            chars[new_len] = '0';
            new_len -= 1;
            chars[new_len] = '2';
            new_len -= 1;
            chars[new_len] = '%';
        } else {
            chars[new_len] = chars[old_idx];
        }
    }
}

/// Inversión in-place con dos punteros convergentes.
pub fn reverse_slice<T>(slice: &mut [T]) {
    if slice.is_empty() {
        return;
    }
    let mut left = 0;
    let mut right = slice.len() - 1;

    while left < right {
        slice.swap(left, right);
        left += 1;
        right = right.saturating_sub(1);
    }
}

/// Concatenación eficiente con preasignación exacta de capacidad en Heap.
pub fn join_strings_efficient(words: &[&str], delimiter: &str) -> String {
    if words.is_empty() {
        return String::new();
    }

    let total_chars: usize = words.iter().map(|w| w.len()).sum::<usize>()
        + delimiter.len() * (words.len() - 1);

    let mut result = String::with_capacity(total_chars);
    for (i, word) in words.iter().enumerate() {
        if i > 0 {
            result.push_str(delimiter);
        }
        result.push_str(word);
    }
    result
}

#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn test_is_unique() {
        assert!(is_unique_set("rust"));
        assert!(!is_unique_set("banana"));
        assert!(is_unique_bit_vector("rust"));
        assert!(!is_unique_bit_vector("banana"));
        assert!(is_unique_no_extra_ds("rust"));
        assert!(!is_unique_no_extra_ds("banana"));
    }

    #[test]
    fn test_urlify() {
        let mut buffer = ['M', 'r', ' ', 'J', 'o', 'h', 'n', ' ', 'S', 'm', 'i', 't', 'h', ' ', ' ', ' ', ' '];
        urlify(&mut buffer, 13);
        let expected = ['M', 'r', '%', '2', '0', 'J', 'o', 'h', 'n', '%', '2', '0', 'S', 'm', 'i', 't', 'h'];
        assert_eq!(&buffer[..17], &expected[..]);
    }

    #[test]
    fn test_reverse_slice() {
        let mut arr = [1, 2, 3, 4, 5];
        reverse_slice(&mut arr);
        assert_eq!(arr, [5, 4, 3, 2, 1]);
    }

    #[test]
    fn test_join_strings_efficient() {
        let words = ["Rust", "Systems"];
        assert_eq!(join_strings_efficient(&words, " "), "Rust Systems");
    }
}
Implementación Canónica en Python (practica/dia_03_arrays_strings_basics.py)#
from typing import List

def is_unique_set(s: str) -> bool:
    if len(s) > 256:
        return False
    seen = set()
    for char in s:
        if char in seen:
            return False
        seen.add(char)
    return True

def urlify(chars: List[str], true_length: int) -> None:
    space_count = sum(1 for i in range(true_length) if chars[i] == ' ')
    new_length = true_length + space_count * 2

    old_idx = true_length - 1
    write_idx = new_length - 1

    while old_idx >= 0:
        if chars[old_idx] == ' ':
            chars[write_idx] = '0'
            chars[write_idx - 1] = '2'
            chars[write_idx - 2] = '%'
            write_idx -= 3
        else:
            chars[write_idx] = chars[old_idx]
            write_idx -= 1
        old_idx -= 1
5. Las 3 Trampas Clásicas en Entrevistas#
- La Asunción del Juego de Caracteres (Character Set): - Al resolver problemas de unicidad o anagramas, la primera pregunta obligatoria al entrevistador es: "¿La entrada es ASCII estándar (128), ASCII extendido (256) o Unicode UTF-8 completo?". La complejidad espacial y las optimizaciones con bit vectors dependen enteramente de esta respuesta.
- Sobreescritura de Izquierda a Derecha en Modificaciones In-Place:
- En URLify (CTCI 1.3), si intentas reemplazar
' 'por'%20'desde el índice 0 hacia adelante, pisarás y destruirás las letras subsiguientes que aún no has leído. El patrón canónico de dos punteros de derecha a izquierda resuelve este problema en O(1) espacio. - Indexación Directa de Strings:
- En Python o JavaScript,
s[i]retorna un carácter. En Rust,s[i]no compila. Rust te obliga a decidir explícitamente si deseas iterar sobre bytes (s.bytes()) o sobre puntos de código Unicode (s.chars()).
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: ¿Por qué en Rust &str no implementa el operador de indexación Index (es decir, no compila s[i]), a diferencia de C++, Python o JavaScript?
Respuesta Técnica Detallada: En Rust, todos los strings son secuencias estrictamente codificadas en UTF-8. En UTF-8, un carácter (punto de código Unicode) tiene una longitud variable de 1 a 4 bytes:
- Caracteres ASCII estándar ('a', '1'): 1 byte.
- Caracteres latinos acentuados ('á', 'ñ'): 2 bytes.
- Caracteres asiáticos o símbolos matemáticos ('日', '∑'): 3 bytes.
- Emojis ('🦀'): 4 bytes.
Si Rust permitiera s[i] devolviendo un byte en tiempo O(1), ese byte podría ser un byte intermedio (continuation byte) de un emoji, lo que no representaría un carácter válido. Si Rust implementara s[i] devolviendo el i-ésimo carácter Unicode (char), tendría que decodificar secuencialmente todos los bytes anteriores desde el inicio de la cadena, haciendo que una simple indexación cueste O(N) tiempo lineal en lugar de O(1) constante. Para evitar que los desarrolladores asuman erróneamente que indexar caracteres es una operación gratuita O(1), Rust prohíbe sintácticamente s[i], obligando a usar s.chars().nth(i) (O(N) explícito) o s.as_bytes()[i] (O(1) explícito sobre bytes crudos).
Pregunta 2: ¿Cómo se demuestra formalmente que la técnica de dos punteros de derecha a izquierda en URLify nunca sobreescribe datos que aún no han sido leídos?
Respuesta Técnica Detallada: Sean:
- k: El número de espacios en el texto real.
- Cada espacio expande el tamaño en 2 caracteres adicionales ('%', '2', '0' reemplaza 1 espacio, ganando 3 - 1 = 2 slots).
- new_len = true_length + 2k.
- En cualquier paso de la iteración hacia atrás, sea x el índice del carácter actual que se está leyendo (0 ≤ x < true_length).
- Sea spaces_left(x) la cantidad de espacios existentes en el subarreglo chars[0 ..= x].
- La posición de escritura correspondiente para el carácter en x es:
- Dado que spaces_left(x) ≥ 0, se deduce inmediatamente que:
La igualdad writeᵢdx == x se da únicamente cuando ya no queda ningún espacio por procesar (spaces_left(x) = 0). Como la posición de escritura siempre es estrictamente mayor o igual que el puntero de lectura, la escritura hacia atrás jamás puede adelantarse a la lectura, garantizando la integridad total de los datos originales sin búfer auxiliar.
Pregunta 3: ¿Cuál es la diferencia en consumo de memoria entre Vec y String en Rust para almacenar una cadena de texto en inglés?
Respuesta Técnica Detallada:
- En Rust, el tipo primitivo
charrepresenta un Scalar Value de Unicode de 4 bytes (32 bits) de tamaño fijo (u32). - Por lo tanto, un
Vec<char>que almacena una cadena en inglés de 1,000 caracteres ocupará en el Heap:
- En contraste, un
Stringalmacena bytes UTF-8 continuos (Vec<u8>). Para caracteres del alfabeto inglés (código ASCII ≤ 127), UTF-8 utiliza exactamente 1 byte por carácter. Por lo tanto, el mismo texto en unStringocupará:
Vec<char> desperdicia un 75% de la memoria y arruina la eficiencia de la línea de caché de la CPU para texto común. Por ello, en ingeniería de software de alto rendimiento se trabaja preferentemente con &str / String y no con vectores de char.
Pregunta 4: ¿Por qué el compilador de Rust no permite que dos partes de tu programa tengan una referencia mutable &mut [T] y una referencia inmutable &[T] al mismo arreglo simultáneamente (Aliasing XOR Mutability)?
Respuesta Técnica Detallada: Esta es la regla central del modelo de Ownership de Rust: o tienes cualquier número de lectores inmutables (&T), o tienes exactamente un único escritor mutable (&mut T), pero nunca ambos a la vez. Supongamos que existieran simultáneamente lector: &[i32] y escritor: &mut Vec<i32> apuntando al mismo vector.
lectorapunta al búfer actual en el Heap en la dirección0x5000.escritorejecutapush(42). El vector se llena y se reubica en una nueva dirección en el Heap0x9000, liberando el bloque antiguo0x5000.lectorintenta acceder alector[0], leyendo memoria que ya fue liberada por el sistema operativo (Use-After-Free).
El borrow checker previene este error en tiempo de compilación sin costo en tiempo de ejecución, haciendo que los algoritmos concurrentes y de bajo nivel en Rust sean intrínsecamente seguros contra corrupción de memoria y condiciones de carrera.
Pregunta 5: En el problema de verificar si una cadena tiene caracteres únicos (CTCI 1.1), ¿cuáles son los compromisos (trade-offs) entre el enfoque con Bit Vector, el enfoque con HashSet y el enfoque in-place sin estructuras adicionales?
Respuesta Técnica Detallada:
| Criterio | Bit Vector (u128) | HashSet (HashSet<char>) | Sin Estructuras (O(N²)) | Ordenamiento Previo (O(N log N)) |
|---|---|---|---|---|
| Tiempo de Ejecución | O(N) o O(1) por cota | O(N) promedio | O(N²) | O(N log N) |
| Espacio Auxiliar | O(1) (16 bytes en Stack) | O(min(N, c)) en Heap | O(1) absoluto | O(1) si in-place |
| Soporte de Caracteres | Limitado a ASCII (0..127) | Unicode completo | Cualquier tipo comparable | Cualquier tipo ordenable |
| Sobrecarga de Asignador | Cero (registros de CPU) | Múltiples asignaciones Heap | Cero | Cero (si in-place) |
| Modificación de Entrada | Solo lectura | Solo lectura | Solo lectura | Requiere mutar el arreglo |
En una entrevista, presentar esta matriz de decisión demuestra madurez de diseño de software e ingeniería de sistemas.
7. Puente a LeetCode y Práctica de Código#
- LeetCode 217 — Contains Duplicate (Easy):
- Implementa la versión con
HashSety con ordenamiento previo. - LeetCode 344 — Reverse String (Easy):
- Resuelve mediante intercambio in-place con dos punteros (
reverse_slice). - LeetCode 151 — Reverse Words in a String (Medium): - Aplica el patrón de inversión triple: invierte toda la cadena y luego invierte cada palabra individualmente in-place.
Navegación: