Sesión 01: Grokking Algorithms (Capítulo 1, Parte 1) — Búsqueda Binaria y Pensar en Logaritmos#
Navegación rápida:
- ← Inicio del Curso
- Sesión 02: Big O y Análisis Espacial →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 45-60 minutos.
- Código fuente compilado y probado:
practica-rust/dia_01.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Antes de escribir una sola línea de código, aclaramos cada término técnico desde sus bases físicas y matemáticas. Consulta el Glosario Maestro para más detalles.
Búsqueda Binaria (Binary Search)#
- (a) En palabras simples (intuición): Es la forma en que buscas un apellido en una guía telefónica de papel. No comienzas en la página 1 leyendo uno por uno. Abres el libro exactamente a la mitad; si ves la letra "M" y buscas "Vargas", sabes al instante que Vargas no puede estar antes de la "M", así que descartas 500 páginas de un solo golpe.
- (b) Definición técnica paso a paso: Algoritmo de divide y vencerás aplicable sobre secuencias ordenadas de acceso aleatorio (O(1)). Compara el valor objetivo con el elemento en la posición media (
mid). Si coinciden, termina con éxito. Si el objetivo es menor, restringe la búsqueda al subintervalo izquierdo [low, mid - 1] (o [low, mid) en rangos semiabiertos). Si es mayor, restringe la búsqueda a [mid + 1, high]. - (c) Cómo funciona en Rust (memoria y tipos): Trabaja típicamente sobre un slice borrowing
&[T]. Un slice en Rust está formado por un puntero al inicio del bloque de memoria (*const T) y una longitud (usize). Como los índices son de tipo no signadousize, decrementar por debajo de 0 causa un panic por subdesbordamiento en modo debug (attempt to subtract with overflow). - (d) Error típico de Junior: Intentar aplicar búsqueda binaria sobre arreglos desordenados, o sobre listas enlazadas donde el acceso a
midcuesta O(N), anulando la ventaja logarítmica.
Logaritmo en base 2 (log₂ N)#
- (a) En palabras simples (intuición): Es la cantidad de veces que puedes doblar una hoja de papel a la mitad (o dividir una lista de números en dos partes iguales) hasta quedarte con una sola pieza.
- (b) Definición técnica paso a paso: La función inversa de la exponenciación binaria: log₂(N) = k ⟺ 2ᵏ = N. En complejidad computacional, representa cuántas divisiones sucesivas entre 2 son necesarias para reducir un problema de tamaño N a tamaño 1.
- (c) Cómo funciona en Rust (memoria y tipos): La cantidad de iteraciones define el número máximo de ciclos de instrucción en la CPU. Para un arreglo de 2³² elementos ($4$ mil millones), el bucle iterará como máximo 32 veces, lo que tarda menos de un microsegundo en un procesador moderno.
- (d) Error típico de Junior: Confundir O(log N) con O(N) o creer que O(log N) requiere el uso de librerías matemáticas (
f64::log2). En algoritmos enteros, el logaritmo emerge naturalmente del control de flujo con divisiones entre 2.
Invariante de Bucle (Loop Invariant)#
- (a) En palabras simples (intuición): Es una regla o contrato que se mantiene 100% verdadera antes de que comience el bucle, durante cada vuelta del bucle y justo cuando el bucle termina.
- (b) Definición técnica paso a paso: Propiedad lógica formal utilizada para demostrar la corrección de un algoritmo. En búsqueda binaria cerrada, el invariante es: "Si el elemento
targetexiste dentro del arreglo, su índice está obligatoriamente contenido en el rango [low, high]". - (c) Cómo funciona en Rust (memoria y tipos): Mantener el invariante permite al compilador (
rustc/ LLVM) optimizar las comprobaciones de límites de rango (bounds checks), eliminando lecturas redundantes en tiempo de ejecución. - (d) Error típico de Junior: No tener claro si el rango es cerrado [low, high] o semiabierto [low, high), mezclando las condiciones y provocando bucles infinitos o excepciones out of bounds.
Desbordamiento y Subdesbordamiento de usize (Overflow & Underflow)#
- (a) En palabras simples (intuición): En una regla de medir que solo empieza en cero, si intentas dar un paso hacia la izquierda del cero, la regla no te lo permite.
- (b) Definición técnica paso a paso:
usizees un tipo entero sin signo cuyo tamaño coincide con el tamaño del puntero de la arquitectura de la CPU (64 bits en sistemas modernos, rango [0, 2⁶⁴-1]). Si evalúas0usize - 1usize, el valor no pasa a-1; en modo debug Rust genera un pánico y en modo release se produce un ciclo envolvente (wrap-around) hacia 18,446,744,073,709,551,615. - (c) Cómo funciona en Rust (memoria y tipos): El código que calcula
high = mid - 1fallará catastróficamente simid == 0yhighesusize. Por ello, en Rust se prefieren rangos semiabiertos [low, high) dondehigh = mid, o el método seguromid.checked_sub(1). - (d) Error típico de Junior: Escribir
let mut high = arr.len() - 1;sin verificar antes si el arreglo está vacío, causando un pánico inmediato al evaluar0usize - 1usize.
Tipo Option<T> y Some / None#
- (a) En palabras simples (intuición): Una caja de regalo transparente que puede venir con un objeto adentro (
Some(valor)) o completamente vacía (None), obligándote a mirar dentro antes de usarlo. - (b) Definición técnica paso a paso: Enumeración canónica de Rust para representar valores opcionales o ausentes sin recurrir al puntero nulo (
NULL/Noneen Python /nullen JS). Se define comopub enum Option<T> { None, Some(T) }. - (c) Cómo funciona en Rust (memoria y tipos): Para tipos que no pueden ser cero (como referencias
&To punteros no nulos), Rust aplica la optimización de nicho (Null Pointer Optimization): el tamaño en memoria deOption<&T>es idéntico al de un puntero simple (8 bytes), sin sobrecosto de etiqueta discriminante. - (d) Error típico de Junior: Usar
-1o números mágicos como convención de error en lugar del sistema de tipos seguro de Rust.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Matemática de la Búsqueda Binaria#
Imagina un arreglo ordenado de N elementos. En la búsqueda simple o lineal:
- Paso 1: Examinamos 1 elemento. Restan N - 1.
- Paso 2: Examinamos 1 elemento. Restan N - 2.
- Paso k: Restan N - k.
En el peor caso, necesitamos N comprobaciones.
En la búsqueda binaria:
- Paso 1: Restan (N) / (2) elementos.
- Paso 2: Restan (N) / (4) = (N) / (2²) elementos.
- Paso 3: Restan (N) / (8) = (N) / (2³) elementos.
- Paso k: Restan (N) / (2ᵏ) elementos.
El algoritmo termina cuando el espacio de búsqueda se reduce a un solo elemento:
| Tamaño de la colección (N) | Búsqueda Lineal (O(N)) | Búsqueda Binaria (O(log₂ N)) | Ganancia de Eficiencia |
|---|---|---|---|
| 8 | 8 pasos | 3 pasos | ~2.6x |
| 64 | 64 pasos | 6 pasos | ~10x |
| 1,024 (2¹⁰) | 1,024 pasos | 10 pasos | ~100x |
| 1,048,576 (2²⁰) | 1,048,576 pasos | 20 pasos | ~52,000x |
| 4,294,967,296 (2³²) | 4,294,967,296 pasos | 32 pasos | ~134,000,000x |
La Trampa del Cálculo de mid y Prevención de Desbordamiento#
En tutoriales introductorios suele enseñarse la fórmula ingenua:
¿Por qué esta fórmula es peligrosa en lenguajes compilados de bajo nivel (Rust, C, C++, Java)? Si low y high son valores grandes (por ejemplo, en un arreglo grande de enteros con signo de 32 bits donde low = 1,500,000,000 y high = 1,800,000,000):
La suma excede el límite máximo del tipo i32, provocando un desbordamiento aritmético a un número negativo, lo que deriva en un índice inválido y un fallo crítico de segmentación o panic.
La formulación algebraica correcta de ingeniería es:
Demostración matemática:
Dado que high ≥ low, la resta (high - low) siempre es no negativa y nunca excede high. La división entre 2 reduce la magnitud, y al sumarla a low es matemáticamente imposible que sobrepase high.
3. Visualización Paso a Paso y Gráfica de Memoria en Rust#
Diagrama del Flujo del Algoritmo#
Consulta la visualización vectorial en alta resolución y su código fuente:
- Gráfico SVG:
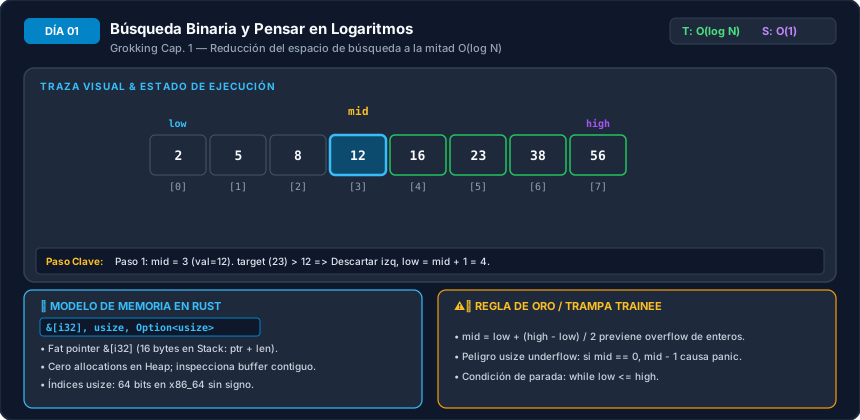 - Enlace al código fuente Mermaid: Fuente Mermaid
A continuación se presenta el flujo de decisión del algoritmo en formato interactivo:
flowchart TD
    Start["Inicio: low = 0, high = nums.len()"] --> CheckEmpty{"¿nums.is_empty()?"}
    CheckEmpty -->|Sí| RetNone["Retornar None"]
    CheckEmpty -->|No| Loop{"¿low < high?"}
    Loop -->|No| NotFound["Retornar None"]
    Loop -->|Sí| CalcMid["mid = low + (high - low) / 2"]
    CalcMid --> Compare{"Comparar nums[mid] con target"}
    Compare -->|nums[mid] == target| Found["Retornar Some(mid)"]
    Compare -->|nums[mid] < target| GoRight["low = mid + 1<br/>(buscar en mitad derecha)"]
    Compare -->|nums[mid] > target| GoLeft["high = mid<br/>(buscar en mitad izquierda)"]
    GoRight --> Loop
    GoLeft --> Loop
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Supongamos que ejecutamos binary_search(&nums, 7) con el arreglo let nums = vec![1, 3, 5, 7, 9, 11];.
MEMORIA STACK (Marco de función `main` y llamada a `binary_search`)
+-------------------------------------------------------------------------------+
| Variable    | Tipo       | Dirección Stack | Valor / Contenido                |
+-------------------------------------------------------------------------------+
| nums (Vec)  | Vec<i32>   | 0x7FFF_0010     | ptr: 0x5555_2000, cap: 6, len: 6 |
| nums (arg)  | &[i32]     | 0x7FFF_0030     | ptr: 0x5555_2000, len: 6         |
| low         | usize      | 0x7FFF_0040     | 0                                |
| high        | usize      | 0x7FFF_0048     | 6                                |
| mid         | usize      | 0x7FFF_0050     | calculado dinámicamente          |
+-------------------------------------------------------------------------------+

MEMORIA HEAP (Búfer continuo apuntado por 0x5555_2000)
Dirección:  0x2000  0x2004  0x2008  0x200C  0x2010  0x2014
Índices:       0       1       2       3       4       5
Valores:    [  1,      3,      5,      7,      9,     11  ]
Traza Paso a Paso:#
- Estado Inicial:
-
low = 0,high = 6. -mid = 0 + (6 - 0) / 2 = 3. - Elemento evaluado:nums[3] == 7. - Comparación:7 == target (7). - Resultado: ¡Coincidencia en el primer paso! RetornaSome(3).
- Búsqueda con Descarte (ejemplo
target = 9): - Paso 1: -low = 0,high = 6. -mid = 3,nums[3] = 7. - Como 7 < 9, descartamos el subintervalo [0..=3]. -low = mid + 1 = 4. - Paso 2: -low = 4,high = 6. -mid = 4 + (6 - 4) / 2 = 5. -nums[5] = 11. - Como 11 > 9, descartamos el subintervalo [5..6). -high = mid = 5. - Paso 3: -low = 4,high = 5. -mid = 4 + (5 - 4) / 2 = 4. -nums[4] = 9. - ¡Coincidencia encontrada! RetornaSome(4).
4. Implementación Canónica en Rust + Comparativa con Python#
Implementación en Rust (practica-rust/dia_01.rs)#
//! Implementación canónica de búsqueda binaria y variaciones en Rust.
//! Compilable y verificable con `rustc --test`.

/// Busca `target` en un slice ordenado utilizando un intervalo semiabierto [low, high).
///
/// Mecanismos clave de Rust:
/// 1. `&[i32]`: Permite recibir arrays fijos `[i32; N]`, vectores `Vec<i32>` o sub-slices
///    sin incurrir en copias ni asignaciones en el Heap (cero coste de abstracción).
/// 2. `Option<usize>`: Garantiza en tiempo de compilación que quien invoque la función
///    no pueda asumir ciegamente que el índice existe, evitando errores de punteros nulos o índices -1.
/// 3. Intervalo semiabierto `[low, high)`: `high` se inicializa con `nums.len()`. Cuando `target` es menor,
///    se asigna `high = mid`. Esto elimina por completo el riesgo de subdesbordamiento de `usize` (`mid - 1`).
pub fn binary_search(nums: &[i32], target: i32) -> Option<usize> {
    if nums.is_empty() {
        return None;
    }

    let mut low: usize = 0;
    let mut high: usize = nums.len();

    while low < high {
        let mid = low + (high - low) / 2;

        if nums[mid] == target {
            return Some(mid);
        } else if nums[mid] < target {
            low = mid + 1;
        } else {
            high = mid;
        }
    }

    None
}

/// LeetCode 35: Determina el índice donde existe el elemento, o la posición
/// exacta donde debe insertarse para mantener el arreglo ordenado.
pub fn search_insert_position(nums: &[i32], target: i32) -> usize {
    let mut low: usize = 0;
    let mut high: usize = nums.len();

    while low < high {
        let mid = low + (high - low) / 2;
        if nums[mid] == target {
            return mid;
        } else if nums[mid] < target {
            low = mid + 1;
        } else {
            high = mid;
        }
    }

    low
}

/// Localiza la primera ocurrencia de un elemento cuando existen duplicados.
pub fn binary_search_first_occurrence(nums: &[i32], target: i32) -> Option<usize> {
    if nums.is_empty() {
        return None;
    }

    let mut low: usize = 0;
    let mut high: usize = nums.len();
    let mut result: Option<usize> = None;

    while low < high {
        let mid = low + (high - low) / 2;

        if nums[mid] == target {
            result = Some(mid);
            high = mid; // Contrae la búsqueda a la izquierda para buscar duplicados previos
        } else if nums[mid] < target {
            low = mid + 1;
        } else {
            high = mid;
        }
    }

    result
}

#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn test_binary_search_found() {
        let arr = [1, 3, 5, 7, 9, 11];
        assert_eq!(binary_search(&arr, 1), Some(0));
        assert_eq!(binary_search(&arr, 7), Some(3));
        assert_eq!(binary_search(&arr, 11), Some(5));
    }

    #[test]
    fn test_binary_search_not_found() {
        let arr = [1, 3, 5, 7, 9, 11];
        assert_eq!(binary_search(&arr, 0), None);
        assert_eq!(binary_search(&arr, 6), None);
        assert_eq!(binary_search(&arr, 15), None);
    }

    #[test]
    fn test_binary_search_edge_cases() {
        let empty: [i32; 0] = [];
        assert_eq!(binary_search(&empty, 10), None);

        let single = [42];
        assert_eq!(binary_search(&single, 42), Some(0));
        assert_eq!(binary_search(&single, 10), None);
    }

    #[test]
    fn test_search_insert_position() {
        let nums = [1, 3, 5, 6];
        assert_eq!(search_insert_position(&nums, 5), 2);
        assert_eq!(search_insert_position(&nums, 2), 1);
        assert_eq!(search_insert_position(&nums, 7), 4);
        assert_eq!(search_insert_position(&nums, 0), 0);
    }

    #[test]
    fn test_first_occurrence() {
        let nums = [1, 2, 2, 2, 3, 4, 5];
        assert_eq!(binary_search_first_occurrence(&nums, 2), Some(1));
        assert_eq!(binary_search_first_occurrence(&nums, 9), None);
    }
}
Implementación Canónica en Python (practica/dia_01_binary_search.py)#
from typing import List

def binary_search(arr: List[int], target: int) -> int:
    low: int = 0
    high: int = len(arr) - 1

    while low <= high:
        mid: int = low + (high - low) // 2
        guess: int = arr[mid]

        if guess == target:
            return mid
        elif guess > target:
            high = mid - 1
        else:
            low = mid + 1

    return -1
Diferencias Clave entre Rust y Python:#
| Característica | Python | Rust |
|---|---|---|
| Tipo de Retorno | Entero (-1 si no existe) | Tipo algebraico Option<usize> (None si no existe) |
| Tipo de Índices | int con signo y precisión arbitraria | usize (entero sin signo de 64 bits en x86_64) |
| Riesgo de Underflow | Inexistente (0 - 1 == -1) | Crítico (0usize - 1usize provoca pánico en debug) |
| Acceso a Memoria | Punteros a objetos PyObject dinámicos | Slice contiguo en memoria plana sin indirectas |
| Comprobación de Límites | Ocurre en cada lectura arr[i] | Optimizada por LLVM mediante análisis estático de rangos |
5. Las 3 Trampas Clásicas en Entrevistas#
- Condición del Bucle: Cerrado [low, high] vs Semiabierto [low, high):
- En el rango cerrado [low, high], la condición obligatoria es
while low <= high. Si usas<, el código fallará en arreglos de 1 elemento (donde low = high = 0). - En el rango semiabierto [low, high), la condición eswhile low < high, y cuando target < nums[mid] se hace high = mid. - Desbordamiento de Enteros en Lenguajes Tipados:
-
(low + high) / 2puede desbordar tipos de 32 bits. La regla de oro eslow + (high - low) / 2. - Peligro de Bucles Infinitos por Desplazamiento Incorrecto:
- Si olvidas el
+ 1al moverlow(por ejemplo, escribiendolow = mid), en colecciones de dos elementos dondemidresulta igual alow, el bucle se repetirá indefinidamente.
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: ¿Por qué en Rust es conceptualmente más seguro usar un rango semiabierto [low, high) que un rango cerrado [low, high] para implementar búsqueda binaria?
Respuesta Técnica Detallada: En Rust, los índices de arreglos y slices deben ser estrictamente de tipo usize (entero sin signo). En un rango cerrado [low, high], si el objetivo buscado es menor que el elemento en el índice $0$, el algoritmo calcula high = mid - 1. Como mid = 0, la operación 0usize - 1usize provoca un subdesbordamiento aritmético (integer underflow). En compilaciones con modo debug activado, esto genera un pánico inmediato (attempt to subtract with overflow). En modo release sin cheques de overflow, genera un número gigante (18,446,744,073,709,551,615), lo que causará un fallo catastrófico por violación de límites en la siguiente iteración.
Al usar un rango semiabierto [low, high):
- El límite superior inicial es
high = nums.len(). - Cuando el objetivo es menor, se asigna
high = mid. Nunca se resta 1 a unusize, imposibilitando físicamente el underflow y haciendo el código formalmente seguro sin comprobaciones adicionales.
Pregunta 2: ¿Cuál es la demostración matemática formal de que el bucle de búsqueda binaria siempre termina y no entra en un bucle infinito?
Respuesta Técnica Detallada: Para demostrar que un bucle termina se utiliza una función monótona de progreso o variante del bucle. En el esquema [low, high), definimos la longitud restante del espacio de búsqueda como Δ = high - low.
- Antes de cada iteración, la condición
low < highasegura que Δ ≥ 1. - El cálculo de mid es mid = low + ⌊ (high - low) / 2 ⌋.
- Si el algoritmo toma la rama derecha (nums[mid] < target): el nuevo límite inferior es low' = mid + 1 = low + ⌊ Δ / 2 ⌋ + 1. Dado que ⌊ Δ / 2 ⌋ ≥ 0, tenemos que low' > low, por lo que el nuevo Δ' = high - low' < Δ.
- Si el algoritmo toma la rama izquierda (nums[mid] > target): el nuevo límite superior es high' = mid = low + ⌊ Δ / 2 ⌋. Como ⌊ Δ / 2 ⌋ < Δ para todo Δ ≥ 1, el nuevo Δ' = high' - low = ⌊ Δ / 2 ⌋ < Δ.
En ambas ramas, Δ disminuye estrictamente como mínimo en una unidad entera en cada paso (Δ' < Δ). Como Δ ∈ ℕ, por el principio del buen orden, Δ debe alcanzar eventualmente el valor $0$ (donde low == high), garantizando la terminación estricta del bucle en a lo sumo ⌈ log₂ N ⌉ + 1 pasos.
Pregunta 3: ¿Por qué en LeetCode 35 (Search Insert Position), cuando el elemento objetivo no existe, el puntero low siempre coincide exactamente con la posición correcta de inserción?
Respuesta Técnica Detallada: El algoritmo mantiene dos invariantes fundamentales durante toda su ejecución:
- Todos los elementos en el subarreglo nums[0 .. low] son estrictamente menores que target.
- Todos los elementos en el subarreglo nums[high .. N] son estrictamente mayores o iguales que target.
Cuando el bucle finaliza, la condición de parada establece que low == high. Por transitividad de ambos invariantes, todo elemento a la izquierda del índice low es menor que target, y todo elemento a partir del índice low (que ahora es idéntico a high) es mayor que target. Por lo tanto, el índice low define con precisión matemática la frontera exacta donde target debe insertarse para mantener el orden ascendente global sin alterar la posición relativa de los demás elementos.
Pregunta 4: Si un candidato en una entrevista propone ordenar primero un arreglo no ordenado con MergeSort (O(N log N)) para luego hacer búsqueda binaria (O(log N)) para una sola consulta, ¿por qué es una mala decisión de diseño de sistemas?
Respuesta Técnica Detallada: Para una sola consulta individual, ordenar primero el arreglo tiene un costo de O(N log N), y la búsqueda binaria posterior cuesta O(log N). El costo total agregado es O(N log N + log N) = O(N log N). En contraste, una búsqueda lineal simple recorre el arreglo no ordenado de principio a fin con un costo de O(N). Dado que N < N log N para todo N ≥ 2, ordenar para una sola búsqueda es estrictamente más ineficiente en tiempo y con frecuencia introduce una penalización espacial de O(N) o copias en memoria.
La regla de ingeniería de sistemas es:
- 1 sola consulta: Usar búsqueda lineal directa (O(N) tiempo, O(1) espacio).
- M consultas múltiples (M gg log N): Amortizar el costo ordenando una sola vez (O(N log N)) y ejecutando luego M búsquedas binarias (O(M log N)), o construir una tabla hash (O(N) tiempo de construcción, O(1) por consulta).
Pregunta 5: ¿Cómo aprovecha el compilador de Rust (rustc / LLVM) la estructura del bucle de búsqueda binaria para optimizar las lecturas en memoria?
Respuesta Técnica Detallada: Por seguridad de memoria, toda indexación en Rust nums[mid] evalúa internamente una verificación de límites (bounds check): if mid >= nums.len() { panic!(); }. En la búsqueda binaria estructurada con intervalo [low, high) donde high = nums.len() y mid = low + (high - low) / 2:
- El analizador de rangos de LLVM (Range Analysis Pass) deduce algebraicamente que 0 ≤ low < high ≤ nums.len().
- De allí demuestra formalmente que mid < high ≤ nums.len().
- Al certificar en tiempo de compilación que mid es matemáticamente inferior a la longitud del slice, el compilador puede eliminar de raíz la instrucción condicional de bounds check en el código ensamblador generado, emitiendo una lectura directa de memoria (
mov) y acelerando el bucle a velocidad nativa sin sacrificar la seguridad de tipos.
7. Puente a LeetCode y Práctica de Código#
Aplica de inmediato estos conceptos resolviendo los siguientes problemas canónicos:
- LeetCode 704 — Binary Search (Easy): - Implementa la versión semiabierta o cerrada vista hoy. - Puntos críticos: Casos de frontera con arreglos de 1 elemento y valores ausentes en los extremos.
- LeetCode 35 — Search Insert Position (Easy):
- Idéntico patrón. El retorno en caso de no coincidencia es directamente
low. - LeetCode 34 — Find First and Last Position of Element in Sorted Array (Medium): - Aplica dos búsquedas binarias consecutivas modificadas (primera ocurrencia y última ocurrencia).
8. Tarea en Papel (Dry-Run Obligatorio)#
Realiza la traza a mano con lápiz y papel sin recurrir a la computadora:
- Arreglo:
nums = [2, 4, 6, 8, 10, 12, 14, 16] - Traza la tabla completa de variables (
low,high,mid,nums[mid], acción):
- Para
target = 14. - Para
target = 7.
- Confirma que para
target = 7, el valor final delowsea el índice3(la posición exacta donde el 7 debería insertarse entre el 6 y el 8).
Navegación: