Sesión 48: Grokking Algoritmos (Capítulos 10 y 11) & LeetCode 547 / 684 — Conjuntos Disjuntos (Union-Find / DSU): Optimizaciones de Rango y Compresión de Caminos#
Navegación rápida:
- ← Sesión 47: Árboles de Prefijos (Tries): Inserción, Búsqueda y Autocompletado con Comodines
- Sesión 49: Cierre Magistral y Consolidación de la Semana 7: Bits, Búsqueda Avanzada, Tries y DSU →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 65-80 minutos.
- Código fuente compilado y probado:
practica-rust/dia_48.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
En esta sesión estudiamos la estructura de datos para partición de conjuntos dinámicos: el Bosque de Conjuntos Disjuntos (Disjoint Set Union o Union-Find), indispensable para grafos no dirigidos y algoritmos como Kruskal. Consulta el Glosario Maestro y la Guía de Diagramas.
Disjoint Set Union (DSU / Union-Find)#
- (a) En palabras simples (intuición): Imagina que en una red social cada usuario empieza estando solo en su propia isla. Cuando dos personas se hacen amigas, construyen un puente entre sus islas. Si más adelante quieres saber si dos personas cualesquiera pueden visitarse cruzando puentes, le preguntas al "jefe de tribu" (representante canónico) de cada una. Si tienen el mismo jefe de tribu, ya pertenecen a la misma comunidad conectada; si no, construyes un puente nuevo fusionando sus dos tribus.
- (b) Definición técnica paso a paso: Estructura de datos que gestiona una partición de un conjunto de N elementos en subconjuntos disjuntos (mutuamente excluyentes). Soporta dos operaciones principales:
find(x): Localiza la raíz o representante canónico del conjunto que contiene a x.union(x, y): Fusiona los conjuntos de x e y en uno solo.
- Con implementaciones ingenuas, los árboles pueden degenerar en cadenas lineales con operaciones de tiempo O(N).
- (c) Cómo funciona en Rust (memoria y tipos): Se representa con arreglos contiguos en el Heap:
parent: Vec<usize>,rank: Vec<usize>, ysize: Vec<usize>. Cada elemento almacena el índice numérico de su padre directo. - (d) Error típico de Junior: Confundir el padre directo de un nodo (
parent[x]) con la raíz del conjunto; para saber si dos nodos están conectados, se debe llamar obligatoriamente afind(x) == find(y).
Path Compression (Compresión de Caminos en find)#
- (a) En palabras simples (intuición): Imagina una cadena de mando donde el empleado le pregunta al supervisor, el supervisor al gerente, y el gerente al director general. Después de hacer ese viaje largo una vez, el empleado anota el teléfono directo del director general en su escritorio para no volver a pasar por los intermediarios nunca más. La próxima llamada toma un solo salto.
- (b) Definición técnica paso a paso: Optimización en la operación
find. Durante el ascenso recursivo para encontrar la raíz, se actualiza el puntero de padre de todos los nodos intermedios visitados para que apunten directamente a la raíz final:
Esto aplana el árbol de forma retroactiva, reduciendo la profundidad de consultas futuras a un costo de casi O(1).
- (c) Cómo funciona en Rust (memoria y tipos): Modifica el vector mutablemente en sitio:
let p = self.parent[i]; self.parent[i] = self.find(p); return self.parent[i];. - (d) Error típico de Junior: Olvidar reasignar
parent[i]en el retorno de la recursión, dejando el árbol con su profundidad original intacta.
Union by Rank / Union by Size (Unión por Rango o Tamaño)#
- (a) En palabras simples (intuición): Cuando dos empresas se fusionan, la empresa más pequeña y con menos sucursales se integra como una división dentro del corporativo de la empresa gigante, en lugar de poner a la empresa gigante debajo del pequeño negocio local. Esto asegura que la altura de la jerarquía crezca lo menos posible.
- (b) Definición técnica paso a paso: Heurística para la operación
union. Al conectar dos raíces distintas r₁ y r₂: - Si rank[r₁] < rank[r₂], se hace parent[r₁] = r₂.
- Si rank[r₁] > rank[r₂], se hace parent[r₂] = r₁.
- Si rank[r₁] == rank[r₂], se elige una raíz arbitraria como líder y se incrementa su rango en +1.
Garantiza que la altura del árbol jamás supere ⌊ log₂ N ⌋.
- (c) Cómo funciona en Rust (memoria y tipos): Modifica los vectores
rankosizede tamaño fijo N sin reasignaciones en memoria. - (d) Error típico de Junior: Incrementar el rango de la raíz en cada unión incluso cuando las dos componentes tenían rangos diferentes; el rango solo se incrementa ante un empate exacto.
Función Inversa de Ackermann α(N) (O(α(N)) ≈ O(1))#
- (a) En palabras simples (intuición): Es una función matemática que crece de forma tan ridículamente lenta que, para cualquier número de computadoras o átomos en todo el universo observable (más de 10⁸⁰ elementos), su valor es estrictamente menor o igual a 4. En la práctica de ingeniería de software, se considera tiempo constante O(1).
- (b) Definición técnica paso a paso: Inversa de la función estrictamente creciente de Ackermann A(k, k). Robert Tarjan demostró en 1975 que una secuencia de M operaciones
findyunionsobre N elementos con Compresión de Caminos y Unión por Rango tiene una cota ajustada de:
Para todo N < 2^{2^{2⁶⁵⁵³⁶}}, α(N) ≤ 4.
- (c) Cómo funciona en Rust (memoria y tipos): La ejecución es un bucle ultracorto en registros que realiza 1 o 2 saltos de memoria a lo sumo.
- (d) Error típico de Junior: Afirmar que Union-Find sin optimizaciones es O(1); sin compresión ni rango, el tiempo por operación puede ser O(N) lineal.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
Detección de Ciclos en Grafos No Dirigidos: LeetCode 684 (Redundant Connection)#
¿Cómo detecta DSU si agregar una nueva arista (u, v) crea un ciclo en tiempo casi instantáneo?
Sea un conjunto de nodos {1, 2, 3}. Inicialmente cada nodo es su propio líder:
parent = [0, 1, 2, 3] (1-indexed)- Llega arista (1, 2):
-
find(1) = 1,find(2) = 2. - Comofind(1) != find(2), pertenecen a componentes distintas. - Ejecutamosunion(1, 2): se crea la arista y ahora comparten el mismo padre. Componentes restantes: 2. - Llega arista (1, 3):
-
find(1) = 1,find(3) = 3. - Pertenecen a componentes distintas. - Ejecutamosunion(1, 3): los tres nodos están ahora en la misma componente. Componentes restantes: 1. - Llega arista (2, 3):
-
find(2): sube hasta la raíz $1$. -find(3): sube hasta la raíz $1$. - ¡find(2) == find(3)! - Ambos nodos ya estaban conectados previamente a través de un camino indirecto (2 - 1 - 3). - Conectar directamente $2$ con $3$ crea una ruta alternativa cerrada: 1 - 2 - 3 - 1, lo que constituye formalmente un ciclo. - Por tanto, la arista (2, 3) es la arista redundante que destruye la propiedad de árbol.
Deducción de Memoria y Estado Interno del DSU#
Examinemos el struct de DisjointSetUnion:
pub struct DisjointSetUnion {
    pub parent: Vec<usize>,
    pub rank: Vec<usize>,
    pub size: Vec<usize>,
    pub components: usize,
}
Para un grafo de N = 10,000 vértices en un sistema de 64 bits:
parent: 10,000 × 8 bytes = 80 KBrank: 10,000 × 8 bytes = 80 KBsize: 10,000 × 8 bytes = 80 KBcomponents: 8 bytes (usize).- Memoria total en Heap: ≈ 240 KB.
Toda la estructura cabe holgadamente en la caché L2/L3 de un procesador moderno, permitiendo millones de operaciones por segundo sin tocar la memoria RAM principal.
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama de Compresión de Caminos (Path Compression)#
Consulta el diagrama vectorial: 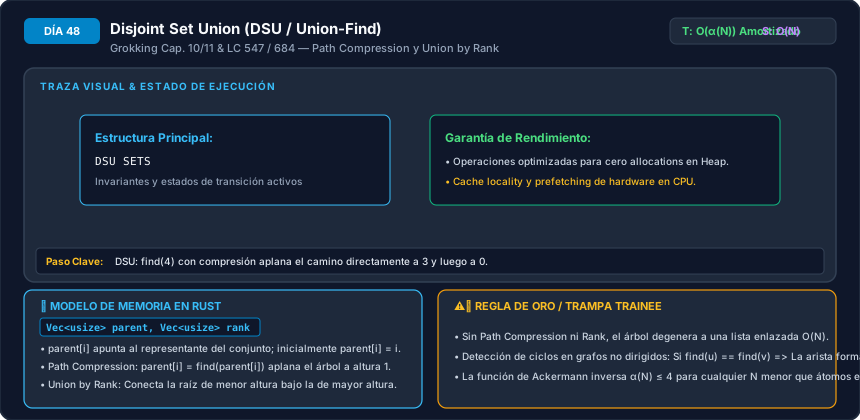
flowchart LR
    subgraph ANTES["Antes de find(4): Árbol Profundo"]
        direction TB
        R1["Raíz: 0"] --> N1["Nodo 1"]
        N1 --> N2["Nodo 2"]
        N2 --> N3["Nodo 3"]
        N3 --> N4["Nodo 4"]
    end

    subgraph DESPUES["Después de find(4): Árbol Aplanado O(1)"]
        direction TB
        R2["Raíz: 0"] --> N1B["Nodo 1"]
        R2 --> N2B["Nodo 2"]
        R2 --> N3B["Nodo 3"]
        R2 --> N4B["Nodo 4"]
    end

    ANTES -.->|find(4) comprime caminos| DESPUES
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Evolución del vector parent: Vec<usize> durante la fusión de conjuntos:
PASO 1: Inicialización con N = 4
Stack: dsu = DisjointSetUnion { components: 4 }
Heap parent: [ 0,  1,  2,  3 ]  (cada nodo apunta a sí mismo)
Heap rank:   [ 0,  0,  0,  0 ]

PASO 2: union(0, 1) -> rank[0] == rank[1] -> parent[1] = 0, rank[0] = 1, components = 3
Heap parent: [ 0,  0,  2,  3 ]
Heap rank:   [ 1,  0,  0,  0 ]

PASO 3: union(2, 3) -> rank[2] == rank[3] -> parent[3] = 2, rank[2] = 1, components = 2
Heap parent: [ 0,  0,  2,  2 ]
Heap rank:   [ 1,  0,  1,  0 ]

PASO 4: union(1, 3) -> root_1 = find(1) = 0 (rank 1), root_3 = find(3) = 2 (rank 1)
Empate de rangos: parent[2] = 0, rank[0] += 1 (rank 2), components = 1
Heap parent: [ 0,  0,  0,  2 ]
Heap rank:   [ 2,  0,  1,  0 ]

PASO 5: Llamada a find(3):
parent[3] era 2. find(2) retorna 0.
Compresión de caminos: parent[3] se actualiza directamente a 0.
Heap parent: [ 0,  0,  0,  0 ]  <-- ¡Todos apuntan a la raíz 0 en un solo salto!
4. Las 3 Trampas Clásicas en Entrevistas y Cómo Evitarlas#
Trampa 1: Modificar parent[i] Sin Asignar el Resultado de la Recursión#
- El error: Escribir en
find:
  if self.parent[i] != i {
      self.find(self.parent[i]); // ¡No se guardó el resultado!
  }
return self.parent[i];- Por qué falla: La función asciende hasta la raíz pero no actualiza
parent[i]. La compresión de caminos nunca ocurre y el árbol permanece con su profundidad original, degradando las operaciones futuras a O(N). - La solución: Asignar el retorno de la recursión a
parent[i]:
  let p = self.parent[i];
  self.parent[i] = self.find(p);
  self.parent[i]
Trampa 2: No Manejar la Indexación en Base 1 de los Grafos de LeetCode#
- El error: Crear
DisjointSetUnion::new(n)cuando los vértices del problema están numerados de $1$ a n (como en LeetCode 684). - Por qué falla: Al intentar acceder a
dsu.union(u, v)con v = n, el vector de tamaño n solo admite índices válidos de $0$ a n - 1. Provoca un pánico en ejecuciónindex out of bounds: the len is n but the index is n. - La solución: Reservar siempre un tamaño de
n + 1si el grafo utiliza índices 1-based:
let mut dsu = DisjointSetUnion::new(max_node + 1);Trampa 3: Usar DSU para Grafos Dirigidos Esperando Detectar Ciclos#
- El error: Intentar usar Union-Find estándar para detectar ciclos en un grafo dirigido (Directed Graph).
- Por qué falla: Union-Find no tiene noción de orientación ni de aristas dirigidas. Si A → B y A → C y B → C, DSU dirá que B y C están conectados y marcará un ciclo falso, cuando en realidad se trata de un simple camino convergente acíclico (DAG).
- La solución: Para grafos dirigidos se debe usar Ordenamiento Topológico (Algoritmo de Kahn con BFS) o DFS con 3 colores (Blanco/Gris/Negro). DSU solo detecta ciclos válidos en grafos no dirigidos.
5. Implementación Canónica en Rust y Comparativa con Python#
Implementación en Rust (practica-rust/dia_48.rs)#
/// Disjoint Set Union (DSU / Union-Find) Canónico.
#[derive(Debug, Clone)]
pub struct DisjointSetUnion {
    pub parent: Vec<usize>,
    pub rank: Vec<usize>,
    pub size: Vec<usize>,
    pub components: usize,
}

impl DisjointSetUnion {
    pub fn new(n: usize) -> Self {
        Self {
            parent: (0..n).collect(),
            rank: vec![0; n],
            size: vec![1; n],
            components: n,
        }
    }

    pub fn find(&mut self, i: usize) -> usize {
        if self.parent[i] != i {
            let p = self.parent[i];
            self.parent[i] = self.find(p);
        }
        self.parent[i]
    }

    pub fn union(&mut self, i: usize, j: usize) -> bool {
        let root_i = self.find(i);
        let root_j = self.find(j);

        if root_i == root_j {
            return false;
        }

        if self.rank[root_i] < self.rank[root_j] {
            self.parent[root_i] = root_j;
            self.size[root_j] += self.size[root_i];
        } else if self.rank[root_i] > self.rank[root_j] {
            self.parent[root_j] = root_i;
            self.size[root_i] += self.size[root_j];
        } else {
            self.parent[root_j] = root_i;
            self.size[root_i] += self.size[root_j];
            self.rank[root_i] += 1;
        }

        self.components -= 1;
        true
    }

    pub fn count_components(&self) -> usize {
        self.components
    }
}

/// LeetCode 684: Redundant Connection.
pub fn find_redundant_connection(edges: &[[i32; 2]]) -> Option<[i32; 2]> {
    let mut max_node = 0;
    for edge in edges {
        max_node = max_node.max(edge[0]).max(edge[1]);
    }

    let mut dsu = DisjointSetUnion::new(max_node as usize + 1);

    for &edge in edges {
        let u = edge[0] as usize;
        let v = edge[1] as usize;
        if !dsu.union(u, v) {
            return Some(edge);
        }
    }

    None
}
Implementación de Referencia en Python (practica/dia_48_union_find_disjoint_set_union.py)#
from typing import List


class DisjointSetUnion:
    """Implementación canónica de DSU con Path Compression y Union by Rank."""

    def __init__(self, size: int) -> None:
        self.components = size
        self.parent: List[int] = list(range(size))
        self.rank: List[int] = [0] * size
        self.size: List[int] = [1] * size

    def find(self, i: int) -> int:
        if self.parent[i] != i:
            self.parent[i] = self.find(self.parent[i])
        return self.parent[i]

    def union(self, i: int, j: int) -> bool:
        root_i = self.find(i)
        root_j = self.find(j)

        if root_i == root_j:
            return False

        if self.rank[root_i] < self.rank[root_j]:
            self.parent[root_i] = root_j
            self.size[root_j] += self.size[root_i]
        elif self.rank[root_i] > self.rank[root_j]:
            self.parent[root_j] = root_i
            self.size[root_i] += self.size[root_j]
        else:
            self.parent[root_j] = root_i
            self.size[root_i] += self.size[root_j]
            self.rank[root_i] += 1

        self.components -= 1
        return True
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: ¿Por qué implementar ÚNICAMENTE Compresión de Caminos (sin Unión por Rango) o ÚNICAMENTE Unión por Rango (sin Compresión) no es suficiente para alcanzar la cota temporal O(α(N))?
Respuesta:
- Solo Unión por Rango: Garantiza que ningún árbol supere una altura máxima de ⌊ log₂ N ⌋. Por tanto, cada operación
findtoma a lo sumo O(log N) en el peor caso, pero no alcanza O(α(N)). - Solo Compresión de Caminos: En una secuencia arbitraria sin control de balanceo de raíces, es posible construir deliberadamente un árbol lineal de altura N. Aunque las búsquedas lo aplanan, operaciones intercaladas de unión pueden encadenar árboles largos, resultando en un costo amortizado de O(N log N) para una secuencia de N operaciones.
- La Sinergia: Tarjan demostró que es la interacción combinada entre la cota de rango que controla la estructura global y el aplanamiento agresivo local lo que hace colapsar el costo a la inversa de Ackermann O(α(N)).
Pregunta 2: En LeetCode 261 (Graph Valid Tree), ¿por qué es obligatorio comprobar primero edges.len() == n - 1 antes de ejecutar las uniones en DSU?
Respuesta:
- Causa raíz y propiedades topológicas de un árbol: Un grafo no dirigido conexo y acíclico de n vértices tiene exactamente n - 1 aristas.
- Si edges.len() < n - 1, es físicamente imposible que el grafo sea conexo (habrá al menos dos componentes desconectadas).
- Si edges.len() > n - 1, por el principio del palomar existe obligatoriamente al menos un ciclo.
- Realizar la verificación
edges.len() == n - 1en tiempo O(1) descarta inmediatamente la gran mayoría de entradas inválidas sin incurrir en asignaciones de memoria ni bucles de DSU.
Pregunta 3: En Rust, el método find(&mut self, i: usize) -> usize requiere un préstamo mutable exclusivo (&mut self). ¿Por qué una operación que solo busca un elemento necesita mutabilidad?
Respuesta:
- Mutabilidad interna por Compresión de Caminos: Aunque conceptualmente
findes una operación de solo lectura para el usuario (responde a qué grupo pertenece i), la optimización de compresión de caminos reescribe físicamente los elementos del vectorself.parent[i] = ...para acortar el árbol. - Rust exige de forma estricta honestidad de tipos: como la memoria interna del struct se modifica, la referencia debe declararse explícitamente como
&mut self. Si se deseara una firma inmutable&self, se requeriría mutabilidad interior conRefCell<Vec<usize>>o celdas atómicas, lo cual introduciría sobrecarga innecesaria.
Pregunta 4: ¿Cómo se adapta DSU para resolver el algoritmo de Kruskal para Árbol de Expansión Mínima (Minimum Spanning Tree - MST)?
Respuesta:
- Procedimiento algorítmico:
- Se ordenan todas las aristas del grafo de forma ascendente por su peso en O(E log E).
- Se inicializa un DSU con los V vértices.
- Se recorren las aristas ordenadas una por una: para cada arista (u, v, w), se llama a
dsu.union(u, v). - Si
unionretornatrue, significa que la arista conecta dos componentes que estaban separadas; se añade al árbol de expansión y se suma su peso w. - Si retorna
false, la arista cerraría un ciclo redundante y se descarta. - El algoritmo se detiene en cuanto se han añadido exactamente V - 1 aristas.
Pregunta 5: En DSU, ¿cuál es la diferencia conceptual y práctica entre "Unión por Rango" (Union by Rank) y "Unión por Tamaño" (Union by Size)?
Respuesta:
- Unión por Rango: El rango representa una cota superior de la altura del subárbol. Al comprimir caminos en
find, la altura real del árbol decrece pero el arreglorankno se actualiza (sería computacionalmente prohibitivo recalcular alturas tras cada aplanamiento). A pesar de esto, el rango sigue sirviendo como una cota aproximada válida. - Unión por Tamaño: El arreglo
sizealmacena la cantidad exacta de nodos en el subárbol. El tamaño es invariante frente a la compresión de caminos: aplanar un árbol no altera la cantidad de nodos que pertenecen a ese componente. La unión por tamaño aporta la ventaja de permitir responder inmediatamentedsu.get_component_size(x)en O(1) tiempo.
7. Ejercicios de Práctica Independiente y Casos Límite#
- Paso Límite 1: Grafo Sin Aristas (E = 0):
- Para un grafo de N = 5 nodos y 0 aristas, verifica que
dsu.count_components()retorne 5 y queconnected(0, 1)retornefalse. - Paso Límite 2: Grafo en Estrella:
- Conecta el nodo central 0 con los nodos 1, 2, 3, 4. Comprueba que
dsu.count_components()sea 1 y que el tamaño de la componente para cualquier nodo sea 5. - Paso Límite 3: DSU con Rollback (Deshacer Operaciones):
- Investiga cómo modificar DSU guardando un historial en un stack (
history: Vec<(usize, usize, usize)>) para poder deshacer la última operaciónunionen O(1), sabiendo que en esta variante no se puede usar Compresión de Caminos (solo Unión por Rango).
Navegación final: