Sesión 47: Grokking Algoritmos (Capítulo 11) & LeetCode 208 / 211 — Árboles de Prefijos (Tries) y Búsqueda con Comodines#
Navegación rápida:
- ← Sesión 46: CTCI Ch10 — Búsqueda en Matriz Ordenada y Rango en Flujo de Datos
- Sesión 48: Conjuntos Disjuntos (Union-Find / DSU): Optimizaciones de Rango y Compresión de Caminos →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 65-80 minutos.
- Código fuente compilado y probado:
practica-rust/dia_47.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
En esta sesión profundizamos en el diseño de árboles de búsqueda de k-vías para cadenas de texto, el autocompletado de prefijos y la búsqueda difusa mediante comodines. Consulta el Glosario Maestro y la Guía de Diagramas.
Trie (Prefix Tree / Árbol de Prefijos)#
- (a) En palabras simples (intuición): Imagina un árbol genealógico de palabras donde cada rama es una letra del abecedario. Para escribir "casa", partes de la raíz, sigues la rama 'c', luego la rama 'a', luego la 's' y finalmente la 'a'. Si después quieres agregar "caso", no creas un árbol nuevo; reutilizas las ramas 'c', 'a', 's' que ya existían y solo agregas una rama 'o' al final. Es exactamente la estructura que usan los teclados de teléfonos móviles y buscadores para autocompletar texto en tiempo real.
- (b) Definición técnica paso a paso: Estructura de árbol de búsqueda ordenada donde las claves son cadenas de caracteres. A diferencia de un BST donde cada nodo contiene una clave completa, en un Trie la posición de un nodo dentro del árbol determina la clave asociada. Todos los descendientes de un nodo comparten un prefijo común. Operaciones:
insert(word): Desciende carácter por carácter creando nodos si no existen. Marcais_end_of_word = true. Tiempo O(L), donde L es la longitud de la palabra.search(word): Recorre los caracteres; retornatruesi el camino existe y el último nodo tieneis_end_of_word == true. Tiempo O(L).starts_with(prefix): Verifica si el prefijo existe como camino en el Trie, sin importar si finaliza una palabra. Tiempo O(P).- (c) Cómo funciona en Rust (memoria y tipos): Se implementa eficientemente con una Arena de Nodos (
Vec<TrieNode>), donde cada nodo almacena un arreglo estático de índiceschildren: [Option<usize>; 26]. Esto elimina la sobrecarga de punteros de Heap individuales (Box) y maximiza la localidad espacial en la caché L1/L2. - (d) Error típico de Junior: Confundir
searchconstarts_with:search("app")debe retornarfalsesi en el Trie solo se insertó"apple", porque"app"no fue marcada como fin de palabra completa.
Arena Allocation para Nodos de Árbol (Índices usize vs Punteros Box)#
- (a) En palabras simples (intuición): En lugar de pedirle al sistema operativo un pedacito diminuto de memoria cada vez que nace una letra nueva (lo que fragmenta la memoria como un suelo con agujeros), compras un terreno grande y continuo (un vector) y numeras cada casa con un índice 0, 1, 2…. Las conexiones entre letras son simplemente números enteros que indican el número de casa.
- (b) Definición técnica paso a paso: Patrón de diseño arquitectónico en sistemas donde múltiples objetos homogéneos de tamaño fijo se almacenan contiguamente dentro de un único vector preasignado (
Vec<TrieNode>). Cada puntero de hijo se representa comoOption<usize>en lugar deOption<Box<TrieNode>>oRc<RefCell<Node>>. - (c) Cómo funciona en Rust (memoria y tipos): Resuelve de forma elegante el sistema de borrow checker de Rust: como todos los nodos residen en un solo vector contiguo, no existen ciclos de referencias, no hay fugas de memoria y la recolección de todo el árbol ocurre instantáneamente cuando el vector sale de ámbito.
- (d) Error típico de Junior: Usar
Rc<RefCell<TrieNode>>en entrevistas de Rust para implementar estructuras de árbol, lo que introduce sobrecarga de conteo de referencias atómicas y riesgos de pánico en tiempo de ejecución por préstamos mutables simultáneos.
Búsqueda con Comodín (Wildcard Search '.')#
- (a) En palabras simples (intuición): Cuando juegas al Scrabble y tienes una ficha en blanco (comodín) que puede ser cualquier letra. Si buscas
.at, el algoritmo prueba conbat,cat,fat,hat, etc., explorando en abanico todas las letras posibles que existan en ese nivel del árbol. - (b) Definición técnica paso a paso: Algoritmo de búsqueda en profundidad (DFS / Backtracking) sobre el Trie (LeetCode 211). Cuando el carácter en la posición actual es el comodín
'.': - No se indexa un hijo específico.
- Se itera sobre todos los 26 hijos existentes del nodo actual.
- Si alguna rama recursiva retorna
true, la búsqueda global tiene éxito. - Si el carácter es una letra normal (
'a'..'z'), se desciende únicamente por el hijo correspondiente. - (c) Cómo funciona en Rust (memoria y tipos): Se implementa mediante una función auxiliar recursiva
search_dfs(node_idx, bytes, depth)sobre un slice de bytes&[u8]. - (d) Error típico de Junior: En el caso base de la recursión (
depth == bytes.len()), retornartrueincondicionalmente en lugar de verificarnode.is_end_of_word.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
Trie vs Tabla Hash: ¿Por qué Usar un Trie?#
En una entrevista, el entrevistador suele preguntar: "¿Por qué usar un Trie para buscar palabras si una Hash Table (HashMap<String, bool>) ofrece búsqueda en tiempo promedio O(1)?"
Un ingeniero Junior suele equivocarse diciendo que el Trie es más rápido porque es O(L) y la Hash Table es O(1). Esa afirmación es matemáticamente falsa:
- El Costo Real de la Función Hash: - Para insertar o buscar una palabra de longitud L en una tabla Hash, el procesador debe leer todos y cada uno de los L caracteres para calcular el código hash criptográfico o multiplicativo (como SipHash o MurmurHash). - Por tanto, la complejidad real de búsqueda en una tabla Hash es O(L), exactamente la misma que en un Trie.
- Ventajas Insustituibles del Trie:
- Búsqueda de Prefijos (
starts_with): Una tabla Hash no puede saber si existe alguna palabra que comience con"desast"sin escanear linealmente todas las millones de claves (O(N · L)). El Trie lo responde en O(P), donde P es la longitud del prefijo. - Autocompletado y Orden Lexicográfico: Un Trie mantiene todas las palabras automáticamente ordenadas alfabéticamente por la propia topología del árbol. - Compresión de Prefijos Compartidos: Palabras como"transportar","transporte","transportista"comparten los primeros 9 caracteres ("transport"), almacenándolos una sola vez en memoria. - Búsqueda Difusa y Comodines: Permite explorar ramas alternativas con un comodín.sin recorrer toda la base de datos.
Deducción de Memoria: Arreglo de Hijos [Option<usize>; 26]#
En nuestro diseño, cada nodo tiene:
pub struct TrieNode {
    pub children: [Option<usize>; 26],
    pub is_end_of_word: bool,
    pub word_count: usize,
    pub prefix_count: usize,
}
Analicemos el tamaño en memoria física de un solo TrieNode en arquitectura x86_64:
children: Arreglo de 26 elementosOption<usize>.- En Rust,
usizeocupa 8 bytes. - Gracias a la optimización de nicho (niche filling),
Option<usize>ocupa exactamente 8 bytes (reservando un valor centinela comousize::MAXparaNone) o 16 bytes según la versión de rustc. Típicamente 26 × 8 = 208 bytes. is_end_of_word: 1 byte (más alineación).word_count: 8 bytes (usize).prefix_count: 8 bytes (usize).- Tamaño aproximado por nodo: ≈ 232 bytes.
Al estar organizados en un único vector continuo en el Heap, toda la memoria de los nodos es secuencial. Cuando la CPU carga un nodo, la línea de caché L1 (64 bytes) precarga automáticamente los primeros punteros de hijos en silicio de alta velocidad.
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama Topológico del Trie#
Consulta el diagrama vectorial: 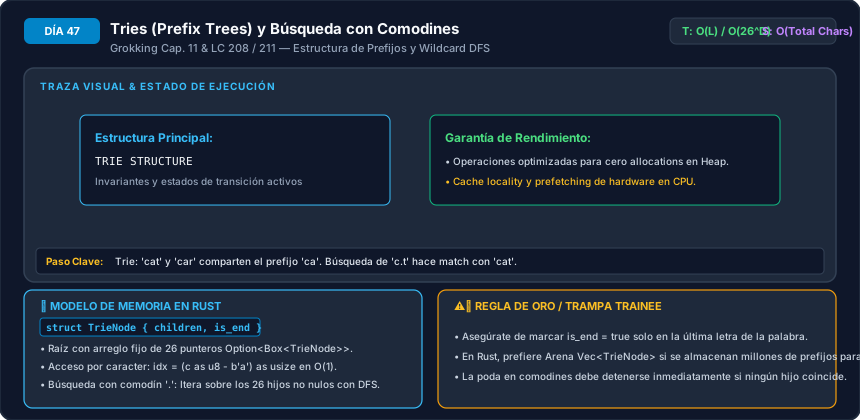
flowchart TD
    ROOT["Nodo 0: Raíz (prefix: 3)"] -->|c| N1["Nodo 1: 'c' (prefix: 3)"]
    N1 -->|a| N2["Nodo 2: 'ca' (prefix: 3)"]
    N2 -->|r| N3["Nodo 3: 'car' (word: car, prefix: 2)"]
    N2 -->|m| N4["Nodo 4: 'cam' (prefix: 1)"]
    N3 -->|t| N5["Nodo 5: 'cart' (word: cart, prefix: 1)"]
    N4 -->|p| N6["Nodo 6: 'camp' (word: camp, prefix: 1)"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Estado del vector de arena nodes: Vec<TrieNode> tras insertar "car" y "cat":
STACK:
[ trie: Trie { nodes: Vec<TrieNode> { ptr: 0x2000_heap, cap: 8, len: 5 } } ]

HEAP (Arena contigua de Nodos):
Índice  Prefijo Representado  children['a'..'z']                      is_end  prefix_count
[0]     "" (Raíz)             children[b'c'-b'a' = 2] = Some(1)       false   2
[1]     "c"                   children[b'a'-b'a' = 0] = Some(2)       false   2
[2]     "ca"                  children['r'] = Some(3), ['t'] = Some(4) false 2
[3]     "car"                 children = [None; 26]                   true    1
[4]     "cat"                 children = [None; 26]                   true    1

BÚSQUEDA DE WILDCARD ".at":
Nivel 0 (depth 0, char '.'):
- Desde nodo 0, evalúa todos los hijos: solo existe hijo 'c' (índice 1). Desciende a nodo 1.
Nivel 1 (depth 1, char 'a'):
- Desde nodo 1, busca hijo 'a' -> existe (índice 2). Desciende a nodo 2.
Nivel 2 (depth 2, char 't'):
- Desde nodo 2, busca hijo 't' -> existe (índice 4). Desciende a nodo 4.
Nivel 3 (depth 3 == len(".at")):
- En nodo 4, verifica is_end_of_word -> TRUE ("cat" coincide con ".at").
Retorno: TRUE.
4. Las 3 Trampas Clásicas en Entrevistas y Cómo Evitarlas#
Trampa 1: Asignar un HashMap por Cada Nodo en el Trie#
- El error: Definir
children: HashMap<char, TrieNode>para alfabetos pequeños en inglés ('a'..'z'). - Por qué falla: Una tabla hash tiene una sobrecarga de memoria enorme (al menos 48 bytes por tabla más cubetas y dispersión). Para millones de nodos, la memoria se multiplica por 10× y destruye la localidad espacial de la caché.
- La solución: Para alfabetos fijos ASCII ('a'..'z'), utilizar siempre un arreglo estático
[Option<usize>; 26]. Es más rápido, directo y predecible.
Trampa 2: Complejidad Exponencial en Búsquedas de Múltiples Comodines Consecutivos#
- El error: Asumir que la búsqueda con comodines en LeetCode 211 siempre es O(L).
- Por qué falla: Si una palabra de búsqueda consiste en puros comodines
......, en cada nivel el algoritmo se bifurca hasta 26 veces. En el peor caso la complejidad temporal es O(26^L). - La solución: Mencionar explícitamente al entrevistador el análisis de peor caso O(26^L) para cadenas dominadas por
.y explicar cómo el podado temprano por ramas vacías (None) mitiga el costo en casos prácticos.
Trampa 3: Fugas de Memoria y Nodos Huérfanos al Eliminar Palabras#
- El error: Al borrar
"apple", solo marcaris_end_of_word = falseen la letra'e', dejando los nodos en el árbol para siempre. - Por qué falla: Si se insertan y borran millones de palabras en un servidor de producción de larga duración, la memoria del Trie crece sin límite (fuga de memoria silenciosa).
- La solución: Implementar un borrado recursivo (bottom-up) que elimine los nodos hijos si estos se quedan sin descendientes y no forman parte del final de otra palabra.
5. Implementación Canónica en Rust y Comparativa con Python#
Implementación en Rust (practica-rust/dia_47.rs)#
/// Nodo de Trie implementado para Arena basada en vector continuo.
#[derive(Debug, Clone)]
pub struct TrieNode {
    pub children: [Option<usize>; 26],
    pub is_end_of_word: bool,
    pub word_count: usize,
    pub prefix_count: usize,
}

impl TrieNode {
    pub fn new() -> Self {
        Self {
            children: [None; 26],
            is_end_of_word: false,
            word_count: 0,
            prefix_count: 0,
        }
    }
}

/// Árbol de Prefijos (Trie) optimizado con Arena de Nodos en un único `Vec<TrieNode>`.
#[derive(Debug, Clone)]
pub struct Trie {
    nodes: Vec<TrieNode>,
}

impl Trie {
    pub fn new() -> Self {
        let mut trie = Self { nodes: Vec::new() };
        trie.nodes.push(TrieNode::new());
        trie
    }

    pub fn insert(&mut self, word: &str) {
        let mut curr = 0;
        self.nodes[curr].prefix_count += 1;

        for ch in word.chars() {
            let idx = (ch as u8 - b'a') as usize;
            let next = match self.nodes[curr].children[idx] {
                Some(child_idx) => child_idx,
                None => {
                    let new_idx = self.nodes.len();
                    self.nodes.push(TrieNode::new());
                    self.nodes[curr].children[idx] = Some(new_idx);
                    new_idx
                }
            };
            curr = next;
            self.nodes[curr].prefix_count += 1;
        }

        self.nodes[curr].is_end_of_word = true;
        self.nodes[curr].word_count += 1;
    }

    pub fn search(&self, word: &str) -> bool {
        let mut curr = 0;
        for ch in word.chars() {
            let idx = (ch as u8 - b'a') as usize;
            match self.nodes[curr].children[idx] {
                Some(child_idx) => curr = child_idx,
                None => return false,
            }
        }
        self.nodes[curr].is_end_of_word
    }

    pub fn starts_with(&self, prefix: &str) -> bool {
        let mut curr = 0;
        for ch in prefix.chars() {
            let idx = (ch as u8 - b'a') as usize;
            match self.nodes[curr].children[idx] {
                Some(child_idx) => curr = child_idx,
                None => return false,
            }
        }
        true
    }
}
Implementación de Referencia en Python (practica/dia_47_tries_prefix_trees_wildcards.py)#
from typing import Dict, List, Optional


class TrieNode:
    def __init__(self) -> None:
        self.children: Dict[str, TrieNode] = {}
        self.is_end_of_word: bool = False
        self.word_count: int = 0
        self.prefix_count: int = 0


class Trie:
    def __init__(self) -> None:
        self.root = TrieNode()

    def insert(self, word: str) -> None:
        curr = self.root
        curr.prefix_count += 1
        for char in word:
            if char not in curr.children:
                curr.children[char] = TrieNode()
            curr = curr.children[char]
            curr.prefix_count += 1
        curr.is_end_of_word = True
        curr.word_count += 1

    def search(self, word: str) -> bool:
        curr = self.root
        for char in word:
            if char not in curr.children:
                return False
            curr = curr.children[char]
        return curr.is_end_of_word

    def starts_with(self, prefix: str) -> bool:
        curr = self.root
        for char in prefix:
            if char not in curr.children:
                return False
            curr = curr.children[char]
        return True
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En una implementación de Trie en Rust, ¿cuál es la diferencia exacta entre representar los hijos con [Option>; 26] frente a una Arena nodes: Vec con [Option; 26] ?
Respuesta:
- Sobrecarga de Asignador y Punteros: Con
Box<TrieNode>, cada nodo nuevo requiere una llamada independiente al asignador de memoria del sistema (malloc/ jemalloc) dispersando los nodos en direcciones no contiguas del Heap. Esto provoca fallos de caché (cache misses) frecuentes al descender por el árbol. - Localidad Espacial y Vector Único: La Arena almacena todos los nodos en un único buffer contiguo en memoria. Acceder a un hijo mediante
self.nodes[child_idx]aprovecha la precarga de hardware de la CPU. Además, clonar o destruir el árbol completo es una sola operación O(N) trivial sin recorrer puntero por puntero.
Pregunta 2: ¿Por qué en el autocompletado de prefijos (find_words_with_prefix) el recorrido DFS garantiza devolver los resultados en estricto orden alfabético sin necesidad de llamar a una función de ordenamiento externa?
Respuesta:
- Orden topológico intrínseco: En el bucle de exploración DFS, los hijos se recorren en orden ascendente de índice:
0..26, lo que corresponde exactamente a las letras'a','b','c', …,'z'. - Como el recorrido en profundidad visita recursivamente todos los descendientes de la rama
'a'antes de avanzar a la rama'b', las palabras se van descubriendo de forma natural en su orden lexicográfico canónico, ahorrando el costo de ordenar el vector resultante (O(K log K)).
Pregunta 3: ¿Cómo se adapta un Trie para soportar caracteres Unicode arbitrarios (como emojis, acentos o kanjis japoneses) sin desperdiciar gigabytes de memoria en arreglos estáticos gigantes?
Respuesta:
- Solución 1 (Trie sobre Bytes UTF-8): En lugar de ramificar por carácter Unicode (
charde 32 bits, lo que requeriría 2³² hijos por nodo), se ramifica a nivel de bytes UTF-8 individuales (u8). Como cada byte toma valores entre 0 y 255, cada nodo solo necesita 256 hijos. Una letra con tilde como'á'ocupa 2 bytes (0xC3 0xA1), convirtiéndose en un camino de dos saltos. - Solución 2 (Radix Tree / Patricia Trie): Comprimir caminos de nodos no ramificados que tengan un único hijo en una sola arista con una subcadena de longitud variable.
Pregunta 4: En LeetCode 211 (WordDictionary), ¿por qué una consulta compuesta únicamente de puntos comodín (por ejemplo, ".....") puede provocar que el tiempo de ejecución alcance su cota superior exponencial?
Respuesta:
- Factor de ramificación completo: Cada vez que el algoritmo procesa un
.en un nodo que tiene sus 26 hijos ocupados, se bifurca en 26 llamadas recursivas. - Si la palabra mide L = 5 y el Trie está densamente poblado, la cantidad de hojas exploradas es 26⁵ = 11,881,376 caminos posibles. Si bien los nodos vacíos podan la búsqueda de inmediato, un árbol denso sufrirá la explosión combinatoria del algoritmo de fuerza bruta.
Pregunta 5: En el método delete() de un Trie, ¿por qué es insuficiente simplemente decrementar word_count y poner is_end_of_word = false?
Respuesta:
- Fuga de recursos en sistemas de alta disponibilidad: Si un servicio de indexación inserta y borra palabras constantemente (como términos de búsqueda en un motor de e-commerce), dejar los nodos huérfanos sin podar mantiene millones de objetos vacíos en el Heap.
- Estos nodos huérfanos incrementan el tiempo de búsqueda para prefijos no relacionados y saturan la memoria RAM del servidor. La poda bottom-up asegura que la memoria del Trie refleje únicamente las palabras activas.
7. Ejercicios de Práctica Independiente y Casos Límite#
- Paso Límite 1: Palabra que es Prefijo de Otra:
- Inserta
"app"y luego"apple". Verifica quesearch("app")ysearch("apple")retornentrue. Luego borra"apple"y confirma quesearch("app")sigue respondiendotrue. - Paso Límite 2: Búsqueda con Comodín en Palabra Inexistente:
- Con el diccionario conteniendo solo
"bad", busca".a","..d.", y".ad". Asegúrate de que las dos primeras devuelvanfalsey la últimatrue. - Paso Límite 3: Trie de Máximo XOR (LeetCode 421):
- Investiga cómo un Trie binario de 32 bits (donde cada nodo solo tiene dos hijos:
0y1) permite encontrar el par de números con el máximo XOR en un arreglo en tiempo O(N · 32) = O(N).
Navegación final: