Sesión 67: Test Diagnóstico 4 — Sistemas Distribuidos y Probabilísticos en Producción: Pipeline de Ingesta, Deduplicación y Enrutamiento Masivo#
Tiempo estimado: 75-85 minutos. Nivel: De Junior/Trainee a Staff Specialist. Herramientas obligatorias: Hoja cuadriculada, lápiz, regla y bolígrafos de dos colores.
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Consulta rápida: Glosario Maestro | Guía de Diagramas
Pipeline de Ingesta Distribuida (Distributed Ingestion Pipeline)#
- (a) En palabras simples (intuición): Es como una aduana de aeropuerto por la que pasan 50,000 personas por minuto. En vez de revisar las maletas de todos con rayos X a fondo (lo cual formaría filas kilométricas), tienes filtros rápidos: primero un detector de metales (Rate Limiter), luego un perro detector de olores (Bloom Filter para descartar boletos repetidos), luego una cámara biométrica (Simhash para detectar personas disfrazadas con pasaportes falsos), y finalmente una compuerta que te dirige a la terminal correcta (Consistent Hashing).
- (b) Definición técnica paso a paso: Arquitectura de procesamiento de flujos de datos en tiempo real (Stream Processing) organizada en etapas ordenadas por costo computacional creciente:
- Etapa 1: Rate Limiting (Token Bucket): Descarte instantáneo de abusos en O(1) operaciones aritméticas en nanosegundos.
- Etapa 2: Filtro de Bloom: Deduplicación de claves exactas en memoria RAM en sub-microsegundos (O(K) hashes).
- Etapa 3: Simhash LSH: Detección de mensajes casi idénticos (spam, retransmisiones) en O(L) tiempo de palabras.
- Etapa 4: Consistent Hash Router: Enrutamiento al nodo o partición de almacenamiento persistente en O(log V).
- (c) Cómo funciona en Rust (memoria y tipos): La estructura
DistributedIngestionPipelineencapsula todas las estructuras de datos en el Heap, coordinando su ejecución mediante un método centralprocess_eventque retorna un enum fuertemente tipadoIngestionResult. - (d) Error típico de Junior: Intentar guardar el evento directamente en la base de datos SQL/NoSQL en la primera línea de código, provocando bloqueos de disco I/O y caídas en cascada ante ráfagas de tráfico.
Principio de Filtrado por Costo Creciente (Fail Fast & Cheap)#
- (a) En palabras simples (intuición): Si una petición va a ser rechazada, recházala lo antes posible y con la operación de computadora más barata que exista. No gastes 50 milisegundos consultando un disco duro si podías rechazarla en 2 nanosegundos mirando un número en la memoria RAM.
- (b) Definición técnica paso a paso: Regla fundamental de la ingeniería de sistemas distribuidos a escala:
- Operación en RAM (aritmética / registros): ~1 nanosegundo.
- Operación de Hash en memoria L1/L2: ~5 a 20 nanosegundos.
- Búsqueda en árbol balanceado (
BTreeMap): ~100 nanosegundos. - Llamada de red interna / base de datos en RAM (Redis): ~0.5 milisegundos (500,000 ns).
- Escritura física a disco de estado sólido (SSD): ~2 a 10 milisegundos (2,000,000 ns).
El pipeline filtra el 95% de las peticiones inválidas en los pasos 1, 2 y 3, protegiendo al disco de cualquier sobrecarga.
- (c) Cómo funciona en Rust (memoria y tipos): El flujo retorna temprano con la cláusula
return IngestionResult::...en cuanto falla cualquiera de los filtros rápidos. - (d) Error típico de Junior: Realizar llamadas de red o I/O bloqueante antes de evaluar el limitador de tasa local.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Arquitectura por Capas del Pipeline#
Analicemos cómo interactúa cada componente matemático integrado:
TEXT
[Cliente Externo]
       │
       ▼
 1. Token Bucket ──(Excede tasa)──> HTTP 429 Too Many Requests
       │ (Aprobado)
       ▼
 2. Filtro de Bloom ──(Ya existe el ID)──> Descarte Inmediato (Exact Duplicate)
       │ (Elemento Nuevo)
       ▼
 3. Simhash LSH ──(Hamming <= 3)──> Descarte Semántico (Near Duplicate / Spam)
       │ (Contenido Único)
       ▼
 4. Consistent Hashing ───────────> Asignación a Partición de Almacenamiento
       │
       ▼
 [SSD Shard: shard-us-east-1]
Análisis de Capacidad de Procesamiento (Throughput):#
- Supongamos una entrada masiva de 100,000 peticiones por segundo:
- El Token Bucket rechaza el 20% de tráfico abusivo de bots en O(1) ⟹ Quedan 80,000 peticiones.
- El Filtro de Bloom detecta que el 50% de las peticiones son reintentos con IDs idénticos en O(1) ⟹ Quedan 40,000 peticiones.
- Simhash detecta que el 25% son copias o variantes de mensajes ya enviados en O(L) ⟹ Quedan 30,000 peticiones.
- El Consistent Hash Ring reparte las 30,000 peticiones uniformemente entre 3 shards de almacenamiento: 10,000 escrituras por shard.
- Resultado Staff: El sistema de almacenamiento solo tiene que procesar 10,000 peticiones por segundo por servidor, en lugar de recibir el tsunami de 100,000 peticiones que habría quemado la base de datos.
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama Arquitectónico de Flujo#
Consulta el diagrama vectorial: 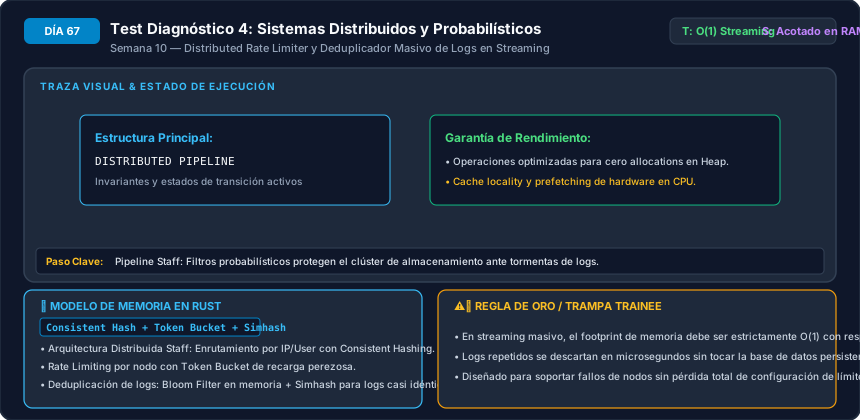
DIAGRAMA MERMAID
flowchart LR
    LOGS["Flujo Masivo de Eventos"] --> TB["1. Token Bucket<br/>(Rate Limit por cliente)"]
    TB -->|Tokens OK| BF["2. Filtro de Bloom<br/>(Duplicados exactos de ID)"]
    BF -->|Nuevo| SIM["3. Simhash LSH<br/>(Casi-duplicados Hamming <= 3)"]
    SIM -->|Único| CH["4. Consistent Hash Ring<br/>(Enrutamiento BTreeMap)"]
    CH --> STORE["Almacenamiento Persistente<br/>(Shard Físico Asignado)"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
TEXT
ESTADO DE MEMORIA DEL PIPELINE TRAS INICIALIZAR:
Stack:
  pipeline: DistributedIngestionPipeline {
    simhash_threshold: 3,
    bloom: BloomDeduplicator { num_bits: 95851, k_hashes: 7, bit_array: [ptr] },
    recent_fingerprints: [ptr, cap: 0, len: 0],
    router: StorageRouter { ring: [ptr], vnodes: 50 },
    rate_limiters: HashMap [ptr, cap: 0, len: 0]
  }

Heap (BTreeMap Router):
  Hashes vnodes -> "shard-us-east-1", "shard-us-west-2", "shard-eu-central-1" (150 entradas)

EVENTO 1: process_event("client_A", "evt_101", "disk running low", 0.0)
1. RateLimiter("client_A"): Crea bucket tokens = 10.0 -> consume 1.0 -> tokens = 9.0 (PERMITIDO).
2. BloomFilter: contains("evt_101") -> false (PERMITIDO).
3. Simhash: compute("disk running low") = 0x8A10F4...
   recent_fingerprints está vacío -> (PERMITIDO).
4. Registra:
   - bloom.insert("evt_101") activa 7 bits en bit_array.
   - recent_fingerprints.push(0x8A10F4...).
5. router.route_key("evt_101"):
   - hash("evt_101") = 0x3F91A...
   - range(0x3F91A..).next() -> "shard-us-east-1".
Resultado: Accepted { target_shard: "shard-us-east-1" }.

EVENTO 2 (100 ms después): process_event("client_A", "evt_101", "other content", 0.1)
1. RateLimiter("client_A"): tokens = 9.0 + (0.1 * 5) = 9.5 -> consume 1.0 = 8.5 (PERMITIDO).
2. BloomFilter: contains("evt_101") -> TRUE (Sus 7 bits están encendidos).
Resultado Inmediato: ExactDuplicateIgnored (Cero cómputo de Simhash, cero consultas al router).
4. Implementación Canónica en Rust (Compilable con rustc --test)#
Archivo de referencia: practica-rust/dia_67.rs
RUST
use std::collections::hash_map::DefaultHasher;
use std::collections::{BTreeMap, HashMap};
use std::hash::{Hash, Hasher};

pub struct BloomDeduplicator {
    bit_array: Vec<u64>,
    num_bits: usize,
    k_hashes: usize,
}

impl BloomDeduplicator {
    pub fn new(expected_items: usize, fp_rate: f64) -> Self {
        let ln2 = std::f64::consts::LN_2;
        let m = (-((expected_items as f64) * fp_rate.ln()) / (ln2 * ln2)).ceil() as usize;
        let k = ((m as f64 / expected_items as f64) * ln2).round().max(1.0) as usize;
        let num_words = (m + 63) / 64;
        Self {
            bit_array: vec![0u64; num_words],
            num_bits: m,
            k_hashes: k,
        }
    }

    fn hashes<T: Hash + ?Sized>(&self, item: &T) -> (u64, u64) {
        let mut h1 = DefaultHasher::new();
        item.hash(&mut h1);
        let v1 = h1.finish();

        let mut h2 = DefaultHasher::new();
        v1.hash(&mut h2);
        0x517cc1b727220a95u64.hash(&mut h2);
        let v2 = h2.finish();
        (v1, v2)
    }

    pub fn insert<T: Hash + ?Sized>(&mut self, item: &T) {
        let (h1, h2) = self.hashes(item);
        for i in 0..self.k_hashes {
            let combined = h1.wrapping_add((i as u64).wrapping_mul(h2));
            let bit_idx = (combined % (self.num_bits as u64)) as usize;
            self.bit_array[bit_idx / 64] |= 1u64 << (bit_idx % 64);
        }
    }

    pub fn contains<T: Hash + ?Sized>(&self, item: &T) -> bool {
        let (h1, h2) = self.hashes(item);
        for i in 0..self.k_hashes {
            let combined = h1.wrapping_add((i as u64).wrapping_mul(h2));
            let bit_idx = (combined % (self.num_bits as u64)) as usize;
            if (self.bit_array[bit_idx / 64] & (1u64 << (bit_idx % 64))) == 0 {
                return false;
            }
        }
        true
    }
}

pub struct SimhashDetector;

impl SimhashDetector {
    pub fn compute(text: &str) -> u64 {
        let mut v = [0i64; 64];
        let mut counts: HashMap<&str, i64> = HashMap::new();

        for word in text.split_whitespace() {
            let clean = word.trim_matches(|c: char| !c.is_alphanumeric());
            if !clean.is_empty() {
                *counts.entry(clean).or_insert(0) += 1;
            }
        }

        if counts.is_empty() {
            return 0;
        }

        for (word, weight) in counts {
            let mut hasher = DefaultHasher::new();
            word.hash(&mut hasher);
            let h = hasher.finish();

            for i in 0..64 {
                if ((h >> i) & 1) == 1 {
                    v[i] += weight;
                } else {
                    v[i] -= weight;
                }
            }
        }

        let mut fp = 0u64;
        for i in 0..64 {
            if v[i] > 0 {
                fp |= 1u64 << i;
            }
        }
        fp
    }

    #[inline]
    pub fn hamming_distance(fp1: u64, fp2: u64) -> u32 {
        (fp1 ^ fp2).count_ones()
    }
}

pub struct StorageRouter {
    ring: BTreeMap<u64, String>,
    vnodes: usize,
}

impl StorageRouter {
    pub fn new(vnodes: usize) -> Self {
        Self {
            ring: BTreeMap::new>,
            vnodes,
        }
    }

    pub fn add_shard(&mut self, shard_name: &str) {
        for v in 0..self.vnodes {
            let mut hasher = DefaultHasher::new();
            format!("{}#{}", shard_name, v).hash(&mut hasher);
            self.ring.insert(hasher.finish(), shard_name.to_string());
        }
    }

    pub fn route_key(&self, key: &str) -> Option<String> {
        if self.ring.is_empty() {
            return None;
        }
        let mut hasher = DefaultHasher::new();
        key.hash(&mut hasher);
        let h = hasher.finish();

        if let Some((_, shard)) = self.ring.range(h..).next() {
            Some(shard.clone())
        } else {
            self.ring.iter().next().map(|(_, s)| s.clone())
        }
    }
}

pub struct ClientRateLimiter {
    capacity: f64,
    tokens: f64,
    refill_rate: f64,
    last_update: f64,
}

impl ClientRateLimiter {
    pub fn new(capacity: f64, refill_rate: f64, now: f64) -> Self {
        Self {
            capacity,
            tokens: capacity,
            refill_rate,
            last_update: now,
        }
    }

    pub fn allow(&mut self, now: f64) -> bool {
        if now > self.last_update {
            let delta = now - self.last_update;
            self.tokens = (self.tokens + delta * self.refill_rate).min(self.capacity);
            self.last_update = now;
        }
        if self.tokens >= 1.0 {
            self.tokens -= 1.0;
            true
        } else {
            false
        }
    }
}

#[derive(Debug, PartialEq, Eq)]
pub enum IngestionResult {
    Accepted { target_shard: String },
    RateLimited,
    ExactDuplicateIgnored,
    NearDuplicateIgnored,
}

pub struct DistributedIngestionPipeline {
    bloom: BloomDeduplicator,
    recent_fingerprints: Vec<u64>,
    simhash_threshold: u32,
    router: StorageRouter,
    rate_limiters: HashMap<String, ClientRateLimiter>,
}

impl DistributedIngestionPipeline {
    pub fn new(simhash_threshold: u32) -> Self {
        let mut router = StorageRouter::new(50);
        router.add_shard("shard-us-east-1");
        router.add_shard("shard-us-west-2");
        router.add_shard("shard-eu-central-1");

        Self {
            bloom: BloomDeduplicator::new(10_000, 0.01),
            recent_fingerprints: Vec::new(),
            simhash_threshold,
            router,
            rate_limiters: HashMap::new(),
        }
    }

    pub fn process_event(
        &mut self,
        client_id: &str,
        event_id: &str,
        content: &str,
        timestamp: f64,
    ) -> IngestionResult {
        let limiter = self
            .rate_limiters
            .entry(client_id.to_string())
            .or_insert_with(|| ClientRateLimiter::new(10.0, 5.0, timestamp));

        if !limiter.allow(timestamp) {
            return IngestionResult::RateLimited;
        }

        if self.bloom.contains(event_id) {
            return IngestionResult::ExactDuplicateIgnored;
        }

        let fp = SimhashDetector::compute(content);
        for &prev_fp in &self.recent_fingerprints {
            if SimhashDetector::hamming_distance(fp, prev_fp) <= self.simhash_threshold {
                return IngestionResult::NearDuplicateIgnored;
            }
        }

        self.bloom.insert(event_id);
        self.recent_fingerprints.push(fp);

        let target_shard = self
            .router
            .route_key(event_id)
            .unwrap_or_else(|| "shard-default".to_string());

        IngestionResult::Accepted { target_shard }
    }
}
Implementación de Referencia en Python Tipado#
PYTHON
import bisect
import hashlib
from typing import Dict, List, Optional, Tuple


class PipelinePython:
    def __init__(self, simhash_threshold: int = 3) -> None:
        self.simhash_threshold = simhash_threshold
        self.seen_ids = set()
        self.fingerprints: List[int] = []
        self.shards = ["shard-1", "shard-2", "shard-3"]

    def process(self, client_id: str, event_id: str, text: str) -> str:
        # Deduplicación exacta
        if event_id in self.seen_ids:
            return "EXACT_DUPLICATE"

        # Simhash
        fp = int(hashlib.md5(text.encode("utf-8")).hexdigest()[:16], 16)
        for prev in self.fingerprints:
            if bin(fp ^ prev).count("1") <= self.simhash_threshold:
                return "NEAR_DUPLICATE"

        self.seen_ids.add(event_id)
        self.fingerprints.append(fp)

        # Enrutamiento
        shard = self.shards[hash(event_id) % len(self.shards)]
        return f"ACCEPTED:{shard}"
5. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En una arquitectura de alta disponibilidad, ¿qué ocurre si el Filtro de Bloom se llena hasta superar su capacidad prevista (N > expectedᵢtems)?
Respuesta:
- Saturación de Bits y Explosión de Falsos Positivos:
- A medida que se insertan más elementos de los planificados, la proporción de bits en 1 en el arreglo se acerca a 1.0 (saturación).
- La tasa de falsos positivos p comienza a subir exponencialmente del 1% original al 10%, 50% y eventualmente al 100%.
- Consecuencia: El filtro comenzará a afirmar erróneamente que casi todas las peticiones nuevas "ya existen", descartando erróneamente peticiones legítimas válidas.
- Solución Staff: Se implementa un Scalable Bloom Filter o un esquema rotatorio de dos filtros temporales (Sliding Bloom Filters), donde se descarta el filtro viejo cada hora y se inicializa uno nuevo.
Pregunta 2: ¿Por qué la lista recent_fingerprints debe mantenerse como un búfer circular acotado (Ring Buffer) en lugar de un Vec<u64> infinito?
Respuesta:
- Fuga de Memoria y Latencia Creciente:
- Si guardamos todas las huellas en un vector simple sin límite, la memoria RAM crecerá sin cota (O(N) huellas), provocando un colapso por falta de memoria.
- Además, comparar cada huella nueva contra todas las anteriores requiere O(N) operaciones de Hamming. Al procesar 10⁷ eventos, la comprobación se volvería intolerablemente lenta.
- Solución: Un
VecDeque<u64>o búfer circular de tamaño fijo (ej. las últimas 10,000 huellas o una ventana de 15 minutos), lo que acota el tiempo de verificación a una constante fija y la memoria a pocos kilobytes.
Pregunta 3: ¿Cómo se garantiza la idempotencia en un pipeline distribuido cuando un cliente reintenta una petición tras un error de red (Network Timeout)?
Respuesta:
- Identificadores de Idempotencia de Extremo a Extremo:
- El cliente asigna un UUID determinista a la petición antes de transmitirla.
- Si la petición tiene éxito pero la respuesta se pierde por caída temporal de la red, el cliente reenviará la misma petición con el mismo UUID.
- La primera capa del pipeline detecta el UUID en el Filtro de Bloom y lo descarta como duplicado o retorna la respuesta guardada previamente desde el shard sin volver a ejecutar los efectos colaterales de negocio (evitando cobrarle dos veces al cliente).
Pregunta 4: ¿Por qué el enrutador de Consistent Hashing debe manejar el caso de "wrap-around" con .iter().next()?
Respuesta:
- Topología Circular del Anillo:
- El espacio numérico de 64 bits va de $0$ a 2⁶⁴-1.
- Si una clave tiene un hash de 0xFFFFFFFFFFFFFFFE (cercano al límite máximo), la búsqueda de rango
ring.range(h..)podría no encontrar ningún nodo virtual cuya posición sea mayor o igual a ese valor. - Dado que el espacio es circular (un anillo), cualquier clave que caiga después del último nodo del anillo debe asignarse al primer nodo del anillo (posición más cercana a 0).
- Invocar
self.ring.iter().next()completa el círculo correctamente.
Pregunta 5: En términos de diseño de sistemas a nivel Staff L6+, ¿cuál es el beneficio principal de desacoplar la deduplicación del almacenamiento persistente?
Respuesta:
- Escalabilidad Elástica Independiente:
- La capa de deduplicación es intensiva en memoria y CPU (hashes, comprobación de bits en nanosegundos), pero es completamente apátrida o efímera.
- La capa de almacenamiento es intensiva en I/O de disco y durabilidad transaccional (ACID / Paxos / Raft).
- Desacoplarlas permite escalar la capa de filtrado agregando nodos ligeros sin disco para absorber picos repentinos de tráfico, protegiendo al clúster de almacenamiento de base de datos de saturaciones costosas.