07 · PostgreSQL: invariantes y transacciones#
Objetivo#
Al terminar esta lección podrás diseñar esquemas de bases de datos relacionales en PostgreSQL que garanticen la integridad de los datos a nivel físico y durable, escribir consultas parametrizadas seguras que impidan la inyección SQL a nivel de compilación del AST, y razonar con precisión milimétrica sobre las condiciones de carrera concurrentes (TOCTOU). Comprenderás qué anomalías previenen y cuáles permiten los distintos niveles de aislamiento transaccional bajo ACID, y aprenderás a justificar la creación de índices B-Tree basándote en planes de ejecución y midiendo el costo de amplificación de escritura.
Antes de empezar#
- Completa las lecciones de modelado de tipos,
Resulty contratos HTTP. - Los ejemplos de esquemas DDL y sentencias DML presentados en esta lección son código SQL estándar para PostgreSQL 14+. Para ejecutarlos en un entorno local, requieres una instancia de PostgreSQL en ejecución o una herramienta cliente como
psql, DBeaver o pgAdmin. - Si estás trabajando sin base de datos instalada, el análisis conceptual, las trazas de tiempo milisegundo a milisegundo y las matrices de diseño de esquemas te permitirán dominar los fundamentos antes de la práctica en laboratorio.
- Si encuentras algún concepto técnico desconocido, consulta el glosario técnico.
Diccionario de conceptos de la lección (Glosario desde cero)#
1. Invariante relacional / durable#
- Intuición cotidiana: Las reglas de la física en un edificio: dos objetos sólidos no pueden ocupar el mismo espacio al mismo tiempo, y el techo no puede flotar si las columnas de soporte colapsan. No importa qué hagan los inquilinos adentro, las leyes de la física se imponen sin excepción.
- Definición técnica precisa: Condición de consistencia o regla de integridad lógica que debe cumplirse obligatoriamente en todo momento sobre los datos persistidos en el almacenamiento no volátil. A diferencia de las validaciones en la memoria RAM del servidor de aplicaciones (que se desvanecen si el proceso se reinicia o ante concurrencia desordenada), un invariante relacional es exigido directamente por el motor de base de datos (
PostgreSQL) sobre el disco y el archivo de transacciones (Write-Ahead Logging). - Ejemplo en SQL:
CONSTRAINT check_positive_price CHECK (price_cents > 0)- Concepción errónea: Creer que validar los datos en el frontend o en el backend de Rust hace innecesarias las restricciones en la base de datos. Si dos servidores de aplicaciones escriben al mismo tiempo, o si un administrador ejecuta un script de migración manual, la falta de restricciones relacionales corromperá el estado irremediablemente.
2. Transacción y propiedades ACID (WAL)#
- Intuición cotidiana: Una transferencia bancaria: se retira dinero de tu cuenta y se deposita en la de un amigo. Si el sistema eléctrico se apaga exactamente a la mitad, el dinero no puede evaporarse ni multiplicarse: o ambas operaciones quedan confirmadas para siempre, o ninguna ocurrió y tu dinero vuelve intacto a tu saldo.
- Definición técnica precisa: Unidad lógica de trabajo atómica compuesta por una o varias sentencias SQL delimitadas entre
BEGINyCOMMIT(oROLLBACK). Cumple las cuatro propiedades ACID: - *A (Atomicity - Atomicidad):* O se ejecutan todas las operaciones con éxito, o el motor revierte la totalidad de los cambios. No existe el estado parcial.
- *C (Consistency - Consistencia):* La transacción solo puede mover la base de datos de un estado válido a otro estado válido, satisfaciendo todas las restricciones declarativas (
UNIQUE,CHECK,FOREIGN KEY). - *I (Isolation - Aislamiento):* Las operaciones concurrentes no interfieren entre sí de forma impredecible. El grado de visibilidad de datos no confirmados depende del nivel de aislamiento configurado.
- *D (Durability - Durabilidad): Una vez que el servidor responde con éxito al
COMMIT, los datos quedan garantizados contra cortes de energía o caídas del sistema operativo. Esto se logra escribiendo primero los cambios secuencialmente en el registro de escritura adelantada (WAL - Write-Ahead Logging*) antes de sincronizar los bloques de datos principales en disco. - Ejemplo en SQL:
  BEGIN;
  UPDATE accounts SET balance = balance - 100 WHERE id = 1;
  UPDATE accounts SET balance = balance + 100 WHERE id = 2;
COMMIT;- Concepción errónea: Creer que un simple bloque
BEGIN ... COMMITpreviene mágicamente todas las condiciones de carrera concurrentes sin configurar niveles de aislamiento o restricciones explícitas.
3. Restricciones declarativas (PRIMARY KEY, NOT NULL, UNIQUE, CHECK, FOREIGN KEY)#
- Intuición cotidiana: Los candados y cerrojos instalados de fábrica en una caja fuerte: una cerradura que exige llave única (
PRIMARY KEY), una compuerta que no permite vacíos (NOT NULL), un sensor que impide duplicar la misma huella dactilar (UNIQUE), una báscula que rechaza paquetes que pesen cero kilos (CHECK), y una cadena que ata la caja al suelo del banco (FOREIGN KEY). - Definición técnica precisa: Reglas del modelo relacional declaradas en el DDL (Data Definition Language) que el motor de PostgreSQL verifica automáticamente en cada inserción, modificación o borrado de tuplas:
PRIMARY KEY: Identificador único inmutable de la fila. ImplicaUNIQUEyNOT NULLe implementa internamente un índice B-Tree único.NOT NULL: Prohíbe el valorNULLen la columna a nivel de catálogo relacional.UNIQUE: Garantiza que ningún valor no nulo aparezca repetido en la columna (o combinación de columnas). Crea automáticamente un índice B-Tree único subyacente.CHECK: Expresión booleana arbitraria que debe evaluar aTRUEoUNKNOWNpara cada fila (CHECK (length(trim(title)) > 0)).FOREIGN KEY: Integridad referencial que exige que el valor de una columna exista obligatoriamente como clave en otra tabla referenciada, impidiendo filas huérfanas mediante políticas comoON DELETE RESTRICToON DELETE CASCADE.- Ejemplo en SQL:
  CREATE TABLE tasks (
      id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
      user_id BIGINT NOT NULL REFERENCES users(id) ON DELETE RESTRICT,
      external_key TEXT NOT NULL UNIQUE,
      title TEXT NOT NULL CHECK (length(trim(title)) > 0)
);- Concepción errónea: Pensar que las restricciones degradan el rendimiento y que deben omitirse para "acelerar las inserciones masivas". El costo de verificar un índice B-Tree en memoria es insignificante comparado con el desastre económico de reparar datos inconsistentes o duplicados en producción.
4. Condición de carrera TOCTOU (Time-Of-Check to Time-Of-Use) e Intercalado (Interleaving)#
- Intuición cotidiana: Dos personas que ven el último boleto de cine disponible en sus teléfonos al mismo tiempo. Ambas pantallas dicen "Boleto libre" (verificación - Check). Ambas pulsan "Comprar" un segundo después (uso - Use). Si la taquilla no tiene un candado único central, ambos creerán haber comprado el mismo asiento y habrá una pelea en la sala.
- Definición técnica precisa: Vulnerabilidad y defecto de concurrencia donde existe una ventana temporal entre el momento en que una transacción verifica una condición (
SELECT COUNT(*) == 0) y el momento en que ejecuta la acción basada en esa verificación (INSERT INTO ...). Durante esa brecha de tiempo, otra transacción concurrente modifica el estado subyacente, haciendo que la premisa original ya no sea válida. - Ejemplo en pseudocódigo vulnerable:
  // Hilo A: SELECT count(*) WHERE key = 'K' -> retorna 0
  // Hilo B: SELECT count(*) WHERE key = 'K' -> retorna 0
  // Hilo A: INSERT key = 'K' -> Éxito
// Hilo B: INSERT key = 'K' -> Duplicado generado (si no hay restricción UNIQUE)- Concepción errónea: Asumir que poner el
SELECTy elINSERTdentro de una transacción por defecto (READ COMMITTED) evita el problema. EnREAD COMMITTED, elSELECTsolo lee lo confirmado hasta ese instante y no bloquea a otras transacciones de insertar la misma clave.
5. Niveles de aislamiento (Isolation Levels)#
- Intuición cotidiana: Qué tan aislado estás en tu oficina:
- Read Committed: La puerta está abierta; puedes ver los documentos de los demás en cuanto los colocan en el pasillo.
- Repeatable Read: Tomas una fotografía panorámica al entrar a trabajar; durante todo el día solo ves los documentos tal como estaban en esa fotografía original.
- Serializable: Trabajas en un cubículo blindado donde el supervisor solo permite que tus acciones se aprueben si el resultado final es indistinguible de haber trabajado tú completamente solo en todo el edificio.
- Definición técnica precisa: Modos de operación del motor de concurrencia MVCC (Multi-Version Concurrency Control) de PostgreSQL que controlan qué datos son visibles para una transacción y qué anomalías se previenen:
READ COMMITTED(por defecto en PostgreSQL): Cada consulta dentro de la transacción ve una nueva instantánea (snapshot) de los datos confirmados antes del inicio de esa consulta individual. Previene lecturas sucias (dirty reads), pero permite lecturas no repetibles (non-repeatable reads) y lecturas fantasma (phantom reads).REPEATABLE READ: Toda la transacción opera sobre la misma instantánea tomada al ejecutar la primera consulta. Si otra transacción confirma cambios mientras esta corre, no serán visibles. Si dos transacciones intentan actualizar la misma fila, la segunda aborta con error de serialización (40001).SERIALIZABLE: El nivel más estricto. Utiliza SSI (Serializable Snapshot Isolation). Detecta dependencias de lectura y escritura entre transacciones concurrentes (ciclos en el grafo de serialización). Si se detecta un posible conflicto de ordenación, el motor aborta inmediatamente una de las transacciones con código SQLSTATE40001, exigiendo al cliente reintentar.- Tabla de anomalías según ANSI SQL vs PostgreSQL:
| Nivel de aislamiento | Lectura sucia (Dirty Read) | Lectura no repetible | Lectura fantasma (Phantom Read) | Conflicto de escritura serial |
|---|---|---|---|---|
READ COMMITTED | Imposible en Postgres | Posible | Posible | Posible |
REPEATABLE READ | Imposible | Imposible | Imposible en Postgres | Posible (aborta con 40001) |
SERIALIZABLE | Imposible | Imposible | Imposible | Imposible (aborta con 40001) |
- Concepción errónea: Pensar que
SERIALIZABLEhace el sistema lento por usar bloqueos globales pesados de tablas. PostgreSQL implementa SSI mediante bloqueos de predicado en memoria (SIREAD locks) que no bloquean lecturas ni escrituras, sino que rastrean conflictos y abortan únicamente si detectan inconsistencia temporal.
6. Consulta parametrizada ($1, $2) vs Inyección SQL#
- Intuición cotidiana:
- Inyección SQL: Dejar que un pasajero escriba con marcador permanente en el tablero de control del avión. Si escribe "APAGAR MOTORES", el avión se estrella porque el sistema cree que era una orden de vuelo.
- Consulta parametrizada: Darle al pasajero un formulario de papel donde solo puede escribir su nombre. El nombre se coloca en un casillero cerrado; el piloto jamás confunde el nombre del pasajero con una orden de vuelo.
- Definición técnica precisa:
- Inyección SQL: Vulnerabilidad crítica (CWE-89) provocada por concatenar o interpolar texto sin sanitizar directamente dentro de la cadena SQL. Un atacante introduce comillas y palabras clave (
' OR 1=1; DROP TABLE tasks; --), alterando la gramática sintáctica de la consulta. - *Consulta parametrizada (Prepared Statement / Parameterized Query): Protocolo binario de base de datos donde la estructura sintáctica de la consulta se envía primero al servidor para ser analizada, compilada y optimizada en un Árbol de Sintaxis Abstracta (AST - Abstract Syntax Tree), con marcadores de posición tipados (
$1,$2). Posteriormente, los valores de los parámetros se transmiten fuera de banda como datos crudos. Es físicamente imposible que un valor parametrizado altere el AST de la consulta compilada*, sin importar los caracteres que contenga. - Ejemplo en Rust con SQLx conceptual:
  // SEGURO: Parámetros compilados y transmitidos fuera de banda
  sqlx::query!("SELECT id FROM tasks WHERE external_key = $1", untrusted_input);

  // VULNERABLE: Concatenación directa de texto
// format!("SELECT id FROM tasks WHERE external_key = '{}'", untrusted_input);- Concepción errónea: Creer que sanitizar o "escapar comillas" con expresiones regulares es equivalente a parametrizar. Los atacantes explotan codificaciones de caracteres no estándar, bytes nulos y trucos de codificación UTF-8 que eluden fácilmente las funciones de escape manuales.
7. Código SQLSTATE (ej. 23505 unique_violation, 40001 serialization_failure)#
- Intuición cotidiana: El código internacional de averías de un motor automotriz (ej. "P0300 - Fallo de encendido en cilindro"). No depende del idioma del mecánico ni de si el manual está en inglés o español: el código numérico alfanumérico identifica con precisión el subsistema que falló.
- Definición técnica precisa: Código estandarizado de 5 caracteres alfanuméricos definido por el estándar ANSI SQL que clasifica unívocamente el resultado o la condición de fallo de una sentencia SQL. Los dos primeros caracteres indican la clase general y los tres siguientes la subclase:
- Clase
23: Violación de restricción de integridad (Integrity Constraint Violation). 23505:unique_violation(se violó un índice o restricciónUNIQUEoPRIMARY KEY).23502:not_null_violation.23503:foreign_key_violation.23514:check_violation.- Clase
40: Retroceso de transacción (Transaction Rollback). 40001:serialization_failure(conflicto enREPEATABLE READoSERIALIZABLE; la transacción debe reintentarse).40P01:deadlock_detected.- Ejemplo en Rust:
  if let Some(db_err) = err.as_database_error() {
      if db_err.code() == Some(std::borrow::Cow::Borrowed("23505")) {
          return HttpResponse::Conflict().json("resource already exists");
      }
}- Concepción errónea: Analizar el texto del mensaje de error (
if err.contains("duplicate key")) mediante comparación de cadenas. Si el motor cambia de idioma local o la biblioteca actualiza el texto de error, tu lógica de control de errores se romperá silenciosamente.
8. Índice B-Tree y plan de ejecución (EXPLAIN ANALYZE)#
- Intuición cotidiana:
- Sin índice: Buscar una palabra en un diccionario de 1000 páginas leyendo cada una de las páginas desde la primera hasta la última (escaneo secuencial).
- Con índice B-Tree: Ir directamente al índice alfabético en el borde del libro: abres la letra "T", luego la sección "Ta", y en tres movimientos de página encuentras la palabra exacta.
- Costo de mantenimiento: Si decides agregar una nueva palabra al diccionario físico, tienes que borrar y mover todas las palabras siguientes para hacer espacio y reescribir el índice de páginas.
- Definición técnica precisa:
- *Índice B-Tree (Balanced Tree):* Estructura de datos auto-balanceada en árbol multinivel organizada en páginas de disco de 8 KB. Las claves se mantienen ordenadas, permitiendo búsquedas de igualdad y de rango en complejidad logarítmica O(log N).
- Plan de ejecución (
EXPLAIN ANALYZE): Comando que ejecuta la consulta en el motor y reporta la ruta física real tomada por el optimizador de costos (Query Planner), mostrando si utilizó un escaneo secuencial (Seq Scan), un escaneo por índice (Index Scan) o un escaneo de solo índice (Index Only Scan), junto con los milisegundos reales y el conteo de bloques de disco leídos (Buffers). - *Amplificación de escritura (Write Amplification): Cada índice adicional definido sobre una tabla acelera las lecturas pero ralentiza cada
INSERT,UPDATEyDELETE. Por cada nueva fila insertada, el motor debe escribir la tupla en la tabla (heap page) y además descender e insertar la clave en todos y cada uno de los árboles B-Tree de la tabla, provocando divisiones de página (page splits*) y escrituras adicionales en el log de transacciones (WAL). - Ejemplo en SQL:
  EXPLAIN (ANALYZE, BUFFERS)
SELECT title FROM tasks WHERE external_key = 'TASK-101';- Concepción errónea: Pensar que "poner índices en todas las columnas por si acaso" es una buena práctica. Una tabla sobre-indexada sufre una degradación severa en el rendimiento de escritura y desperdicia memoria RAM en el buffer pool del servidor.
Modelo mental y arquitectura profunda#
Trazabilidad milisegundo a milisegundo: la carrera TOCTOU#
Veamos con precisión cronológica por qué la verificación en la capa de aplicación (SELECT COUNT(*)) falla catastróficamente ante dos solicitudes simultáneas, y cómo la restricción UNIQUE en PostgreSQL resuelve el arbitraje de manera atómica:
sequenceDiagram
    autonumber
    participant A as Hilo Servidor A
    participant B as Hilo Servidor B
    participant DB as PostgreSQL (Motor MVCC / B-Tree)

    Note over A,B: Ambas peticiones intentan registrar external_key = 'KEY-42'

    A->>DB: [t=0ms] BEGIN (READ COMMITTED)
    B->>DB: [t=1ms] BEGIN (READ COMMITTED)

    A->>DB: [t=2ms] SELECT COUNT(*) FROM tasks WHERE external_key = 'KEY-42'
    DB-->>A: [t=3ms] count = 0 (No existe)

    B->>DB: [t=4ms] SELECT COUNT(*) FROM tasks WHERE external_key = 'KEY-42'
    DB-->>B: [t=5ms] count = 0 (No existe visible aún)

    Note over A: [t=6ms] Servidor A valida: "count == 0, es seguro insertar"
    Note over B: [t=7ms] Servidor B valida: "count == 0, es seguro insertar"

    A->>DB: [t=8ms] INSERT INTO tasks (external_key, title) VALUES ('KEY-42', 'Task A')
    Note over DB: [t=9ms] DB escribe tupla de A e inserta 'KEY-42' en el índice B-Tree

    B->>DB: [t=10ms] INSERT INTO tasks (external_key, title) VALUES ('KEY-42', 'Task B')
    Note over DB: [t=11ms] DB detecta conflicto en el índice B-Tree. El hilo B queda bloqueado esperando la resolución de la transacción A.

    A->>DB: [t=12ms] COMMIT
    Note over DB: [t=13ms] Transacción A confirmada definitivamente en WAL.

    Note over DB: [t=14ms] DB reanuda hilo B: la clave 'KEY-42' ya está confirmada.
    DB-->>B: [t=15ms] ERROR 23505: duplicate key value violates unique constraint "tasks_external_key_key"

    Note over B: [t=16ms] Servidor B captura error 23505 y mapea a HTTP 409 Conflict
Por qué el software de aplicación no puede resolver esta carrera por sí solo: En el milisegundo t=4ms, la transacción A no ha confirmado su escritura. Bajo el aislamiento READ COMMITTED (y también bajo REPEATABLE READ), la transacción B no puede ver los cambios de A porque violaría la regla de aislamiento. Ambas transacciones concluyen lógicamente que "la clave no existe".
La única entidad con autoridad para resolver la carrera es el motor de almacenamiento de PostgreSQL en el milisegundo t=11ms, porque el índice B-Tree impone una cerradura atómica (latch) sobre la página de memoria donde debe residir la clave. Al intentar insertar un duplicado confirmado, el motor aborta la operación de B con el código SQLSTATE 23505.
Cómo las consultas parametrizadas separan el AST del valor binario#
Comprender la separación física entre la gramática de la consulta y sus datos es la base de la seguridad moderna:
flowchart TD
    subgraph InjectionVuln["Consulta Concatenada (VULNERABLE)"]
        RawStr["Cadena: 'SELECT * FROM users WHERE name = '' + input + '''"] --> SingleParser[Parser SQL analiza texto completo]
        AttackerInput["Input: 'admin'' OR ''1''=''1'"] --> RawStr
        SingleParser --> CorruptedAST["AST Corrompido: BinaryExpr (OR: '1'=='1')"]
        CorruptedAST --> UnauthorizedExec[Ejecuta lógica arbitraria del atacante]
    end

    subgraph ParamSec["Consulta Parametrizada (SEGURO)"]
        QueryTemplate["Plantilla: 'SELECT * FROM users WHERE name = $1'"] --> QueryParser[Parser SQL compila estructura]
        QueryParser --> StrictAST["AST Inmutable: Node(VarRef: $1)"]
        StrictAST --> Optimizer[Optimizador genera Plan de Ejecución]

        RawBinaryData["Datos: 'admin'' OR ''1''=''1'"] --> WireParam[Parámetro binario fuera de banda]
        Optimizer --> ExecutionEngine[Motor de Ejecución vincula parámetro]
        WireParam --> ExecutionEngine
        ExecutionEngine --> SafeExec["Busca literalmente el nombre de usuario 'admin'' OR ''1''=''1'"]
    end
Al utilizar una consulta parametrizada con $1, el motor de base de datos recibe dos mensajes separados en el cable mediante el protocolo extendido de PostgreSQL (Extended Query Protocol):
- Mensaje
Parse: Envía la cadena de la consulta con marcadores de posición$1. El motor genera el AST validando tablas y permisos. - Mensaje
Bind: Envía los valores de los parámetros en formato binario. El motor inyecta los valores en las posiciones de memoria del plan sin volver a invocar el parser sintáctico.
Diagrama#
sequenceDiagram
    participant A as Solicitud A
    participant B as Solicitud B
    participant DB as PostgreSQL
    A->>DB: BEGIN, buscar clave K
    DB-->>A: K no existe
    B->>DB: BEGIN, buscar clave K
    DB-->>B: K no existe visible
    A->>DB: INSERT clave K
    B->>DB: INSERT clave K
    DB-->>A: UNIQUE satisfecha, COMMIT
    DB-->>B: Conflicto UNIQUE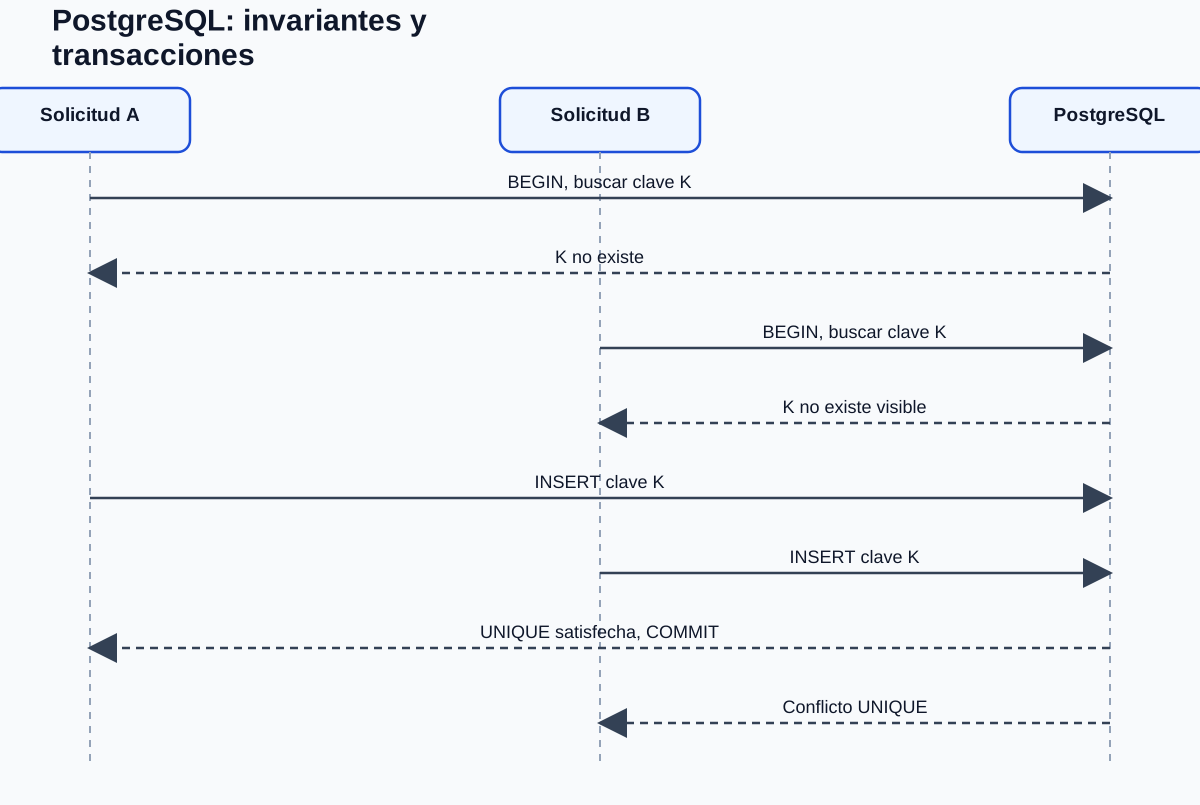
La base de datos relacional actúa como el último árbitro de verdad: las validaciones en código son convenientes para la experiencia de usuario, pero las restricciones en la base de datos son las únicas que garantizan la integridad frente al mundo exterior.
Ejemplo razonado#
A continuación se muestra un esquema DDL completo y una operación transaccional de auditoría en PostgreSQL:
Esquema DDL ilustrativo con restricciones declarativas#
-- DDL para PostgreSQL 14+
-- Tabla de notas con clave externa de negocio, título no vacío y fecha de creación
CREATE TABLE notes (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    external_key TEXT NOT NULL,
    title TEXT NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),

    -- Invariante 1: Unicidad estricta para prevenir carreras concurrentes
    CONSTRAINT notes_external_key_unique UNIQUE (external_key),

    -- Invariante 2: Validación semántica de contenido (no vacío tras trim)
    CONSTRAINT notes_title_not_empty CHECK (length(trim(title)) > 0),

    -- Invariante 3: Longitud máxima de seguridad
    CONSTRAINT notes_title_max_length CHECK (length(title) <= 255)
);

-- Tabla de eventos de auditoría subordinada (Integridad referencial estricta)
CREATE TABLE note_events (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    note_id BIGINT NOT NULL,
    event_type TEXT NOT NULL CHECK (event_type IN ('CREATED', 'ARCHIVED', 'DELETED')),
    occurred_at TIMESTAMPTZ NOT NULL DEFAULT now(),

    -- Invariante 4: Clave foránea que impide eventos huérfanos
    CONSTRAINT fk_note_events_note_id
        FOREIGN KEY (note_id)
        REFERENCES notes(id)
        ON DELETE RESTRICT
);

-- Índice secundario para optimizar la consulta de eventos por nota
CREATE INDEX idx_note_events_note_id ON note_events(note_id);
Inserción atómica transaccional y consulta parametrizada#
-- Transacción atómica: Se crean la nota y su evento inicial de auditoría juntos.
-- Si cualquiera de las dos sentencias falla, NINGUNA fila persiste.
BEGIN;

INSERT INTO notes (external_key, title)
VALUES ($1, $2)
RETURNING id;

-- Supongamos que el id retornado es 101. Se utiliza como parámetro $3 en la siguiente sentencia:
INSERT INTO note_events (note_id, event_type)
VALUES ($3, 'CREATED');

COMMIT;
Práctica independiente#
Diseña un sistema de tareas con eventos de auditoría implementando las siguientes garantías de negocio:
Requerimientos de la práctica:#
- Modelado DDL:
- Diseña la tabla
taskscon:id(identidad autoincremental),external_key(cadena única no nula),title(cadena obligatoria que prohíba espacios en blanco vacíos),status(restringido a'PENDING','IN_PROGRESS','COMPLETED'), ycreated_at(marca de tiempo con zona horaria por defectonow()). - Diseña la tablatask_eventscon:id,task_id(referencia foránea atasks(id)conON DELETE RESTRICT),payload(JSONB no nulo con los detalles del evento), ycreated_at. - Simulación de fallo atómico transaccional:
- Escribe un script SQL que inicie una transacción (
BEGIN), inserte una tarea válida, intente insertar un evento con untask_idinexistente (ej.-999), y ejecuteCOMMIT. - Predicción requerida: ¿Se confirmará la tarea en la tablatasks? Explica qué ocurre en el WAL y qué estado visible reportará unSELECT * FROM tasks;. - Análisis de concurrencia e interleaving:
- Dibuja una línea de tiempo milisegundo a milisegundo donde dos solicitudes intentan insertar simultáneamente la misma
external_key = 'TASK-2026-001'. - Explica el código SQLSTATE emitido por PostgreSQL para la transacción perdedora y escribe el bloque en Rust que capturaría ese error específico para retornar unHTTP 409 Conflictal cliente. - Justificación y medición de índices:
- Supón que la API consulta frecuentemente
SELECT * FROM tasks WHERE status = 'PENDING' ORDER BY created_at ASC LIMIT 10;. - Formula la hipótesis de qué índice compuesto resolvería esta consulta evitando un ordenamiento en memoria (Sort / Seq Scan). - Explica qué penalización de amplificación de escritura sufrirá el comandoINSERTyUPDATE tasks SET status = 'COMPLETED'debido a ese nuevo índice.
Conserva tus respuestas y scripts antes de consultar la guía de soluciones de backend.
Preguntas de comprensión profunda y diagnóstico socrático#
Reflexiona sobre estas cinco preguntas de ingeniería antes de continuar:
Pregunta 1: La ilusión del SELECT COUNT(*) bajo aislamiento READ COMMITTED#
Un desarrollador senior propone:
BEGIN;
SELECT COUNT(*) FROM users WHERE email = $1;
-- Si count == 0:
INSERT INTO users (email) VALUES ($1);
COMMIT;- ¿Por qué el nivel de aislamiento
READ COMMITTEDpermite que dos transacciones simultáneas leancount == 0con el mismo email exacto? - Si cambiamos el nivel de aislamiento a
SERIALIZABLE, ¿se evita la inserción duplicada? ¿Qué error arroja una de las dos transacciones (40001serialization failure) y qué responsabilidad recae sobre el cliente de la aplicación ante ese error?
Pregunta 2: Mecánica del Árbol B-Tree ante inserciones concurrentes#
- Cuando dos hilos intentan insertar la misma clave en un índice
UNIQUE, ¿qué tipo de bloqueo físico a nivel de página (page latch) adquiere el motor de almacenamiento de PostgreSQL? - ¿Por qué el segundo hilo no arroja el error de violación de unicidad inmediatamente, sino que espera hasta que el primer hilo ejecuta
COMMIToROLLBACK?
Pregunta 3: Inyección SQL en nombres de identificadores (Tablas y Columnas)#
Las consultas parametrizadas ($1, $2) funcionan para valores de datos literales en cláusulas WHERE y VALUES.
- Si necesitas hacer una consulta donde el nombre de la columna a ordenar es dinámico (
SELECT * FROM tasks ORDER BY <columna>), ¿puedes escribirSELECT * FROM tasks ORDER BY $1? ¿Por qué el motor de base de datos rechaza o malinterpreta un parámetro en la posición de un identificador? - ¿Cómo se previene de forma segura la inyección SQL en identificadores dinámicos utilizando listas blancas (whitelisting) o la función
format_ident()en PostgreSQL?
Pregunta 4: La compensación de rendimiento de los índices B-Tree (Write Amplification)#
Imagina una tabla de eventos de telemetría IoT que recibe 50,000 inserciones por segundo (INSERT INTO telemetry ...).
- Si la tabla tiene 8 índices secundarios B-Tree definidos en diversas columnas, ¿qué ocurre con el uso de CPU, la contención de cerraduras de memoria (buffer pool locks) y la tasa de generación de bytes en el registro WAL?
- ¿Qué es una división de página (page split) en un B-Tree y por qué una inserción en un índice con claves aleatorias (como UUID v4) es órdenes de magnitud más costosa que una inserción con enteros secuenciales o UUID v7 ordenados cronológicamente?
Pregunta 5: Integridad referencial (FOREIGN KEY) vs Eliminaciones en cascada#
Examina la diferencia entre:
- Opción A:
FOREIGN KEY (user_id) REFERENCES users(id) ON DELETE RESTRICT - Opción B:
FOREIGN KEY (user_id) REFERENCES users(id) ON DELETE CASCADE - En una plataforma financiera, si un usuario elimina su cuenta, ¿por qué
ON DELETE CASCADEsobre la tabla de transacciones monetarias o auditoría contable constituiría una catástrofe regulatoria y legal?
Code smell#
Síntoma: "Check-Then-Act" en la capa de aplicación sin restricción de base de datos#
Encuentras el siguiente código en el repositorio de usuarios:
// Code smell crítico: verificación en memoria sin restricción de BD
let existing_user = db.find_user_by_email(&email).await?;
if existing_user.is_some() {
    return Err(AppError::EmailAlreadyTaken);
}
db.insert_user(&email, &name).await?;
y al inspeccionar la tabla en la base de datos descubres:
CREATE TABLE users (
    id BIGINT PRIMARY KEY,
    email TEXT NOT NULL -- ¡Falta la restricción UNIQUE!
);- Evidencia observable: Búsqueda previa en código seguida de inserción, combinada con la ausencia de una restricción
UNIQUEen la columnaemail. - Hipótesis del problema: El desarrollador creyó que "validar en el código de Rust es suficiente" y asumió erróneamente que las solicitudes siempre se procesan en estricto orden secuencial una por una.
- Consecuencia concreta: Bajo carga normal de usuarios registrándose al mismo tiempo (o por reintentos de red del navegador), la base de datos se llena de filas con emails duplicados. Cuando el sistema intenta posteriormente enviar un correo o iniciar sesión esperando una sola cuenta, falla con errores de tipo "se encontró más de una fila para la consulta".
- Tratamiento mínimo justificado:
- Ejecutar una migración de base de datos que elimine los duplicados existentes y añada la restricción:
``
sql
ALTER TABLE users ADD CONSTRAINT users_email_unique UNIQUE (email);
`` - Mantener la comprobación previa en código si se desea proporcionar un mensaje de error amigable sin golpear la base de datos en el caso común, pero capturar obligatoriamente el error de base de datos con código SQLSTATE
23505(unique_violation) en el bloque de inserción para retornar unHTTP 409 Conflictordenado.
Criterio de salida#
Puedes considerar superada esta lección cuando:
- Puedes trazar paso a paso una línea de tiempo concurrente que demuestre por qué la verificación en memoria es vulnerable a carreras TOCTOU y cómo
UNIQUEarbitra el resultado en PostgreSQL. - Tu diseño DDL utiliza tipos de datos adecuados, claves primarias, restricciones
NOT NULL,CHECK,UNIQUEy claves foráneas con políticas de eliminación bien justificadas. - Comprendes y explicas por qué las consultas parametrizadas segregan el AST de los datos y erradican la inyección SQL a nivel arquitectónico.
- Tu código captura errores de base de datos inspeccionando el código numérico estandarizado SQLSTATE (
23505,40001) en lugar de analizar cadenas de texto frágiles. - Sabes interpretar un plan de ejecución con
EXPLAIN ANALYZEy puedes argumentar el impacto de amplificación de escritura que introduce cada índice B-Tree adicional.
Lecturas oficiales#
- PostgreSQL: Restricciones de integridad (DDL Constraints): Documentación oficial de claves primarias, foráneas,
CHECKyUNIQUE. - PostgreSQL: Aislamiento de transacciones y MVCC: Análisis profundo de anomalías concurrentes y funcionamiento de
READ COMMITTEDySERIALIZABLE. - PostgreSQL: Índices B-Tree y mantenimiento: Estructura física interna y compensaciones de lectura/escritura.
- PostgreSQL: Códigos de error SQLSTATE (Apéndice A): Lista canónica de códigos de error de base de datos.
- Glosario técnico del curso: Definiciones de persistencia y modelos relacionales.
Siguiente paso#
Continúa con 08 · Async y concurrencia, donde explorarás el modelo de ejecución asíncrono dentro del proceso de Rust, aprenderás a gestionar el tiempo de CPU frente al tiempo de E/S, y dominarás las reglas de seguridad ante cancelación de tareas y manejo de bloqueos en memoria.