Sesión 60: Grokking Algorithms Cap. 11 (Parte 3) — Locality-Sensitive Hashing (LSH) y Detección de Casi-Duplicados con Simhash#
Tiempo estimado: 75-85 minutos. Nivel: De Junior/Trainee a Staff Specialist. Herramientas obligatorias: Hoja cuadriculada, lápiz, bolígrafos de dos colores y calculadora.
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Consulta rápida: Glosario Maestro | Guía de Diagramas
Locality-Sensitive Hashing (LSH — Hashing Sensible a la Localidad)#
- (a) En palabras simples (intuición): En las funciones hash comunes (como SHA-256 o MD5), si cambias una sola letra en un libro de 500 páginas, el código resultante cambia de forma salvaje e irreconocible (efecto avalancha). LSH busca exactamente lo opuesto: si dos documentos son casi idénticos, sus códigos hash deben ser casi idénticos o coincidir en la mayoría de sus bits.
- (b) Definición técnica paso a paso: Familia de algoritmos probabilísticos donde la probabilidad de colisión de hash entre dos elementos x e y es una función monótona creciente de su similitud matemática s(x, y):
Permite resolver el problema de vecinos más cercanos aproximados (Approximate Nearest Neighbors) en espacios de altísima dimensionalidad en tiempo sublineal O(N^rho).
- (c) Cómo funciona en Rust (memoria y tipos): Transforma un objeto complejo (un texto largo o vector denso) en un entero escalar sin signo de 64 bits (
u64) compacto, representable directamente en un registro de la CPU. - (d) Error típico de Junior: Usar MD5 o SHA-256 para detectar si dos artículos periodísticos son plagios o reescrituras; al cambiar una coma o un sinónimo, el hash criptográfico difiere en el 50% de sus bits, fallando en detectar la similitud.
Simhash (Algoritmo de Moses Charikar, 2002)#
- (a) En palabras simples (intuición): Imagina que cada palabra de tu documento vota en un congreso de 64 miembros. Si la palabra tiene el bit 5 encendido, vota "+1"; si lo tiene apagado, vota "-1". Si la palabra se repite mucho, su voto vale el doble o el triple. Al final, si la suma total de votos en la banca 5 es positiva, la banca se queda con un 1; si es negativa o cero, se queda con un 0. Ese número final de 64 bits es la huella digital (fingerprint) de todo el documento.
- (b) Definición técnica paso a paso: Algoritmo de LSH para espacios angulares y de similitud coseno:
- Inicializa un vector de 64 acumuladores enteros en cero: V = [0; 64].
- Para cada término t con peso w_t: - Computa el hash de 64 bits h(t). - Para cada bit i ∈ [0, 63]: si el i-ésimo bit de h(t) es 1, V[i] += w_t; si es 0, V[i] -= w_t.
- Construye la huella digital F ∈ {0, 1}⁶⁴: el bit i de F es 1 si V[i] > 0, de lo contrario 0.
- (c) Cómo funciona en Rust (memoria y tipos): El acumulador
v: [i64; 64]se aloja en el Stack (512 bytes), aprovechando los registros vectoriales del procesador. La huella final es un primitivou64que cabe en un registro de propósito general. - (d) Error típico de Junior: Usar un vector dinámico
Vec<i64>en el Heap para los 64 enteros, introduciendo costos innecesarios de reserva dinámica (malloc/free).
Distancia de Hamming y la Instrucción POPCNT#
- (a) En palabras simples (intuición): Es la cantidad de posiciones en las que dos cadenas binarias de igual longitud tienen letras distintas. Por ejemplo:
1001y1010difieren en las dos últimas posiciones, así que su distancia de Hamming es 2. - (b) Definición técnica paso a paso: Métrica definida sobre el espacio vectorial binario:
Equivale a aplicar un XOR bit a bit entre ambos enteros (A oplus B) y contar cuántos bits quedaron en 1 (Population Count).
- (c) Cómo funciona en Rust (memoria y tipos): Se computa como
(fp1 ^ fp2).count_ones(). En compiladores modernos con arquitectura x86-64 y banderas SSE4.2+, esto no ejecuta ningún bucle: se traduce directamente en la instrucción única de silicioPOPCNT, ejecutándose en 1 solo ciclo de reloj. - (d) Error típico de Junior: Escribir un bucle manual con
while n > 0 { if n & 1 { c += 1; } n >>= 1; }, perdiendo la optimización por hardware.
Indexación LSH por Partición de Bloques (Principio del Palomar)#
- (a) En palabras simples (intuición): Si tienes una huella de 64 bits y buscas documentos que difieran en máximo 3 bits, divide la huella en 4 trozos de 16 bits cada uno (4 × 16 = 64). Si solo se equivocan 3 veces, es matemáticamente imposible que ensucien los 4 trozos. Al menos un trozo de 16 bits tiene que haber quedado 100% perfecto e intacto.
- (b) Definición técnica paso a paso: Aplicación del Principio del Palomar (Pigeonhole Principle):
- Para encontrar elementos a distancia d_H ≤ k, se particiona la huella de 64 bits en m = k + 1 bloques disjuntos.
- Si dos huellas difieren en a lo sumo k bits, al menos uno de los k + 1 bloques debe ser exactamente idéntico.
- Se mantienen m tablas Hash (
HashMap<u16, Vec<usize>>). La búsqueda se realiza indexando el bloque exacto en O(1), reduciendo la comprobación de Hamming a un puñado de candidatos. - (c) Cómo funciona en Rust (memoria y tipos): Se extrae el bloque con corrimiento y máscara de 16 bits:
((fp >> (chunk * 16)) & 0xFFFF) as u16. - (d) Error típico de Junior: Comparar la huella entrante contra los 1,000 millones de huellas existentes en un bucle lineal O(N), saturando la CPU.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Prueba Geométrica de Charikar: De Ángulos a Distancia de Hamming#
¿Por qué Simhash preserva la Similitud Coseno?
- Hiperplanos Aleatorios: Cada uno de los 64 bits de la huella digital corresponde a la orientación de un vector normal aleatorio rᵢ en el espacio vectorial continuo.
- Proyección del Signo:
El bit i de la huella del documento u se define como:
hᵢ(u) = begin{cases} 1 & si u · rᵢ ≥ 0 0 & si u · rᵢ < 0 end{cases}
- Probabilidad de Colisión Bit a Bit:
Consideremos dos vectores u y v que forman un ángulo θ entre sí:
cos θ = (u · v) / (|u| |v|)Los vectores u y v tendrán bits diferentes (hᵢ(u) ≠ hᵢ(v)) si y solo si el hiperplano aleatorio perpendicular a rᵢ cae dentro del ángulo θ que los separa. Como el vector normal rᵢ se elige uniformemente en todas direcciones esféricas (2π radianes):P(hᵢ(u) ≠ hᵢ(v)) = (θ) / (π)
- Esperanza Matemática de la Distancia de Hamming:
Para una huella de 64 bits:
mathbb{E}[d_H(F_u, F_v)] = 64 × (θ) / (π)- Si dos documentos son idénticos: θ = 0 ⟹ d_H = 0. - Si dos documentos son ortogonales (temas no relacionados): θ = (π) / (2) ⟹ d_H = 64 × (1) / (2) = 32 bits. - Si dos documentos son casi-duplicados (θ ≈ 5^circ): d_H ≈ 64 × (5) / (180) ≈ 1.77 ≤ 3 bits.
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama Arquitectónico de Flujo#
Consulta el diagrama vectorial: 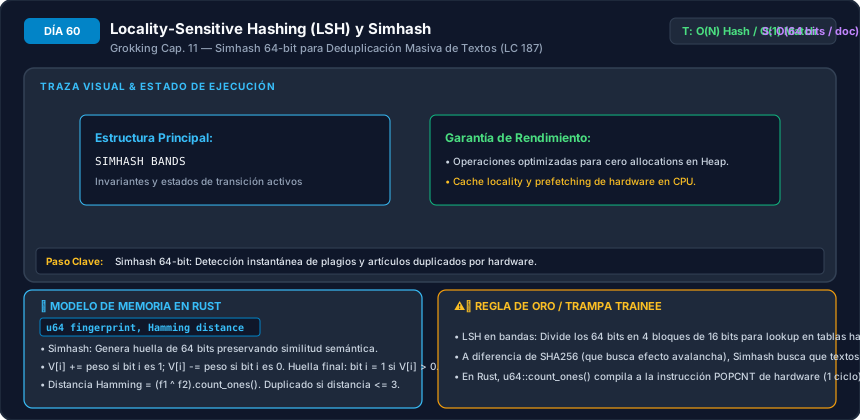
flowchart TD
    TEXT["Documento de Texto entrante"] --> TOK["Tokenizar y calcular pesos w_t"]
    TOK --> VECT["Inicializar v: [i64; 64] en el Stack"]
    VECT --> LOOP["Para cada término:<br/>hash_token() -> h de 64 bits"]
    LOOP --> ACC["bit i == 1 ? v[i] += w : v[i] -= w"]
    ACC --> GEN["Generar u64:<br/>bit i = (v[i] > 0) ? 1 : 0"]
    GEN --> LSH["Partición en 4 bloques de 16 bits<br/>Consultar tablas LSH en O(1)"]
    LSH --> HAM["Verificación POPCNT: (fp1 ^ fp2).count_ones() <= 3"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
PROCESO SIMHASH SOBRE "rust safe fast":
Stack:
  v: [i64; 64] = [0, 0, 0, 0, ...] (512 bytes contiguos en el Stack)

Término "rust" (peso 1):
  h("rust") = ...0011 (bits 0 y 1 en 1, bits 2 y 3 en 0)
  v[0] += 1 (1), v[1] += 1 (1), v[2] -= 1 (-1), v[3] -= 1 (-1)

Término "safe" (peso 1):
  h("safe") = ...0101 (bits 0 y 2 en 1, bits 1 y 3 en 0)
  v[0] += 1 (2), v[1] -= 1 (0), v[2] += 1 (0), v[3] -= 1 (-2)

Término "fast" (peso 1):
  h("fast") = ...0111 (bits 0, 1, 2 en 1, bit 3 en 0)
  v[0] += 1 (3), v[1] += 1 (1), v[2] += 1 (1), v[3] -= 1 (-3)

GENERACIÓN DE FINGERPRINT u64:
  v[0] = 3  > 0 -> bit 0 = 1
  v[1] = 1  > 0 -> bit 1 = 1
  v[2] = 1  > 0 -> bit 2 = 1
  v[3] = -3 <= 0 -> bit 3 = 0
  Huella resultante u64: ...0111 (0x...7)
4. Implementación Canónica en Rust (Compilable con rustc --test)#
Archivo de referencia: practica-rust/dia_60.rs
use std::collections::hash_map::DefaultHasher;
use std::collections::{HashMap, HashSet};
use std::hash::{Hash, Hasher};

pub struct Simhash;

impl Simhash {
    fn hash_token(token: &str) -> u64 {
        let mut hasher = DefaultHasher::new();
        token.hash(&mut hasher);
        hasher.finish()
    }

    pub fn compute(text: &str) -> u64 {
        let mut v = [0i64; 64];
        let mut word_weights: HashMap<&str, i64> = HashMap::new();

        for word in text.split_whitespace() {
            let clean = word.trim_matches(|c: char| !c.is_alphanumeric());
            if !clean.is_empty() {
                *word_weights.entry(clean).or_insert(0) += 1;
            }
        }

        if word_weights.is_empty() {
            return 0;
        }

        for (token, weight) in word_weights {
            let token_hash = Self::hash_token(token);
            for i in 0..64 {
                let bit = (token_hash >> i) & 1;
                if bit == 1 {
                    v[i] += weight;
                } else {
                    v[i] -= weight;
                }
            }
        }

        let mut fingerprint: u64 = 0;
        for i in 0..64 {
            if v[i] > 0 {
                fingerprint |= 1u64 << i;
            }
        }
        fingerprint
    }

    #[inline]
    pub fn hamming_distance(fp1: u64, fp2: u64) -> u32 {
        (fp1 ^ fp2).count_ones()
    }
}

pub struct SimhashLshIndex {
    tables: Vec<HashMap<u16, Vec<usize>>>,
    fingerprints: Vec<u64>,
    threshold: u32,
}

impl SimhashLshIndex {
    pub fn new(threshold: u32) -> Self {
        assert!(threshold <= 3, "Threshold > 3 requires more than 4 tables");
        Self {
            tables: vec![HashMap::new(); 4],
            fingerprints: Vec::new(),
            threshold,
        }
    }

    #[inline]
    fn extract_chunk(fp: u64, chunk_idx: usize) -> u16 {
        ((fp >> (chunk_idx * 16)) & 0xFFFF) as u16
    }

    pub fn insert(&mut self, text: &str) -> usize {
        let doc_id = self.fingerprints.len();
        let fp = Simhash::compute(text);
        self.fingerprints.push(fp);

        for chunk_idx in 0..4 {
            let chunk = Self::extract_chunk(fp, chunk_idx);
            self.tables[chunk_idx].entry(chunk).or_default().push(doc_id);
        }
        doc_id
    }

    pub fn find_near_duplicates(&self, text: &str) -> Vec<usize> {
        let query_fp = Simhash::compute(text);
        let mut candidates: HashSet<usize> = HashSet::new();

        for chunk_idx in 0..4 {
            let chunk = Self::extract_chunk(query_fp, chunk_idx);
            if let Some(matches) = self.tables[chunk_idx].get(&chunk) {
                for &id in matches {
                    candidates.insert(id);
                }
            }
        }

        let mut duplicates = Vec::new();
        for candidate_id in candidates {
            let cand_fp = self.fingerprints[candidate_id];
            if Simhash::hamming_distance(query_fp, cand_fp) <= self.threshold {
                duplicates.push(candidate_id);
            }
        }
        duplicates
    }
}
Implementación de Referencia en Python Tipado#
import hashlib
from typing import Dict, List, Set


class SimhashPython:
    @staticmethod
    def _hash_token(token: str) -> int:
        return int(hashlib.md5(token.encode("utf-8")).hexdigest()[:16], 16)

    @classmethod
    def compute(cls, text: str) -> int:
        v = [0] * 64
        words = text.lower().split()
        if not words:
            return 0

        counts: Dict[str, int] = {}
        for w in words:
            counts[w] = counts.get(w, 0) + 1

        for word, weight in counts.items():
            h = cls._hash_token(word)
            for i in range(64):
                bit = (h >> i) & 1
                v[i] += weight if bit == 1 else -weight

        fingerprint = 0
        for i in range(64):
            if v[i] > 0:
                fingerprint |= 1 << i
        return fingerprint

    @staticmethod
    def hamming_distance(fp1: int, fp2: int) -> int:
        return bin(fp1 ^ fp2).count("1")
5. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En el rastreador de Google (Googlebot), ¿por qué es crítico detectar casi-duplicados antes de indexar una página web?
Respuesta:
- Conservación de Recursos de Red y Almacenamiento: Millones de sitios web replican el mismo comunicado de prensa o artículo agregando solo encabezados de navegación locales, publicidad o marcas de tiempo distintas.
- Si Google indexara cada réplica de 20 KB de forma independiente, saturaría sus granjas de servidores con petabytes de datos redundantes.
- Además, mostrar 10 resultados de búsqueda que son idénticos palabra por palabra destruiría la experiencia de usuario del buscador. Simhash detecta que dos páginas tienen d_H ≤ 3, agrupándolas bajo un único documento representativo canónico.
Pregunta 2: ¿Cómo garantiza el Principio del Palomar que una huella con distancia de Hamming ≤ 3 será localizada mediante 4 tablas de 16 bits?
Respuesta:
- Demostración por Reducción al Absurdo:
- Dividimos los 64 bits en 4 bloques de 16 bits: B₁, B₂, B₃, B₄.
- Supongamos que la distancia total de Hamming es d ≤ 3.
- Si los 4 bloques tuvieran al menos un bit con error, el número total de errores sería:
Errores ≥ 1 + 1 + 1 + 1 = 4
- Pero esto contradice nuestra premisa de que d ≤ 3.
- Por lo tanto, es axiomáticamente imposible que todos los bloques tengan errores. Al menos un bloque debe tener cero errores (ser idéntico al 100%), permitiendo que la tabla Hash correspondiente localice el candidato en O(1).
Pregunta 3: ¿Por qué Simhash asigna pesos (w_t) a los términos y qué sucede si una palabra común como "el" no se filtra?
Respuesta:
- Influencia Desproporcionada: Si un artículo contiene 1,000 apariciones de la palabra "el", el vector h("el") sumará o restará ± 1000 en todas las 64 posiciones. Esa única palabra común eclipsaría por completo el contenido significativo del artículo ("algoritmo", "concurrencia").
- Por ello, en producción se multiplican las ocurrencias por el peso IDF del término, asegurando que las palabras vacías (stopwords) tengan un peso infinitesimal cercano a 0 y no corrompan la orientación del vector final.
Pregunta 4: ¿Cuál es la diferencia fundamental entre Simhash (Charikar) y MinHash (Broder)?
Respuesta:
- Métricas Matemáticas Distintas:
- Simhash: Modela la Similitud Coseno y el ángulo θ entre vectores continuos o ponderados. Es ideal para textos extensos, noticias y documentos donde la frecuencia y peso de las palabras importa.
- MinHash: Modela el Coeficiente de Similitud de Jaccard entre conjuntos binarios: J(A, B) = (|A ∩ B|) / (|A ∪ B|). Es ideal para conjuntos no ponderados, como detección de coincidencias en bases de datos genómicas (cadenas de ADN) o detección de plagio en código fuente basado en n-gramas léxicos.
Pregunta 5: ¿Por qué en Rust la instrucción count_ones() sobre primitivos numéricos no tiene costo algorítmico de bucle?
Respuesta:
- Mapeo a Silicio Dedicado: La función
count_ones()está implementada como un compiler intrinsic de LLVM. - En procesadores modernos (tanto x86-64 como ARM64), existe una unidad funcional aritmética en silicio diseñada específicamente para contar bits en 1:
- En x86: instrucción
POPCNT(parte del conjunto de instrucciones SSE4.2 / ABM). - En ARM64: instrucción
CNTsobre registros vectoriales NEON. - El microcódigo ejecuta la suma paralela de bits mediante puertas lógicas en una fracción de nanosegundo (O(1) físico).