15 · Pruebas, fallos y depuración reproducible#
Una prueba automatizada no es una palmada en la espalda ni un trámite burocrático para ver "que el comando termine en verde": es un experimento científico reproducible que somete a prueba una hipótesis sobre el comportamiento observable de un sistema bajo condiciones controladas. Esta lección te aleja del ensayo y error caótico (shotgun debugging) y de las métricas superficiales de cobertura; aprenderás a caracterizar código heredado (legacy), a aislar reproducciones mínimas de fallos, a gobernar el tiempo sin bloqueos arbitrarios con thread::sleep y a construir suites de pruebas resilientes que protejan las invariantes sin impedir la refactorización futura.
Objetivo#
Al terminar esta lección podrás:
- Aplicar el método científico de depuración: aislar un caso de reproducción mínimo, formular una hipótesis falsable sobre la causa raíz y capturar el defecto en una prueba de regresión automatizada (fase RED) antes de aplicar la corrección (fase GREEN).
- Crear pruebas de caracterización (Golden Master) siguiendo la disciplina de Michael Feathers para fijar el comportamiento observable de sistemas existentes antes de refactorizarlos.
- Distinguir los roles, alcances y costos de la pirámide de pruebas (unitarias, integración y extremo a extremo), reconociendo qué clase de fallos detecta cada nivel y cuáles escapan a su alcance.
- Demostrar formalmente por qué una cobertura de líneas del 100% no garantiza la ausencia de defectos y cómo las pruebas tautológicas y el exceso de aserciones de interacción (over-mocking) destruyen la mantenibilidad.
- Erradicar pruebas intermitentes (flaky tests) causadas por pausas ciegas (
thread::sleep) mediante la inyección de abstracciones deterministas del tiempo (trait Clock).
Antes de empezar#
Necesitas bases de funciones, manejo de colecciones (Vec), tipos de error (Result), sintaxis de atributos de prueba (#[test], #[cfg(test)]) y ejecución en terminal mediante cargo test o rustc --test.
El programa completo de esta lección es Rust estándar (std-only). Puedes verificarlo de forma autónoma en cualquier consola:
rustc --test sample.rsTen presente la regla de oro del ingeniero de pruebas: una prueba que nunca puede fallar no demuestra nada. Si escribes una prueba para un requisito nuevo o para un defecto reportado y la prueba pasa de inmediato antes de que toques el código de producción, la prueba no está observando el riesgo que pretendes mitigar.
Si encuentras términos desconocidos durante la lectura, consulta el glosario técnico.
Diccionario de conceptos de la lección (Glosario desde cero)#
Para construir una mentalidad rigurosa de verificación de software, analizamos los conceptos clave bajo cuatro dimensiones: intuición cotidiana, definición técnica formal, ejemplo concreto en código y concepción errónea frecuente.
1. Prueba de caracterización (Characterization Test / Golden Master)#
- Intuición cotidiana: Tomar un molde de yeso de una escultura antigua antes de restaurarla: el molde captura exactamente las curvas maestras, pero también las pequeñas grietas y asperezas existentes. No juzga si una grieta "es bonita"; solo garantiza que la escultura mantenga su forma original mientras los restauradores refuerzan su base interna.
- Definición técnica precisa: Concepto introducido por Michael Feathers en Working Effectively with Legacy Code. Es una prueba automatizada escrita para fijar y registrar el comportamiento observable actual de un sistema existente (incluyendo peculiaridades, restricciones históricas o comportamientos no documentados) cuando no existe una especificación formal ni pruebas previas. Su objetivo es actuar como red de seguridad para detectar cualquier cambio no intencionado durante una refactorización estructural.
- Ejemplo en código:
  #[test]
  fn locks_in_legacy_quirk_before_refactoring() {
      // Legacy behavior: returns empty string when input has no vowels
      assert_eq!(legacy_extract_vowels("rhythm"), "");
}- Concepción errónea: Creer que una prueba de caracterización describe cómo debería funcionar el sistema según la lógica ideal. Una prueba de caracterización documenta con frialdad cómo funciona el sistema en este instante en producción, aunque su comportamiento parezca extraño o inconveniente. El cambio de comportamiento se aborda en una fase separada.
2. Prueba de regresión (Regression Test)#
- Intuición cotidiana: Instalar un tope de seguridad en una puerta después de que un viento fuerte rompió un vidrio: el tope existe específicamente para que esa ventana en particular nunca vuelva a estrellarse por la misma ráfaga de aire.
- Definición técnica precisa: Caso de prueba automatizado diseñado específicamente para reproducir un defecto reportado en producción o detectado durante la integración. Se escribe primero para verificar que el arnés de pruebas falla de forma determinista (fase RED); una vez corregido el defecto en el código de producción (fase GREEN), la prueba se conserva permanentemente en la suite para asegurar que el defecto nunca vuelva a introducirse de manera silenciosa en versiones futuras.
- Ejemplo en código:
  #[test]
  fn regression_issue_402_rejects_index_beyond_capacity() {
      let mut items = vec![1, 2];
      // Issue #402 reported that index 5 panicked instead of returning Err
      assert!(insert_sorted(&mut items, 5, 10).is_err());
}- Concepción errónea: Pensar que corregir el bug en el código y probarlo manualmente en la consola una sola vez es suficiente. Sin una prueba de regresión codificada en la suite automatizada, cualquier refactorización o cambio de dependencias seis meses después puede reintroducir el mismo fallo sin que nadie lo note.
3. Pirámide de pruebas (Test Pyramid)#
- Intuición cotidiana: La arquitectura de una fortaleza: una base gigantesca y sólida de bloques de piedra firmes (pruebas unitarias), un nivel intermedio de murallas y puertas que articulan el paso (pruebas de integración) y unas pocas torres de vigilancia en la cúspide para otear el horizonte completo (pruebas de extremo a extremo).
- Definición técnica precisa: Modelo conceptual propuesto por Mike Cohn que recomienda distribuir las pruebas del sistema en capas proporcionales:
- Base (Unitarias): Cientos o miles de pruebas aisladas, sin I/O, que verifican funciones puras e invariantes de memoria en microsegundos.
- Medio (Integración): Decenas de pruebas que verifican la comunicación real entre adaptadores y recursos externos (consultas a base de datos en contenedores, serialización HTTP, contratos de red).
- Cúspide (End-to-End / E2E): Un número reducido de pruebas de flujo completo que ejecutan el sistema desplegado simulando la interacción real del usuario o cliente (navegador web, llamadas de red reales).
- Ejemplo en código:
  // Unit test: executes in 2 microseconds in memory
  #[test]
  fn calculates_discount_pure() {
      assert_eq!(calculate_discount(1000, 10), 100);
}- Concepción errónea: El antipatrón del "cono de helado" (Ice Cream Cone), donde el equipo casi no escribe pruebas unitarias y confía toda la calidad a una suite gigantesca de pruebas E2E en Playwright o Selenium. Estas suites son lentas (tardan horas), altamente frágiles (flaky) y cuando fallan, no revelan en qué capa de las 10 existentes ocurrió el fallo.
4. Cobertura de código (Líneas vs Ramas) y Prueba tautológica#
- Intuición cotidiana: Un guardia de seguridad que marca su tarjeta en todos los pasillos del edificio caminando a paso rápido: el registro prueba que visitó todas las habitaciones (cobertura de líneas), pero no prueba que haya revisado si las cerraduras de las ventanas estaban forzadas o si había humo bajo una puerta (calidad de aserción).
- Definición técnica precisa:
- *Cobertura de líneas (Line Coverage):* Porcentaje de líneas de código fuente que fueron ejecutadas al menos una vez durante la corrida de pruebas.
- *Cobertura de ramas (Branch Coverage):* Porcentaje de bifurcaciones lógicas (
if/else, brazos dematch, evaluación de cortocircuito&&/||) evaluadas en todas sus posibles direcciones verdaderas y falsas. - Prueba tautológica / vacua: Prueba automatizada que carece de aserciones significativas sobre el estado o el contrato, o que utiliza simuladores (mocks) de manera tan excesiva que termina verificando únicamente que el código de prueba se llama a sí mismo, produciendo un 100% de cobertura sin tener la menor capacidad de detectar un bug real.
- Ejemplo en código:
  // Tautological test: visits code lines but asserts nothing useful!
  #[test]
  fn vacuous_test() {
      let mut list = vec![1, 2, 3];
      let _ = list.pop();
      assert!(true); // Useless assertion! Passes even if pop() corrupts memory
}- Concepción errónea: Tratar la métrica de cobertura de código como un objetivo de negocio o una garantía de corrección. Una cobertura del 100% puede coexistir pacíficamente con decenas de errores de desbordamiento de enteros, condiciones de carrera o fallos de casos límite no evaluados.
5. Determinismo vs Prueba intermitente (Flaky Test)#
- Intuición cotidiana: Una báscula de cocina digital: si colocas una manzana de 150 gramos 10 veces seguidas, la báscula debe marcar 150 gramos las 10 veces. Si en una ocasión marca 150g, en otra 0g y en otra da un error de lectura por la corriente de aire, la báscula no es confiable.
- Definición técnica precisa:
- Prueba determinista: Prueba que, ejecutada sobre el mismo código fuente y bajo las mismas precondiciones, produce siempre y de manera consistente el mismo resultado (éxito o fallo), sin importar cuántas veces se repita, qué hora sea ni en qué máquina se ejecute.
- *Prueba intermitente (Flaky test):* Prueba que exhibe resultados no deterministas (a veces pasa, a veces falla) sin que se haya modificado el código fuente. Suele originarse por condiciones de carrera entre hilos, dependencia del reloj del sistema operativo, orden aleatorio de ejecución en colecciones no ordenadas (
HashMap) o esperas ciegas basadas en pausas temporales. - Ejemplo en código:
  // Flaky test antipattern: sleeping hoping async work completes
  // In a slow CI server with CPU throttling, 50ms will randomly fail!
// std::thread::sleep(std::time::Duration::from_millis(50));- Concepción errónea: Pensar que las pruebas intermitentes son "normales" o "problemas de la red que se resuelven volviendo a lanzar el pipeline". Las pruebas intermitentes destruyen la confianza del equipo en la suite de integración continua; cuando los ingenieros se acostumbran a ver pruebas rojas y reintentarlas a ciegas, los fallos reales en producción dejan de ser atendidos.
6. Taxonomía de dobles de prueba (Test Doubles, Gerard Meszaros)#
- Intuición cotidiana: En el entrenamiento médico:
- Dummy: Un maniquí de plástico que solo ocupa espacio en la camilla para simular el peso de un paciente.
- Stub: Un maniquí con un altavoz que responde siempre "me duele el pecho" cuando le tocas el hombro.
- Spy: Un dispositivo que registra cuántas veces el estudiante aplicó el desfibrilador y con qué fuerza.
- Mock: Un instructor estricto parado al lado que interrumpe la simulación si el estudiante no aplica el vendaje en menos de 30 segundos.
- Fake: Un actor profesional que simula los síntomas de forma fluida y reacciona de verdad, aunque no tiene la enfermedad real.
- Definición técnica precisa: Clasificación formal establecida por Gerard Meszaros en xUnit Test Patterns:
- Dummy: Objeto que se pasa como argumento únicamente para satisfacer la firma del método o función, pero que nunca se invoca ni se lee internamente.
- Stub: Objeto que proporciona respuestas prefabricadas y enlatadas a las llamadas realizadas durante la prueba, sin capacidad de validar flujos ni registrar llamadas.
- Spy: Stub que además registra de forma encubierta información sobre cómo fue invocado (argumentos pasados, cantidad de llamadas) para ser inspeccionado en aserciones posteriores.
- Mock: Objeto preprogramado con expectativas estrictas de interacciones (qué métodos deben llamarse, con qué argumentos y en qué secuencia exacta). La prueba verifica si esas expectativas se cumplieron.
- Fake: Implementación funcional y operativa del contrato que utiliza atajos o simplificaciones no aptas para producción (por ejemplo, un repositorio en memoria basado en un
VecoHashMapen lugar de una base de datos PostgreSQL real). - Ejemplo en código:
  // Fake: working implementation in memory
  #[derive(Default)]
  pub struct FakeUserRepository {
      pub users: Vec<String>,
}- Concepción errónea: Llamar "mock" a cualquier doble de prueba de forma genérica. Utilizar mocks cuando lo que se necesita es un fake suele acoplar la prueba a detalles privados de implementación, haciendo que las pruebas fallen ante cualquier refactorización válida.
7. Verificación de estado vs Verificación de interacción (State vs Interaction Verification)#
- Intuición cotidiana:
- Verificación de estado: Revisar tu coche después de llevarlo al taller comprobando que el motor encienda suavemente, los frenos respondan y el aceite esté a nivel óptimo.
- Verificación de interacción: Exigir que el mecánico te demuestre que usó exactamente la llave inglesa de 12mm tres veces hacia la derecha y dos hacia la izquierda. Si el mecánico usa otra herramienta más moderna para lograr el mismo ajuste, lo descalificas.
- Definición técnica precisa:
- *Verificación de estado (State Verification): Estrategia de prueba donde se invocan operaciones sobre el componente bajo prueba y se valida que el valor devuelto o el estado observable resultante* del objeto coincida con la expectativa. Es altamente inmune a refactorizaciones internas.
- *Verificación de interacción (Interaction Verification): Estrategia donde se valida la secuencia de mensajes, métodos y llamadas internas* que el objeto bajo prueba ejecutó sobre sus colaboradores (mediante mocks).
- Ejemplo en código:
  // State verification (Robust): asserts on final observable data
  assert_eq!(list.len(), 3);
assert_eq!(list[0], 42);- Concepción errónea: Creer que la verificación de interacción es más rigurosa que la de estado. Un exceso de verificación de interacción convierte a las pruebas en réplicas espejadas del código fuente: si cambias la implementación interna sin alterar el resultado, la prueba con mocks se rompe (fragile tests), impidiendo la refactorización fluida.
8. Reproducción mínima y Bisección de fallos (Minimal Reproduction & Failure Bisection)#
- Intuición cotidiana: Si tu ordenador se apaga solo: desconectas la impresora, la cámara web, el disco externo y dejas solo el cable de poder y la pantalla; si no se apaga, conectas uno por uno los dispositivos hasta descubrir exactamente cuál provoca el cortocircuito.
- Definición técnica precisa:
- *Reproducción mínima (Minimal Reproducible Example - MRE):* Reducción sistemática del código, datos de entrada y dependencias de entorno hasta aislar el fragmento más pequeño posible que continúe detonando el defecto observable con un 100% de consistencia.
- *Bisección de fallos (Failure Bisection): Algoritmo de búsqueda binaria (como
git bisect) aplicado sobre la historia de confirmaciones (commits*) o sobre el espacio de entradas para identificar el cambio exacto que introdujo la regresión. - Ejemplo en código:
  // Minimal reproduction: instead of a 10MB JSON with 40 fields,
  // isolate that the crash happens with an empty array '[]'
assert_eq!(parse_tags("[]"), Ok(vec![]));- Concepción errónea: Intentar depurar un fallo directamente sobre una base de datos con millones de registros y cientos de servicios interactuando. Sin aislar una reproducción mínima, el programador pierde horas analizando ruido irrelevante.
Diagrama#
El siguiente diagrama formaliza el flujo riguroso del método científico de depuración y refactorización guiada por pruebas:
flowchart TD
  A[Reproducir entrada mínima] --> B[Escribir expectativa]
  B --> C{¿Falla por la causa esperada?}
  C -->|No| D[Revisar que la prueba detecte el riesgo]
  C -->|Sí RED| E[Cambio mínimo GREEN]
  E --> F[Ejecutar conjunto relevante]
  F --> G{¿Contrato sigue igual?}
  G -->|Sí| H[Refactor sin cambiar observación]
  G -->|No| I[Investigar regresión o requisito]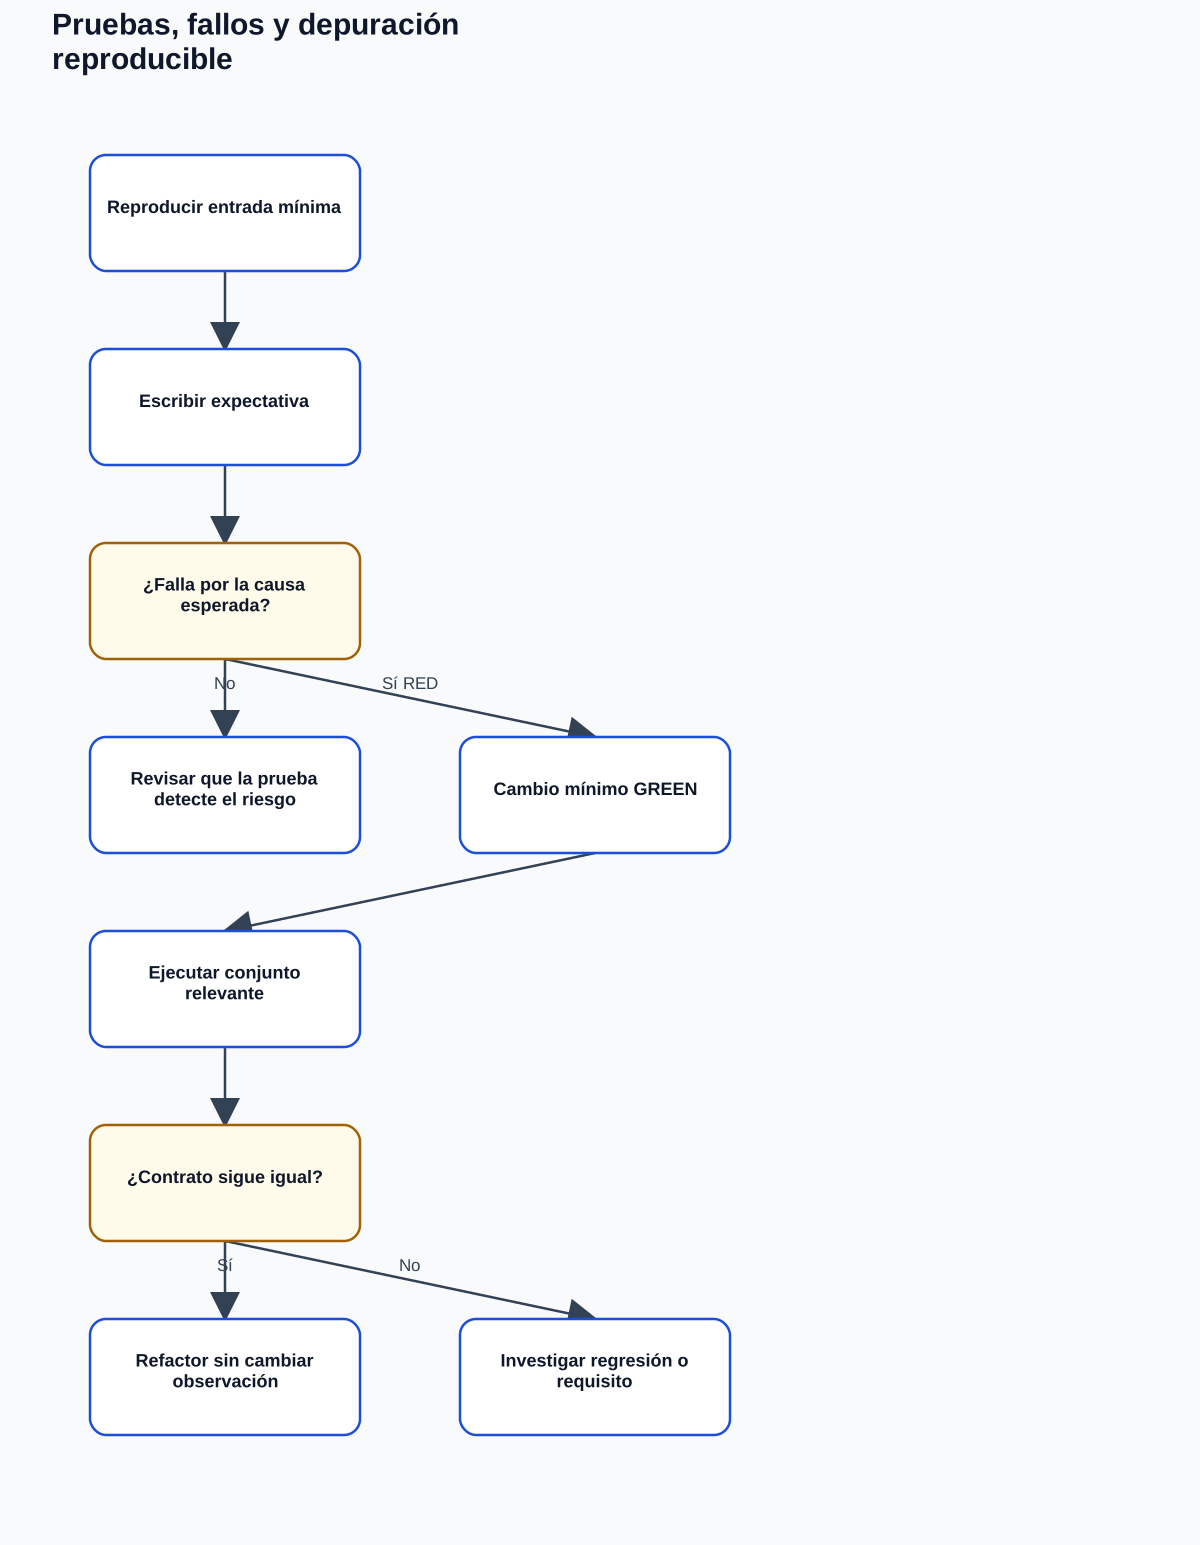
Modelo mental y desempacado paso a paso#
1. El método científico de depuración frente al ensayo y error caótico#
El desarrollador novato depura mediante shotgun debugging: cuando un test falla o surge un error en producción, altera condicionales al azar, agrega println! desordenados o cambia operadores con la esperanza de que el error desaparezca. Si el error deja de verse, asume que está solucionado, sin comprender por qué ocurrió ni qué otros casos de borde rompió.
El ingeniero profesional aplica el método científico:
- Observación precisa: Registra con frialdad: ¿cuál fue la entrada exacta?, ¿cuál fue la salida observada?, ¿cuál era la salida esperada según la especificación?
- Formulación de una hipótesis falsable: Formula una afirmación causal que pueda someterse a prueba experimental:
- Hipótesis vaga (inútil): "La lista ordenada tiene un fallo".
- Hipótesis falsable (científica): "La función
insert_sortedutiliza el operador>=en lugar de>al validar el índice contra la longitud del vector, lo que provoca que una inserción válida al final de la colección sea rechazada como fuera de límites". - Aislamiento de la reproducción mínima: Construye el caso de prueba más pequeño posible que desmienta o confirme la hipótesis: una lista de 2 elementos y un intento de inserción en el índice 2.
- Fase RED verificada: Ejecuta la prueba. Debe fallar de forma ruidosa y por el motivo exacto predicho en la hipótesis.
- Corrección mínima (Fase GREEN): Corrige exclusivamente la causa raíz identificada. Vuelve a ejecutar la suite completa.
- Refactorización e institucionalización: La prueba de reproducción mínima se incorpora a la suite de regresión permanente con un comentario explicativo del contrato.
2. La trampa del 100% de cobertura y los mocks frágiles#
Considera esta función:
pub fn divide_allowance(total_cents: u32, members: u32) -> u32 {
    total_cents / members
}
Si escribes esta prueba:
#[test]
fn test_divide() {
    assert_eq!(divide_allowance(100, 2), 50);
}
Las herramientas de análisis de cobertura reportarán un 100% de cobertura de líneas y un 100% de cobertura de ramas. Sin embargo:
- ¿Qué ocurre si
memberses0? La función causa un pánico fatal de CPU por división entre cero (division by zero panic). - La métrica de cobertura dice que la línea fue ejecutada, pero la suite no evaluó el caso de frontera más peligroso del dominio.
De forma complementaria, el exceso de mocks (over-mocking) destruye la capacidad de refactorizar: Si una prueba unitaria verifica que tu servicio llamó a repo.step_1(), luego a repo.step_2() y finalmente a repo.step_3(), estás probando la implementación algorítmica privada, no el contrato observable. Si mañana optimizas el algoritmo para resolver el problema en un único paso atómico repo.step_combined(), tu código será más rápido y seguro, pero tu suite de pruebas fallará estrepitosamente porque los mocks esperaban la secuencia antigua.
Diseña siempre tus aserciones sobre el resultado observable y el estado público final (State Verification), recurriendo a la verificación de interacciones solo en límites estrictos donde el efecto exterior sea el contrato en sí mismo (como disparar una orden irrevocable de cobro a una pasarela bancaria externa).
3. Erradicación del no-determinismo: el veneno de thread::sleep#
Un error frecuente al probar lógica asíncrona, temporizadores o expiración de sesiones es introducir pausas mediante thread::sleep:
// Antipatrón frágil:
#[test]
fn session_expires_after_timeout_bad() {
    let session = create_session(Duration::from_millis(100));
    std::thread::sleep(Duration::from_millis(150));
    assert!(session.is_expired());
}
¿Por qué este patrón es destructivo?
- Ralentiza la suite completa: Si tienes 500 pruebas temporales durmiendo 150 milisegundos cada una, la suite tarda más de un minuto en ejecutarse, destruyendo el ciclo ágil de desarrollo.
- *Genera pruebas intermitentes (flaky):* En el entorno de integración continua (CI) en la nube, donde múltiples contenedores comparten núcleos de CPU bajo alta contención, el hilo que duerme puede despertar con desfases inesperados, o el planificador del sistema operativo puede suspender el hilo antes de comprobar la aserción, haciendo que la prueba falle de forma aleatoria.
La solución arquitectónica correcta es invertir la dependencia del reloj mediante un trait:
pub trait Clock {
    fn now_seconds(&self) -> u64;
}

// Adaptador de producción: consulta el reloj real del sistema operativo
pub struct SystemClock;
impl Clock for SystemClock {
    fn now_seconds(&self) -> u64 {
        std::time::SystemTime::now()
            .duration_since(std::time::UNIX_EPOCH)
            .unwrap_or_default()
            .as_secs()
    }
}

// Doble de prueba determinista: tiempo congelado o manipulable al instante
pub struct FrozenClock {
    pub current_time: u64,
}
impl Clock for FrozenClock {
    fn now_seconds(&self) -> u64 { self.current_time }
}
Ahora la prueba corre en cero nanosegundos, es 100% determinista y puede evaluar límites temporales con precisión de un segundo sin dormir jamás el hilo.
Ejemplo razonado#
El siguiente bloque es un programa completo en Rust estándar ejecutable con rustc --test sample.rs. Demuestra:
- Una regla de normalización de cadenas de texto con pruebas de preservación.
- Un doble de prueba de reloj congelado (FrozenClock) para verificar la expiración de sesiones sin pausas temporales.
// ==========================================
// 1. DOMINIO Y NORMALIZACIÓN PURA
// ==========================================

pub fn normalize_title(input: &str) -> String {
    input.trim().to_owned()
}

// ==========================================
// 2. ABSTRACCIÓN DETERMINISTA DEL TIEMPO
// ==========================================

pub trait Clock {
    fn now_seconds(&self) -> u64;
}

pub struct FrozenClock {
    pub current_time: u64,
}

impl Clock for FrozenClock {
    fn now_seconds(&self) -> u64 {
        self.current_time
    }
}

pub struct SessionManager<C: Clock> {
    clock: C,
    timeout_seconds: u64,
}

impl<C: Clock> SessionManager<C> {
    pub fn new(clock: C, timeout_seconds: u64) -> Self {
        Self {
            clock,
            timeout_seconds,
        }
    }

    pub fn is_session_expired(&self, session_created_at: u64) -> bool {
        let current = self.clock.now_seconds();
        current.saturating_sub(session_created_at) >= self.timeout_seconds
    }
}

// ==========================================
// 3. SUITE DE PRUEBAS AUTOMATIZADAS
// ==========================================

#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn removes_outer_whitespace_but_keeps_inner_space() {
        assert_eq!(normalize_title("  Field notes  "), "Field notes");
        assert_eq!(normalize_title("\t\nTask title\r "), "Task title");
        assert_eq!(normalize_title(""), "");
    }

    #[test]
    fn session_expiration_tested_deterministically_without_sleeping() {
        // We set the virtual universe clock to exactly t = 1,000 seconds
        let clock = FrozenClock { current_time: 1_000 };
        let manager = SessionManager::new(clock, 300); // 300-second session lifespan

        // Case 1: Session created at t = 800 (elapsed: 200s < 300s) -> Active
        assert!(!manager.is_session_expired(800));

        // Case 2: Session created at t = 700 (elapsed: 300s == 300s) -> Expired exactly at boundary
        assert!(manager.is_session_expired(700));

        // Case 3: Session created at t = 600 (elapsed: 400s > 300s) -> Expired
        assert!(manager.is_session_expired(600));
    }
}
Práctica independiente#
En este ejercicio diagnosticarás y corregirás un defecto de frontera heredado en una función de inserción en colecciones ordenadas aplicando la disciplina de caracterización y TDD.
1. Especificación del problema y defecto heredado#
Se tiene una función de inserción en lista ordenada insert_sorted(items: &mut Vec<i32>, index: usize, value: i32) -> Result<(), InsertError>. En el código heredado, el desarrollador anterior escribió la verificación de límites de la siguiente manera:
// Buggy legacy code:
if index >= items.len() {
    return Err(InsertError::IndexOutOfBounds);
}
Examina las consecuencias de esta condición:
- En un vector de 2 elementos
[2, 5], la longitud esitems.len() == 2. - Los índices de elementos existentes son
0y1. - Si un usuario desea insertar al final de la lista (en el índice
2), la llamada nativaitems.insert(2, value)de Rust es perfectamente legal y válida (el resultado sería[2, 5, value]). - Sin embargo, la condición heredada
index >= items.len()(2 >= 2) rechaza erróneamente esta operación válida, tratando la inserción al final como si fuera un error fuera de límites. - La inserción en un índice estrictamente mayor a la longitud (
index > items.len(), por ejemplo índice3en una lista de 2 elementos) sí es un error real fuera de límites y debe rechazarse sin causar pánico.
2. Matriz de partición de equivalencias y predicción de resultados#
Completa tu predicción mental antes de ejecutar las pruebas:
| Lista inicial | Índice (index) | Valor (value) | Resultado esperado | Justificación de contrato |
|---|---|---|---|---|
[] | 0 | 42 | Ok(()) arrow [42] | Inserción en lista vacía en posición 0 |
[2, 5] | 0 | 1 | Ok(()) arrow [1, 2, 5] | Inserción al inicio de la colección |
[2, 5] | 1 | 3 | Ok(()) arrow [2, 3, 5] | Inserción intermedia manteniendo orden |
[2, 5] | 2 | 7 | Ok(()) arrow [2, 5, 7] | Inserción al final (frontera legal index == len) |
[2, 5] | 3 | 8 | Err(IndexOutOfBounds) | Fuera de límites (index > len, rechazo seguro) |
3. Protocolo de trabajo paso a paso#
- Paso 1 (Caracterización del sistema heredado):
Escribe una función con el código defectuoso original. Crea una prueba automatizada que demuestre que el índice
2es rechazado por el código actual. Ejecuta la prueba y confirma que pasa: has fijado el comportamiento del sistema heredado. - Paso 2 (Fase RED deliberada):
Escribe una nueva prueba que declare el contrato corregido: la inserción en el índice
2debe retornarOk(())y dejar la lista como[2, 5, 7]. Ejecuta la suite y observa el fallo rojo en tu terminal. - Paso 3 (Fase GREEN):
Corrige la condición de frontera en
insert_sorted: cambiaindex >= items.len()porindex > items.len(). Verifica que la nueva prueba pase y que la prueba para el índice3continúe rechazando de forma segura. - Paso 4 (Fase REFACTOR):
Modela el error utilizando una enumeración expresiva con contexto enriquecido:
``
rust
#[derive(Debug, PartialEq, Eq)]
pub enum InsertError {
IndexOutOfBounds { index: usize, len: usize },
}
``
Consulta la guía de soluciones en ../solutions/04-design.md tras completar tu intento independiente.
Preguntas de comprensión profunda y diagnóstico socrático#
Reflexiona sobre estas cinco preguntas de diseño. Cada una explora un límite del modelo mental de pruebas y depuración:
Pregunta 1: Verificación de estado vs Verificación de interacción en refactorizaciones#
Un equipo tiene dos suites de pruebas para un servicio de facturación:
- La Suite A utiliza mocks exhaustivos para verificar que el servicio invoque a
tax_calculator.fetch_rate(), luego acurrency_converter.convert()y luego aledger.record_entry(). - La Suite B utiliza un repositorio fake en memoria y asertos de estado puro: entrega una orden con montos conocidos y verifica que el saldo final del libro contable devuelva exactamente el valor monetario esperado.
El equipo decide refactorizar el servicio para consolidar el cálculo de tasas y conversión de divisas en una única función pura en memoria.
- ¿Qué ocurrirá con la Suite A y qué ocurrirá con la Suite B tras esta refactorización válida?
- Explica por qué la verificación excesiva de interacciones genera resistencia psicológica contra la mejora del diseño en los equipos de desarrollo.
Pregunta 2: La falacia de la cobertura de líneas del 100% y las pruebas vacuas#
Analiza esta afirmación de un gerente de ingeniería: "Hemos configurado el pipeline de CI para bloquear cualquier merge que no tenga 100% de cobertura de código; por tanto, es matemáticamente imposible que lleguen regresiones a producción."
- Proporciona un contraejemplo concreto en Rust donde una función con 100% de cobertura de líneas y ramas colapse en tiempo de ejecución ante una entrada no anticipada.
- ¿Qué diferencia existe entre "línea ejecutada por el arnés" y "propiedad semántica verificada por una aserción"?
Pregunta 3: Depuración científica vs Ensayo y error (Shotgun Debugging)#
Un endpoint de autenticación comienza a devolver de forma intermitente códigos HTTP 401 Unauthorized a usuarios legítimos en producción.
- Describe cómo abordaría el problema un desarrollador aplicando shotgun debugging.
- Describe el proceso de 6 pasos que seguirá un ingeniero aplicando el método científico de depuración.
- ¿Por qué es crítico aislar una reproducción mínima antes de proponer cambios en el código de producción?
Pregunta 4: Pruebas de caracterización (Golden Master) en sistemas sin especificación#
Heredas una biblioteca de cálculo de liquidaciones salariales de 4,000 líneas escrita en C sin pruebas automatizadas ni documentación de requisitos. La empresa te pide migrarla a Rust idiomático.
- ¿Por qué sería un error garrafal comenzar a escribir la versión en Rust asumiendo cómo "deberían" ser las reglas salariales?
- ¿Cómo se construye un arnés de caracterización (Golden Master) alimentando miles de entradas históricas reales y capturando sus salidas para validar la versión en Rust?
Pregunta 5: Erradicación del no-determinismo y control del tiempo#
Considera un componente que bloquea temporalmente una cuenta de usuario durante 15 minutos tras tres intentos fallidos de contraseña.
- Explica qué problemas genera probar este componente utilizando
std::thread::sleep(Duration::from_secs(900)). - Diseña el contrato del trait
Clocky explica cómo una prueba conFrozenClockpuede simular el transcurso de 15 minutos y 1 segundo en menos de 10 microsegundos de CPU.
Code smell#
Síntoma: Pruebas acopladas al reloj físico del sistema operativo con esperas ciegas#
// Problematic test code:
#[test]
fn test_cache_expiration_bad() {
    let mut cache = TimedCache::new(Duration::from_millis(50));
    cache.insert("session_key", "user_123");

    // Sleeping hoping the OS clock ticks past expiration
    std::thread::sleep(Duration::from_millis(80));

    assert!(cache.get("session_key").is_none());
}- Evidencia observable: Llamadas a
std::thread::sleep,tokio::time::sleepo comparaciones directas contraSystemTime::now()dentro de funciones de prueba unitaria. - Hipótesis del problema: El componente bajo prueba está acoplado rígidamente al hardware de reloj del sistema operativo, impidiendo la simulación determinista del paso del tiempo.
- Consecuencia concreta: Pruebas lentas que degradan la productividad diaria y fallan de forma errática en servidores de integración continua sobrecargados.
- Tratamiento mínimo justificado:
- Extraer la consulta del tiempo a un puerto
trait Clock { fn now(&self) -> Timestamp; }. - Implementar un adaptador
SystemClockpara el binario de producción. - Inyectar un
FrozenClockoManualClocken las pruebas unitarias para adelantar el tiempo virtual mediante una simple asignación matemática.
- Cuándo NO refactorizar: En una prueba de integración de caja negra de muy alto nivel diseñada específicamente para verificar que el temporizador nativo del sistema operativo o el runtime de Tokio despierta correctamente un worker en segundo plano tras un intervalo real.
Criterio de salida#
Puedes considerar superada esta lección cuando:
- Puedes enunciar los 6 pasos del método científico de depuración y aplicarlos para formular una hipótesis falsable antes de modificar código.
- Comprendes la diferencia entre pruebas de caracterización y pruebas de especificación según Michael Feathers.
- Tu código erradica esperas ciegas con
thread::sleep, logrando pruebas temporales instantáneas y deterministas mediante inyección detrait Clock. - Has diagnosticado y corregido la condición de frontera en
insert_sorteddemostrando el ciclo RED arrow GREEN arrow REFACTOR en tu terminal. - Puedes argumentar por qué la verificación de estado es preferible a la verificación excesiva de interacciones para facilitar refactorizaciones futuras.
- Todos tus programas de prueba compilan y pasan exitosamente con
rustc --test.
Lecturas oficiales#
- Rust Book, pruebas automatizadas: Consulta la guía canónica sobre pruebas unitarias y de integración en Rust.
- Cargo test reference: Aprende a filtrar pruebas, ejecutar pruebas ignoradas y formatear salidas de test.
- Playwright, introducción: Conoce el rol y alcance real de las pruebas de navegador en la cúspide de la pirámide de pruebas.
- Michael Feathers, Working Effectively with Legacy Code: La referencia definitiva sobre pruebas de caracterización y técnicas de refactorización de código heredado.
- Glosario técnico del curso: Consulta definiciones canónicas de términos avanzados y referencias cruzadas.
Siguiente paso#
Continúa con 16. Autenticación y autorización, donde entrarás en el módulo de operaciones y seguridad para proteger recursos mediante tokens de sesión y control de acceso basado en roles. Para revisar las respuestas detalladas y el código canónico de esta lección, consulta la guía de respuestas de diseño.