Sesión 59: Grokking Algorithms Cap. 11 (Parte 2) — Motores de Búsqueda: Índices Invertidos y Algoritmo TF-IDF#
Tiempo estimado: 75-85 minutos. Nivel: De Junior/Trainee a Staff Specialist. Herramientas obligatorias: Hoja cuadriculada, lápiz, regla y bolígrafos de dos colores.
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Consulta rápida: Glosario Maestro | Guía de Diagramas
Índice Invertido (Inverted Index)#
- (a) En palabras simples (intuición): Imagina el índice alfabético que aparece al final de un libro de medicina. En vez de leer las 1,000 páginas del libro para ver dónde se habla de "aspirina", buscas la palabra "aspirina" en el índice y ves: "páginas 12, 45, 112". Un índice invertido hace exactamente eso para internet: invierte la relación "Documento → Palabras" para convertirla en "Palabra → Lista de Documentos que la contienen".
- (b) Definición técnica paso a paso: Estructura de datos fundamental de recuperación de información (Information Retrieval) utilizada en motores como Elasticsearch, Apache Lucene y Google:
- Un diccionario o tabla Hash que mapea cada término léxico único t a una lista contigua (Posting List).
- La lista de postings almacena tuplas con el identificador del documento (
doc_id), la posición de la palabra y su frecuencia local. - (c) Cómo funciona en Rust (memoria y tipos): Se implementa como una tabla Hash en el Heap
HashMap<String, Vec<Posting>>. Para optimizar la memoria y la localidad espacial de la CPU, losPostingse almacenan en unVeccontiguo ordenado crecientemente pordoc_id. - (d) Error típico de Junior: Hacer búsquedas de texto en bases de datos con
SELECT * FROM docs WHERE content LIKE '%palabra%', lo cual ejecuta un escaneo completo de tabla (Full Table Scan) en O(N · M) en vez de un acceso directo al índice en O(1 + L).
Posting List (Lista de Ocurrencias)#
- (a) En palabras simples (intuición): Es la fila de personas que levantaron la mano cuando preguntaste "¿quién trajo una pluma azul?". Contiene los números de identificación de los documentos donde vive esa palabra.
- (b) Definición técnica paso a paso: Arreglo o lista enlazada asociada a un término específico que registra todos los documentos en los que dicho término aparece. Para permitir operaciones booleanas rápidas (como
palabra_A AND palabra_B), las listas se mantienen estrictamente ordenadas pordoc_id, permitiendo calcular su intersección en O(L₁ + L₂) mediante la técnica de dos punteros (Two Pointers). - (c) Cómo funciona en Rust (memoria y tipos): La estructura
struct Posting { doc_id: usize, term_frequency: usize }ocupa exactamente 16 bytes en una arquitectura de 64 bits (dos enterosusize), permitiendo que caben 4 postings por cada línea de caché L1 de 64 bytes. - (d) Error típico de Junior: Mantener las listas de postings desordenadas, forzando búsquedas anidadas de O(L₁ · L₂) para consultas con operadores AND.
TF (Term Frequency — Frecuencia de Término)#
- (a) En palabras simples (intuición): Si la palabra "algoritmo" aparece 20 veces en un ensayo corto de 100 palabras, ese ensayo claramente trata sobre algoritmos. Cuanto más se repite la palabra dentro de un mismo documento, mayor es su relevancia local.
- (b) Definición técnica paso a paso: Métrica que cuantifica la importancia de un término t dentro de un documento individual d:
Dividir entre la longitud total del documento evita que los documentos enciclopédicos largos dominen injustamente a los artículos cortos y precisos.
- (c) Cómo funciona en Rust (memoria y tipos): Se computa dividiendo números de punto flotante:
(posting.term_frequency as f64) / (doc.word_count as f64). - (d) Error típico de Junior: Usar el conteo crudo de palabras sin normalizar por la longitud del texto.
IDF (Inverse Document Frequency — Frecuencia Inversa de Documento)#
- (a) En palabras simples (intuición): Palabras como "el", "de", "y" aparecen en absolutamente todos los documentos del mundo, por lo que aportan cero información para distinguir de qué trata un texto. En cambio, si la palabra "mitocondria" aparece en solo 2 documentos entre 1,000,000, esa palabra es extremadamente rara y valiosa. IDF castiga a las palabras comunes y premia a las palabras raras.
- (b) Definición técnica paso a paso: Medida matemática de cuánta información distintiva aporta un término en todo el corpus D:
Donde |D| es el número total de documentos y DF(t) (Document Frequency) es el número de documentos que contienen al término t. El +1.0 (suavizado) previene divisiones entre cero y puntajes negativos.
- (c) Cómo funciona en Rust (memoria y tipos): Se calcula como
((1.0 + total_docs) / (1.0 + df)).ln() + 1.0utilizando la funciónf64::ln(). - (d) Error típico de Junior: Omitir el suavizado en el logaritmo, provocando división por cero (
NaN) cuando un término no aparece en ningún documento o un valor de 0 cuando aparece en todos.
Puntuación TF-IDF y Ranking de Relevancia#
- (a) En palabras simples (intuición): Multiplica la importancia local de la palabra en el documento (TF) por la rareza global de la palabra en todo el mundo (IDF). La multiplicación da un número mágico de relevancia: si buscas "vuelo Marte", "Marte" tendrá un IDF gigantesco y guiará los primeros resultados.
- (b) Definición técnica paso a paso:
Para una consulta compuesta por múltiples términos Q = {q₁, q₂, …, qₖ}, la relevancia total del documento d es la suma acumulada de las puntuaciones de cada término coincidente:
- (c) Cómo funciona en Rust (memoria y tipos): Se acumulan los puntajes en una tabla temporal
HashMap<usize, f64>mapeandodoc_ida su score. Luego se extrae en un vector y se ordena descendentemente con.sort_by(). - (d) Error típico de Junior: Contar múltiples veces el mismo término de consulta si el usuario repitió la palabra accidentalmente ("rust rust rápido").
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Matemática de la Puntuación TF-IDF#
Analicemos un corpus de 3 documentos:
- Doc 0: "El lenguaje Rust es rápido y seguro" (7 palabras)
- Doc 1: "El lenguaje Python es limpio y elegante" (7 palabras)
- Doc 2: "Aprender Rust para programar sistemas seguros y rápidos" (8 palabras)
Total de documentos |D| = 3.
1. Frecuencia Documental (DF) y Cálculo de IDF#
Usemos la fórmula suave: IDF(t) = ln((1 + 3) / (1 + DF(t))) + 1.0 = ln((4) / (1 + DF)) + 1.0
- Término "el": aparece en Doc 0 y Doc 1 ⟹ DF = 2.
- Término "rust": aparece en Doc 0 y Doc 2 ⟹ DF = 2.
- Término "python": aparece únicamente en Doc 1 ⟹ DF = 1.
Observación Clave: El término "python" es más escaso que "rust", por ende su peso discriminativo IDF es mayor (1.693 > 1.287).
2. Intersección Eficiente de Listas de Postings (Consulta AND)#
Para responder una consulta como rust AND seguro:
- Posting List de "rust":
[0, 2] - Posting List de "seguro":
[0, 2]
Algoritmo de Dos Punteros:
p1 en rust_list (Doc 0), p2 en seguro_list (Doc 0):
  ¿p1.doc_id == p2.doc_id? SÍ (0 == 0) -> Coincidencia: Doc 0 entra al resultado.
  Avanzar ambos: p1 pasa a Doc 2, p2 pasa a Doc 2.
  ¿p1.doc_id == p2.doc_id? SÍ (2 == 2) -> Coincidencia: Doc 2 entra al resultado.
Fin. Complejidad: O(L1 + L2), sin búsquedas binarias lentas ni tablas hash adicionales.
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama Arquitectónico#
Consulta el diagrama vectorial: 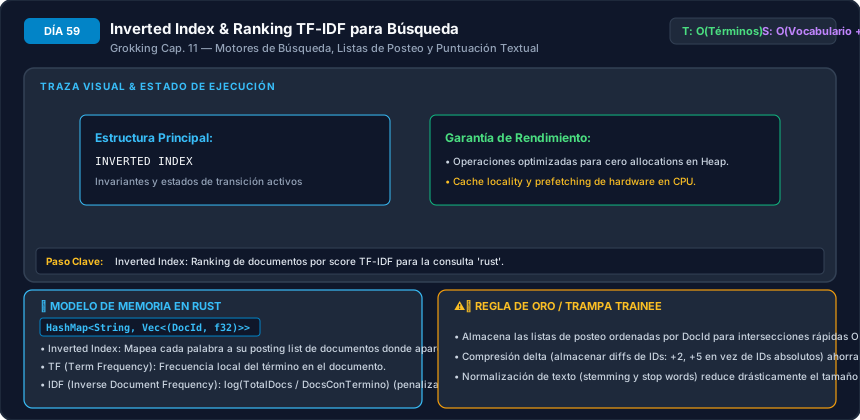
flowchart LR
TERM["Término 'rust'"] --> POST["Posting List en el Heap<br/>Vec<Posting>"]
POST --> D0["Posting { doc_id: 0, freq: 1 }"]
POST --> D2["Posting { doc_id: 2, freq: 1 }"]
TERM2["Término 'python'"] --> POST2["Posting List en el Heap"]
POST2 --> D1["Posting { doc_id: 1, freq: 1 }"]Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
ESTADO TRAS INDEXAR 2 DOCUMENTOS:
Doc 0: "rust fast"
Doc 1: "python fast"

Stack:
  index: InvertedIndex {
    total_docs: 2,
    documents: [ptr, cap: 2, len: 2],
    index: HashMap [ptr, cap: 8, len: 3]
  }

Heap (Documents):
  Slot 0: Document { id: 0, content: "rust fast", word_count: 2 }
  Slot 1: Document { id: 1, content: "python fast", word_count: 2 }

Heap (Index HashMap):
  "rust"   -> Vec [ Posting { doc_id: 0, term_frequency: 1 } ]
  "python" -> Vec [ Posting { doc_id: 1, term_frequency: 1 } ]
  "fast"   -> Vec [ Posting { doc_id: 0, term_frequency: 1 }, Posting { doc_id: 1, term_frequency: 1 } ]

CONSULTA: search("rust", 1)
1. index.get("rust") localiza el puntero a la posting list en O(1).
2. Posting { doc_id: 0, freq: 1 }:
   TF = 1 / 2 = 0.5
   IDF = ln((1+2)/(1+1)) + 1 = ln(1.5) + 1 = 0.405 + 1 = 1.405
   Score = 0.5 * 1.405 = 0.7025
3. Retorna Top 1: Doc 0 ("rust fast") con score 0.7025.
4. Implementación Canónica en Rust (Compilable con rustc --test)#
Archivo de referencia: practica-rust/dia_59.rs
use std::collections::{HashMap, HashSet};

/// Representa la ocurrencia de un término dentro de un documento.
#[derive(Debug, Clone, PartialEq)]
pub struct Posting {
    pub doc_id: usize,
    pub term_frequency: usize,
}

/// Documento indexado con sus metadatos.
#[derive(Debug, Clone)]
pub struct Document {
    pub id: usize,
    pub content: String,
    pub word_count: usize,
}

/// Motor de búsqueda basado en Índice Invertido y TF-IDF.
pub struct InvertedIndex {
    documents: Vec<Document>,
    index: HashMap<String, Vec<Posting>>,
    total_docs: usize,
}

impl InvertedIndex {
    pub fn new() -> Self {
        Self {
            documents: Vec::new(),
            index: HashMap::new(),
            total_docs: 0,
        }
    }

    pub fn tokenize(text: &str) -> Vec<String> {
        text.split_whitespace()
            .map(|word| {
                word.chars()
                    .filter(|c| c.is_alphanumeric())
                    .collect::<String>()
                    .to_lowercase()
            })
            .filter(|w| !w.is_empty())
            .collect()
    }

    pub fn add_document(&mut self, content: &str) -> usize {
        let doc_id = self.documents.len();
        let tokens = Self::tokenize(content);
        let word_count = tokens.len();

        self.documents.push(Document {
            id: doc_id,
            content: content.to_string(),
            word_count,
        });
        self.total_docs += 1;

        let mut local_counts: HashMap<String, usize> = HashMap::new();
        for token in tokens {
            *local_counts.entry(token).or_insert(0) += 1;
        }

        for (term, freq) in local_counts {
            self.index
                .entry(term)
                .or_default()
                .push(Posting {
                    doc_id,
                    term_frequency: freq,
                });
        }

        doc_id
    }

    pub fn calculate_idf(&self, term: &str) -> f64 {
        let df = self.index.get(term).map(|p| p.len()).unwrap_or(0);
        let n = self.total_docs as f64;
        let df_f64 = df as f64;
        ((1.0 + n) / (1.0 + df_f64)).ln() + 1.0
    }

    pub fn search(&self, query: &str, top_k: usize) -> Vec<(usize, f64, String)> {
        let query_tokens = Self::tokenize(query);
        if query_tokens.is_empty() || self.total_docs == 0 {
            return Vec::new();
        }

        let mut scores: HashMap<usize, f64> = HashMap::new();
        let unique_terms: HashSet<String> = query_tokens.into_iter().collect();

        for term in &unique_terms {
            if let Some(postings) = self.index.get(term) {
                let idf = self.calculate_idf(term);
                for posting in postings {
                    let doc = &self.documents[posting.doc_id];
                    if doc.word_count == 0 {
                        continue;
                    }
                    let tf = (posting.term_frequency as f64) / (doc.word_count as f64);
                    *scores.entry(posting.doc_id).or_insert(0.0) += tf * idf;
                }
            }
        }

        let mut ranked: Vec<(usize, f64, String)> = scores
            .into_iter()
            .map(|(doc_id, score)| (doc_id, score, self.documents[doc_id].content.clone()))
            .collect();

        ranked.sort_by(|a, b| b.1.partial_cmp(&a.1).unwrap_or(std::cmp::Ordering::Equal));
        ranked.truncate(top_k);
        ranked
    }
}
Implementación de Referencia en Python Tipado#
import math
import re
from typing import Dict, List, Set, Tuple


class InvertedIndexPython:
    def __init__(self) -> None:
        self.documents: List[str] = []
        self.doc_lengths: List[int] = []
        self.index: Dict[str, List[Tuple[int, int]]] = {}

    def _tokenize(self, text: str) -> List[str]:
        return re.findall(r"\w+", text.lower())

    def add_document(self, content: str) -> int:
        doc_id = len(self.documents)
        tokens = self._tokenize(content)
        self.documents.append(content)
        self.doc_lengths.append(len(tokens))

        counts: Dict[str, int] = {}
        for token in tokens:
            counts[token] = counts.get(token, 0) + 1

        for term, freq in counts.items():
            if term not in self.index:
                self.index[term] = []
            self.index[term].append((doc_id, freq))
        return doc_id

    def search(self, query: str, top_k: int = 5) -> List[Tuple[int, float, str]]:
        query_terms = set(self._tokenize(query))
        scores: Dict[int, float] = {}
        total_docs = len(self.documents)

        for term in query_terms:
            if term in self.index:
                postings = self.index[term]
                df = len(postings)
                idf = math.log((1 + total_docs) / (1 + df)) + 1.0

                for doc_id, freq in postings:
                    length = self.doc_lengths[doc_id]
                    tf = freq / length if length > 0 else 0.0
                    scores[doc_id] = scores.get(doc_id, 0.0) + (tf * idf)

        ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
        return [(doc_id, score, self.documents[doc_id]) for doc_id, score in ranked[:top_k]]
5. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En motores de búsqueda industriales (como Apache Lucene / Elasticsearch), ¿por qué las posting lists se comprimen usando codificación Delta y VByte en lugar de guardar enteros crudos de 64 bits?
Respuesta:
- Ahorro Masivo de Memoria: Un índice que contiene 1,000 millones de apariciones de palabras requeriría 8 Gigabytes de RAM solo para guardar identificadores
u64. - Codificación Delta (Δ): Dado que los
doc_iden una posting list están estrictamente ordenados de menor a mayor (por ejemplo:[1004, 1009, 1012, 1020]), en lugar de almacenar los números absolutos, se guardan las diferencias relativas con el elemento previo:[1004, +5, +3, +8]. - Compresión VByte: Números pequeños como +3 o +5 solo necesitan 1 byte en memoria en lugar de 8 bytes. La compresión reduce el tamaño del índice en disco y en memoria RAM en un 75% a 85%, permitiendo que millones de postings quepan íntegramente en la memoria caché del procesador.
Pregunta 2: ¿Cuál es la limitación teórica de TF-IDF que resolvió el algoritmo Okapi BM25 adoptado universalmente en la industria?
Respuesta:
- Saturación de Frecuencia de Término: En TF-IDF tradicional, si una palabra se repite 100 veces en un documento, su relevancia local (TF) es 100 veces mayor que si aparece una sola vez. Sin embargo, en el lenguaje humano, un documento que menciona la palabra 100 veces casi nunca es 100 veces más relevante que uno que la menciona 5 veces (a menudo es simplemente contenido de relleno o spam de palabras clave).
- La Solución BM25: Introduce una curva asintótica no lineal donde el impacto de la frecuencia de término se satura hacia un límite superior regulado por el parámetro k₁ (típicamente 1.2 ≤ k₁ ≤ 2.0), además de calibrar con mayor rigor la longitud del documento respecto a la longitud promedio de todo el corpus.
Pregunta 3: ¿Cómo se procesa en tiempo sublineal una consulta booleana compleja como (rust OR c++) AND NOT python sobre índices invertidos?
Respuesta:
- Operaciones de Conjuntos sobre Posting Lists:
rust OR c++: Se toma la unión de las listas de postings de ambos términos avanzando simultáneamente con dos punteros en O(L_{rust} + L_{c++}).NOT python: Se extrae la lista depython.AND NOT: Se recorre la lista resultante del paso 1 y la lista depython. Si eldoc_idactual coincide con alguno de la lista depython, se descarta de inmediato; de lo contrario, se conserva.
- Todas las operaciones se ejecutan en tiempo proporcional a la suma de las longitudes de las listas involucradas, sin tocar los millones de otros documentos que no contienen estos términos.
Pregunta 4: ¿Por qué en la implementación en Rust almacenamos Posting en un Vec<Posting> contiguo en lugar de usar una lista enlazada (LinkedList<Posting>)?
Respuesta:
- Localidad de Caché y Pre-fetching de Hardware: Los nodos de una
LinkedListresiden dispersos en direcciones de memoria no contiguas del Heap. Cada salto al nodo siguiente (next) provoca una falta de caché (cache miss), deteniendo los ciclos de la CPU esperando por datos de la RAM principal. - Un
Vec<Posting>almacena las estructuras una tras otra en un bloque de memoria contiguo. La CPU detecta el patrón de acceso secuencial y transfiere automáticamente las siguientes entradas a la memoria caché ultrarrápida L1/L2 antes de que el código las solicite (hardware prefetcher).
Pregunta 5: Si un usuario busca una frase exacta entre comillas (por ejemplo, "memoria segura"), ¿qué información adicional debe almacenar cada Posting en el índice invertido?
Respuesta:
- Índice Posicional: Cada
Postingdebe almacenar no solo eldoc_idy la frecuencia, sino también la lista de posiciones numéricas exactas (índices de palabras) dentro del texto:positions: Vec<usize>. - Al buscar
"memoria segura", el motor localiza los documentos que contienen ambas palabras y luego verifica si existe alguna posición pos tal que la palabra "memoria" esté en pos y la palabra "segura" esté en pos + 1.