Sesión 30: Refuerzo y Evaluación de Linked Lists In-Place & Heaps#
Navegación rápida:
- ← Sesión 29: Evaluación — Arrays, Strings y Two Pointers
- Sesión 31: Evaluación — Stacks, Queues y Monotonic Stack →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 60-75 minutos.
- Código fuente compilado y probado:
practica-rust/dia_30.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
En esta sesión evaluamos la destreza para transformar topologías dinámicas en memoria Heap mediante reconexión in-place y orquestación jerárquica con colas de prioridad. Consulta el Glosario Maestro y la Guía de Diagramas.
Nodo Centinela (Dummy Node)#
- (a) En palabras simples (intuición): Un enganche falso que colocas al principio de una fila de vagones de tren antes de empezar a reorganizarlos. Te permite tratar al primer vagón de pasajeros exactamente igual que a cualquier vagón intermedio, evitando tener que escribir reglas especiales para cuando el primer vagón cambia de dueño.
- (b) Definición técnica paso a paso: Nodo temporal artificial instanciado al inicio de una lista (
dummy.next = head). Estandariza las operaciones de inserción, eliminación y reconexión, eliminando casos borde donde la cabeza original muta (left == 1) o la lista queda vacía. - (c) Cómo funciona en Rust (memoria y tipos): Se aloja en el Stack o como
Box<ListNode>en el Heap con un valor neutro (ListNode::new(0)). Al finalizar el algoritmo, se extrae el resultado condummy.next.take(), destruyendo el centinela automáticamente sin desbordamiento ni fugas de memoria. - (d) Error típico de Junior: Omitir el centinela y llenar el código de condicionales frágiles
if prev == nulloif left == 1, causando errores comunes de puntero nulo (NullPointerException).
Reconexión Topológica In-Place#
- (a) En palabras simples (intuición): Desconectar y reconectar cables de red en un panel de parcheo sin comprar cables nuevos ni mover los servidores de lugar. Cambias hacia dónde apunta cada conector en el aire.
- (b) Definición técnica paso a paso: Modificación de la estructura de punteros de una lista enlazada mediante reasignación de referencias (
curr.next = nxt.next, etc.) consumiendo O(1) memoria auxiliar. Se reutilizan estrictamente los nodos físicos ya existentes en memoria RAM. - (c) Cómo funciona en Rust (memoria y tipos): Exige transferir la propiedad (ownership) mediante el método estándar
Option::take(). Esto desvincula el nodo dejándolo enNonemomentáneamente, evitando violar la regla del Borrow Checker que prohíbe mover valores fuera de una referencia prestada. - (d) Error típico de Junior: Asignar copias nuevas de
ListNode(val)en un bucle, duplicando el consumo de memoria en el Heap e incumpliendo la restricción de espacio O(1).
Min-Heap para Fusión de K Vías (K-Way Merge)#
- (a) En palabras simples (intuición): Tener k barajas de cartas ordenadas sobre la mesa. En lugar de mirar todas las cartas de todas las barajas en cada turno, miras únicamente la carta superior de cada montón y las colocas en un atril de competencia. El atril siempre te entrega la carta más baja de inmediato. Cuando la tomas, destapas la siguiente carta de ese mismo montón.
- (b) Definición técnica paso a paso: Estructura de árbol binario implícito con la propiedad de montículo mínimo: la raíz siempre contiene la clave mínima. Al fusionar k secuencias ordenadas de longitud total N, el heap almacena a lo sumo k elementos a la vez. Cada extracción del mínimo y posterior inserción toma O(log k) tiempo, logrando una complejidad global de O(N log k).
- (c) Cómo funciona en Rust (memoria y tipos): Se implementa con
std::collections::BinaryHeap<Reverse<(i32, usize)>>, dondeusizeactúa como identificador determinista de la lista origen. - (d) Error típico de Junior: Guardar todos los N nodos dentro del heap simultáneamente; esto consume O(N) memoria auxiliar en vez de O(k) y degrada la velocidad a O(N log N).
Transferencia de Propiedad Segura con Option::take()#
- (a) En palabras simples (intuición): Abrir una caja fuerte para sacar una joya y reemplazarla inmediatamente por una nota que dice "vacío", todo en un solo movimiento atómico antes de que alguien más intente abrir la caja.
- (b) Definición técnica paso a paso: Método de la biblioteca estándar de Rust sobre tipos
Option<T>que extrae el valorSome(v), reemplazándolo en el contenedor original porNone, dejando la memoria en un estado consistente y válido. - (c) Cómo funciona en Rust (memoria y tipos): En
node.next.take(), Rust transfiere la posesión del punteroBox<ListNode>a la variable local en el Stack sin llamar al destructor (drop) ni requerir clonaciones profundas. - (d) Error típico de Junior: Intentar hacer
let nxt = node.next;directamente sobre una referencia mutable&mut ListNode, lo que produce el error de compilaciónE0507: cannot move out of borrowed content.
Fusión por División y Conquista (Divide and Conquer Merge)#
- (a) En palabras simples (intuición): Un torneo de tenis por eliminación directa. En lugar de que un jugador juegue uno tras otro contra los otros 100 jugadores consecutivamente, todos juegan por parejas en paralelo por rondas. En cada ronda el número de participantes se reduce a la mitad.
- (b) Definición técnica paso a paso: Paradigma algorítmico que fusiona las k listas agrupándolas en pares adyacentes de dos en dos. Tras cada ronda se reduce el número de listas a ⌈ k / 2 ⌉. Requiere ⌈ log₂ k ⌉ niveles de reducción, procesando los N nodos en cada nivel para un costo de O(N log k) con O(1) memoria auxiliar.
- (c) Cómo funciona en Rust (memoria y tipos): Se itera con pasos de
i += 2consumiendolists[i].take()ylists[i+1].take(), unificándolos conmerge_two_sorted_lists. - (d) Error típico de Junior: Fusionar secuencialmente L₁ con L₂, luego el resultado con L₃, luego con L₄; este enfoque ingenuo degenera en una complejidad cuadrática O(k · N).
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
El Colapso Cuadrático de la Fusión Secuencial vs la Superioridad de Divide & Conquer#
Consideremos k listas enlazadas, cada una con una longitud promedio de M elementos (total de nodos N = k · M).
1. Enfoque Ingenuo: Fusión Secuencial Acumulativa#
- Fusionamos L₁ y L₂: procesamos M + M = 2M nodos.
- Fusionamos el resultado anterior con L₃: procesamos 2M + M = 3M nodos.
- Fusionamos con L₄: procesamos 3M + M = 4M nodos.
- En general, para fusionar hasta la lista k:
Si k = 10,000 listas de M = 10 elementos (N = 100,000), la fusión secuencial requiere del orden de:
2. Enfoque Óptimo: Divide and Conquer (Árbol de Fusión Balanceado)#
- Nivel 0: k listas de tamaño M. Se fusionan por parejas → k/2 listas de tamaño 2M. Costo: k/2 × (2M) = N.
- Nivel 1: k/2 listas de tamaño 2M → k/4 listas de tamaño 4M. Costo: k/4 × (4M) = N.
- Altura del árbol de reducción: exactamente ⌈ log₂ k ⌉ niveles.
- Como en cada nivel se tocan exactamente todos los N nodos:
Para el mismo caso (k = 10,000, N = 100,000), log₂(10,000) ≈ 14:
¡Una aceleración de más de 700 veces en silicio real!
3. Visualización Paso a Paso y Gráfica de Memoria en Rust#
Diagramas de Arquitectura#
- Gráfico SVG vectorial:
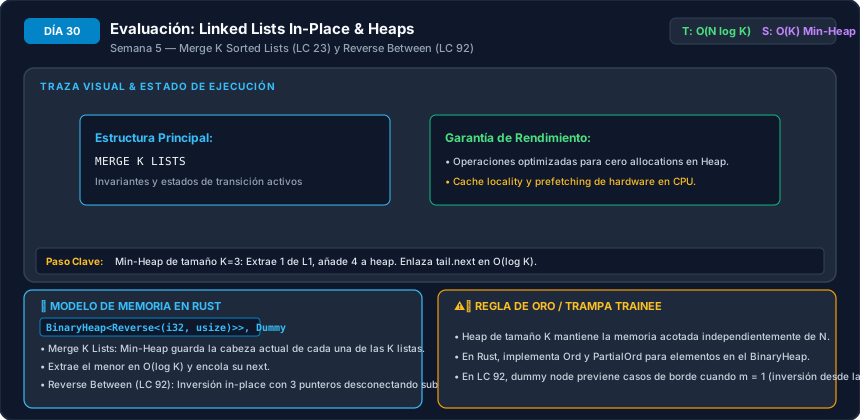 - Código fuente del diagrama: Fuente Mermaid
Flujo de Fusión K-Vías con Min-Heap#
flowchart TD
    INIT["Heap inicializado con cabezas no vacías (a lo sumo k elementos)"] --> POP["Extraer nodo con valor mínimo: min_node en O(log k)"]
    POP --> ATTACH["Enlazar min_node al final de la lista fusionada (tail.next)"]
    ATTACH --> ADVANCE["Avanzar tail = tail.next"]
    ADVANCE --> CHECK{"¿min_node.next existe?"}
    CHECK -->|Sí| PUSH["Insertar min_node.next al Heap en O(log k)"]
    CHECK -->|No| MORE{"¿Heap vacío?"}
    PUSH --> MORE
    MORE -->|No| POP
    MORE -->|Sí| RETURN["Retornar dummy.next (Lista unificada completa)"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Ejecución de reverse_between([1, 2, 3, 4, 5], left=2, right=4):
ESTADO INICIAL:
STACK                                            HEAP
+-------------------------------+               +--------------------------------------+
| Frame reverse_between         |               | (0: dummy) -> (1: p)                 |
|   left: 2, right: 4           |               |               (2: curr)              |
|   dummy: Box<ListNode> -------+-------------->|               (3)                    |
|   p: &mut ListNode            |               |               (4)                    |
+-------------------------------+               |               (5) -> None            |
                                                +--------------------------------------+

Paso 1: Avanzar `p` hasta left - 1 = 1 (nodo con valor 1).
- sub_head = p.next.take() -> Desconecta la sublista desde el nodo 2 en adelante.
  p.next queda en None.

Paso 2: Bucle de inversión para 3 nodos (right - left + 1 = 3):
- Iteración 1:
  Toma nodo 2: next = 3 -> 4 -> 5.
  node(2).next = None. prev = Some(2). curr = Some(3).
- Iteración 2:
  Toma nodo 3: next = 4 -> 5.
  node(3).next = Some(2). prev = Some(3 -> 2). curr = Some(4).
- Iteración 3:
  Toma nodo 4: next = 5.
  node(4).next = Some(3 -> 2). prev = Some(4 -> 3 -> 2). curr = Some(5).

Paso 3: Reconexión de cola y prefijo:
- Buscamos la cola de `prev` (el nodo 2).
  node(2).next = curr (nodo 5).
  Ahora `prev` representa: 4 -> 3 -> 2 -> 5.
- Reconectamos el ancla `p` con `prev`:
  p.next = prev.
  Ahora `dummy` representa: 0 -> 1 -> 4 -> 3 -> 2 -> 5.

Retornamos dummy.next: [1, 4, 3, 2, 5]. Cero memoria adicional asignada en Heap.
4. Las 3 Trampas Clásicas en Entrevistas#
- La Trampa de Comparación en Colas de Prioridad:
- En lenguajes como Python o C++, si colocas el nodo directamente en el heap sin desempate numérico único, cuando dos nodos tengan valores idénticos (
1 == 1) el entorno intentará comparar los punteros de los objetos, lanzando excepciones o comportamientos erráticos. En Rust, guardamosReverse((val, list_index)), garantizando orden unívoco sin intentar comparar referencias de nodos. - El Error de Préstamo Cruzado en Rust (
E0507): - Intentar reasignar referencias como en C++ (curr->next = nxt->next) directamente sobre una referencia mutable en Rust provocará que el compilador rechace el código. En Rust, cada nodo en el Heap tiene un único dueño indiscutible. Debes usar.take()para retirar el valor de forma segura. - Pérdida del Nodo Previo al Invertir Desde la Cabeza (
left = 1): - Si no utilizas un nodo centinela, no existe ningún nodopreprevio ahead. Intentar cubrir este caso con ramificaciones manuales duplica la complejidad lógica y suele provocar pérdidas irreparables del puntero al resto de la lista.
5. Implementación Canónica en Rust + Comparativa con Python#
Implementación Canónica en Rust (practica-rust/dia_30.rs)#
//! Día 30: Refuerzo y Evaluación de Linked Lists In-Place & Heaps en Rust.
use std::cmp::Reverse;
use std::collections::BinaryHeap;

#[derive(Debug, PartialEq, Eq, Clone)]
pub struct ListNode {
    pub val: i32,
    pub next: Option<Box<ListNode>>,
}

impl ListNode {
    pub fn new(val: i32) -> Self {
        ListNode { val, next: None }
    }
}

/// LeetCode 92: Inversión de sublista in-place en O(N) tiempo y O(1) memoria auxiliar.
pub fn reverse_between(
    head: Option<Box<ListNode>>,
    left: usize,
    right: usize,
) -> Option<Box<ListNode>> {
    if left < 1 || right < left || head.is_none() || left == right {
        return head;
    }

    let mut dummy = Box::new(ListNode::new(0));
    dummy.next = head;

    let mut p = &mut dummy;
    for _ in 0..(left - 1) {
        if p.next.is_none() {
            return dummy.next;
        }
        p = p.next.as_mut().unwrap();
    }

    let sub_head = p.next.take();
    let num_nodes = right - left + 1;

    let mut prev = None;
    let mut curr = sub_head;

    for _ in 0..num_nodes {
        if let Some(mut node) = curr {
            let next = node.next.take();
            node.next = prev;
            prev = Some(node);
            curr = next;
        } else {
            break;
        }
    }

    let mut tail_ref = &mut prev;
    while let Some(ref mut node) = tail_ref {
        if node.next.is_none() {
            node.next = curr;
            break;
        }
        tail_ref = &mut node.next;
    }

    p.next = prev;
    dummy.next
}

/// LeetCode 23: Merge k Sorted Lists mediante Min-Heap en O(N log k).
pub fn merge_k_lists_heap(mut lists: Vec<Option<Box<ListNode>>>) -> Option<Box<ListNode>> {
    let k = lists.len();
    if k == 0 {
        return None;
    }

    let mut min_heap = BinaryHeap::new();
    for i in 0..k {
        if let Some(ref node) = lists[i] {
            min_heap.push(Reverse((node.val, i)));
        }
    }

    let mut dummy = Box::new(ListNode::new(0));
    let mut tail = &mut dummy;

    while let Some(Reverse((_val, list_idx))) = min_heap.pop() {
        let mut min_node = lists[list_idx].take().unwrap();
        lists[list_idx] = min_node.next.take();

        if let Some(ref next_node) = lists[list_idx] {
            min_heap.push(Reverse((next_node.val, list_idx)));
        }

        tail.next = Some(min_node);
        tail = tail.next.as_mut().unwrap();
    }

    dummy.next
}
Implementación Canónica en Python (practica/dia_30_linked_lists_heaps.py)#
import heapq
from typing import List, Optional, Tuple

class ListNode:
    def __init__(self, val: int = 0, next: Optional["ListNode"] = None):
        self.val = val
        self.next = next

def reverse_between(head: Optional[ListNode], left: int, right: int) -> Optional[ListNode]:
    """LC 92: Inversión in-place con reconexión de sub-segmento en O(N) tiempo y O(1) espacio."""
    if not head or left == right:
        return head

    dummy = ListNode(0, head)
    pre = dummy
    for _ in range(left - 1):
        pre = pre.next

    curr = pre.next
    for _ in range(right - left):
        nxt = curr.next
        curr.next = nxt.next
        nxt.next = pre.next
        pre.next = nxt

    return dummy.next

def merge_k_lists_heap(lists: List[Optional[ListNode]]) -> Optional[ListNode]:
    """LC 23: Fusión de K listas con Min-Heap en O(N log k) tiempo y O(k) espacio."""
    min_heap: List[Tuple[int, int, ListNode]] = []
    dummy = ListNode(0)
    curr = dummy
    counter = 0

    for node in lists:
        if node:
            heapq.heappush(min_heap, (node.val, counter, node))
            counter += 1

    while min_heap:
        _, _, min_node = heapq.heappop(min_heap)
        curr.next = min_node
        curr = curr.next
        if min_node.next:
            heapq.heappush(min_heap, (min_node.next.val, counter, min_node.next))
            counter += 1

    return dummy.next
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En LeetCode 23, ¿por qué la complejidad temporal de la técnica Divide & Conquer es O(N log k) y no depende de la distribución de longitudes de las listas individuales?
Respuesta Técnica Detallada: Sean k listas de tamaños arbitrarios n₁, n₂, …, nₖ tales que sum_{i=1}ᵏ nᵢ = N. El árbol de fusión Divide & Conquer tiene exactamente ⌈ log₂ k ⌉ niveles de profundidad. En cada nivel j del árbol, cada uno de los N nodos totales participa en exactamente una operación de comparación y reconexión dentro de una llamada a merge_two_sorted_lists. Por consiguiente, el trabajo total efectuado en cualquier nivel individual es exactamente igual a la suma de los tamaños de todas las listas presentes en ese nivel, la cual es invariablemente N. Multiplicando el trabajo constante por nivel (N) por la altura total del árbol (log₂ k), el costo temporal queda estrictamente acotado por:
Esto demuestra que la cota se sostiene sin importar si las listas tienen longitudes simétricas o si una es enorme y las demás son minúsculas.
Pregunta 2: ¿Qué sucedería en la memoria física de Rust si intentáramos desconectar un nodo de una lista usando let nxt = curr.next; sin invocar .take()?
Respuesta Técnica Detallada: El compilador de Rust detendría el proceso emitiendo el error: error[E0507]: cannot move out of curr.next which is behind a mutable reference. En Rust:
curres una referencia prestada de tipo&mut ListNode.- El campo
curr.nextcontiene un tipo propietarioOption<Box<ListNode>>que no implementa el traitCopy. - Mover el valor fuera de
curr.nextdejaría el campo original sin inicializar en un estado de memoria corrupto ("agujero de memoria"). Si la función entrara en pánico o el dueño decurrintentara liberar la lista más tarde, el destructor (Drop) intentaría liberar memoria inválida.
Option::take() resuelve esto a nivel de instrucciones del compilador: extrae el valor Some(...) y deja un None perfectamente válido en la celda de memoria original en una única operación atómica segura.
Pregunta 3: ¿Cuáles son los tradeoffs prácticos entre resolver Merge K Sorted Lists usando un Min-Heap frente a usar Divide and Conquer?
Respuesta Técnica Detallada:
- Min-Heap:
- Ventaja: Es un algoritmo *en línea (online) y de flujo continuo (streaming)*. Si las k listas provienen de conexiones de red independientes o lecturas lentas de disco, el heap solo necesita conocer el primer elemento de cada stream para comenzar a emitir resultados en tiempo real sin esperar a que todos los datos estén presentes.
- Desventaja: Requiere memoria auxiliar O(k) para almacenar los elementos del montículo.
- Divide and Conquer:
- Ventaja: Opera con O(1) memoria auxiliar en su versión iterativa, logrando un uso de caché sumamente eficiente al fusionar listas completas de manera secuencial.
- Desventaja: Requiere tener todas las listas completas disponibles en memoria antes de poder iniciar el proceso de reducción jerárquica.
Pregunta 4: En LeetCode 92 (Reverse Linked List II), ¿por qué es matemáticamente imposible que la lista quede particionada en dos mitades desconectadas si se implementa la técnica de inserción al frente con ancla pre?
Respuesta Técnica Detallada: Porque la invariante de ciclo garantiza que los tres punteros forman una cerradura topológica continua en cada iteración:
curr.next = nxt.next: asegura que la cola móvilcurrsiempre preserve el enlace hacia el remanente no procesado de la lista original.nxt.next = pre.next: enlaza el nodo recién movidonxthacia el frente del segmento ya invertido.pre.next = nxt: enlaza el ancla fija previa con el nuevo frente de la lista.
En ningún momento del ciclo existe un puntero suelto o nulo en el camino desde dummy hasta el último nodo de la lista. La conectividad física de la estructura es completa e indivisible en todo instante.
Pregunta 5: ¿Cómo se adapta la lógica de LeetCode 92 para resolver el problema LeetCode 25 (Reverse Nodes in k-Group)?
Respuesta Técnica Detallada: LeetCode 25 consiste en aplicar la inversión de sublista de forma modular y repetitiva:
- Contamos el número total de nodos en la lista: N.
- El número total de grupos completos que deben invertirse es ⌊ N / k ⌋.
- Inicializamos un centinela
dummyy un anclapre = dummy. - Ejecutamos un bucle exterior que se repite ⌊ N / k ⌋ veces. En cada ronda:
- Identificamos
curr = pre.next. - Ejecutamos el bucle interno de inversión exactamente k - 1 veces. - Al finalizar la inversión del grupo,currhabrá quedado en la cola del grupo invertido. - Avanzamos el anclapre = curry continuamos con el siguiente grupo.
Los nodos sobrantes (N ±od k) quedan intactos al final. La complejidad resultante es O(N) tiempo y O(1) memoria auxiliar.
7. Puente a LeetCode y Práctica de Código#
- LeetCode 92 — Reverse Linked List II (Medium): - Implementa la reconexión de punteros in-place con centinela.
- LeetCode 23 — Merge k Sorted Lists (Hard): - Resuelve el problema implementando ambas técnicas: Min-Heap y Divide & Conquer.
- LeetCode 25 — Reverse Nodes in k-Group (Hard): - Desafío supremo de listas enlazadas: combina la inversión de sub-segmentos de LC 92 repetitivamente por bloques de tamaño k.
- LeetCode 21 — Merge Two Sorted Lists (Easy): - Práctica del bloque base constructivo de fusión in-place con puntero centinela.
8. Tarea en Papel para Hoy#
Toma una hoja y un lápiz:
- Dibuja la lista enlazada
[10, 20, 30, 40]conleft = 1, right = 3. - Dibuja el nodo
dummyen la posición previa a 10. - Muestra gráficamente cómo se desconecta el nodo 20 y luego el 30, dibujando los punteros reasignados.
- Anota el estado final de la lista resultante y verifica que la cabeza definitiva sea el nodo 30.
Navegación: