Sesión 65: Test Diagnóstico 2 — Tries Compuestos y Conjuntos Disjuntos Avanzados: Accounts Merge (LeetCode 721 & 211)#
Tiempo estimado: 75-85 minutos. Nivel: De Junior/Trainee a Staff Specialist. Herramientas obligatorias: Hoja cuadriculada, lápiz, regla y bolígrafos de dos colores.
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Consulta rápida: Glosario Maestro | Guía de Diagramas
Disjoint Set Union (DSU / Union-Find)#
- (a) En palabras simples (intuición): Imagina que varios grupos de amigos se van uniendo en una fiesta. Cada grupo elige a un líder representativo. Si dos personas quieren saber si están en el mismo grupo, ambas preguntan quién es su líder final: si tienen el mismo líder, ya son del mismo grupo; si tienen líderes distintos y deciden fusionarse, el líder de un grupo se arrodilla ante el líder del otro.
- (b) Definición técnica paso a paso: Estructura de datos que gestiona una partición de un conjunto en subconjuntos disjuntos:
find(i): Determina a qué conjunto pertenece el elemento i, retornando la raíz canónica del árbol.union(i, j): Fusiona los conjuntos que contienen a i y a j.- Combinando Path Compression y Union by Rank, la complejidad amortizada por operación es O(α(N)), donde α es la función inversa de Ackermann (α(N) ≤ 4 para cualquier N menor que el número de átomos en el universo observable).
- (c) Cómo funciona en Rust (memoria y tipos): Se implementa con dos vectores contiguos en el Heap:
parent: Vec<usize>yrank: Vec<usize>. Cero punteros inseguros ni referencias cíclicas. - (d) Error típico de Junior: Implementar
findsin compresión de ruta, lo que degrada el árbol a una lista enlazada degenerada con costo O(N) por consulta.
Compresión de Ruta (Path Compression)#
- (a) En palabras simples (intuición): Cuando subes por una cadena de 5 personas para averiguar quién es el jefe supremo, en lugar de bajar y olvidar el camino, tomas a todas las personas del camino de la mano y las conectas directamente al jefe supremo. La próxima vez que pregunten, están a un solo paso de distancia.
- (b) Definición técnica paso a paso: Optimización en la función
find:
  let root = self.find(self.parent[i]);
  self.parent[i] = root; // Aplana el árbol directamente hacia la raíz
  root
Cada nodo visitado durante la búsqueda actualiza su puntero de padre para apuntar inmediatamente a la raíz global.
- (c) Cómo funciona en Rust (memoria y tipos): Se ejecuta en el desenrollado del Call Stack de la recursión, mutando el vector
parentin-place. - (d) Error típico de Junior: Asumir que la compresión de ruta hace que
rankpierda validez; el rango se mantiene como una cota superior aproximada de altura (upper bound) para no gastar tiempo reajustándolo.
Fusión de Cuentas (Accounts Merge — LeetCode 721)#
- (a) En palabras simples (intuición): Tienes una lista de usuarios con sus correos electrónicos. Si "Juan" tiene el correo
AyB, y en otro registro otro "Juan" tiene el correoByC, como ambos comparten el correoB, sabes con certeza absoluta que son la misma persona física. Debes unir todas las cuentas que compartan al menos un correo y listar los correos únicos ordenados alfabéticamente. - (b) Definición técnica paso a paso: Problema de modelado de componentes conexas en un grafo donde los correos son nodos y cada cuenta define aristas entre su primer correo y los restantes. Tras ejecutar
dsu.union(), las raíces del DSU identifican a los individuos únicos. - (c) Cómo funciona en Rust (memoria y tipos): Se usa un
HashMap<String, usize>para mapear cadenas de correos a IDs enteros compactos, unDsusobre enteros, y unBTreeSet<String>para agrupar y ordenar automáticamente los correos de cada persona en O(L log L). - (d) Error típico de Junior: Intentar fusionar cuentas comparando pares con bucles anidados O(N²), lo que agota el tiempo de ejecución ante miles de cuentas.
Trie de Prefijos con Búsqueda de Comodines (LeetCode 211)#
- (a) En palabras simples (intuición): Un árbol de letras donde cada palabra comparte el camino de sus letras iniciales. Si buscas "c.rro", el punto
.es un comodín que dice: "prueba con todas las letras del abecedario en esta posición". Si alguna rama continúa hacia "carro" o "cerro", la búsqueda triunfa. - (b) Definición técnica paso a paso: Estructura de árbol 26-ario donde cada nodo representa un carácter. Para procesar el comodín
., la búsqueda se bifurca mediante DFS explorando todos los hijos no nulos del nodo actual. - (c) Cómo funciona en Rust (memoria y tipos): Para optimizar la memoria y evitar la fragmentación de punteros individuales en el Heap, se implementa mediante una Arena de Nodos (
Vec<TrieNode>), donde cada nodo guardachildren: [Option<usize>; 26]. - (d) Error típico de Junior: Instanciar nodos con
Box<TrieNode>oRc<RefCell<TrieNode>>, consumiendo overhead masivo de metadatos por nodo y destruyendo la localidad de caché.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Reducción de Accounts Merge a Componentes Conexas#
Consideremos la entrada:
- Cuenta 1: John →
[johnsmith@mail.com, john_newyork@mail.com] - Cuenta 2: John →
[johnsmith@mail.com, john00@mail.com] - Cuenta 3: Mary →
[mary@mail.com] - Cuenta 4: John →
[johnnybravo@mail.com]
- Mapeo a Identificadores Enteros:
-
johnsmith@mail.com→ ID 0 -john_newyork@mail.com→ ID 1 -john00@mail.com→ ID 2 -mary@mail.com→ ID 3 -johnnybravo@mail.com→ ID 4
- Uniones en el DSU:
- Cuenta 1: une ID 0 con ID 1 ⟹
{0, 1}forman un conjunto. - Cuenta 2: une ID 0 con ID 2 ⟹{0, 1, 2}se fusionan en un único conjunto. - Cuenta 3: ID 3 (Mary) queda aislado ⟹{3}. - Cuenta 4: ID 4 (Johnny Bravo) queda aislado ⟹{4}.
- Agrupación y Ordenamiento:
- Raíz de {0, 1, 2} → Nombre: "John", Emails ordenados:
[john00@mail.com, john_newyork@mail.com, johnsmith@mail.com]. - Raíz de {3} → Nombre: "Mary", Emails:[mary@mail.com]. - Raíz de {4} → Nombre: "John", Emails:[johnnybravo@mail.com].
¡El algoritmo detecta con precisión matemática que los dos primeros Johns son la misma persona, mientras que el tercer John es un individuo completamente distinto!
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama Arquitectónico de Fusión#
Consulta el diagrama vectorial: 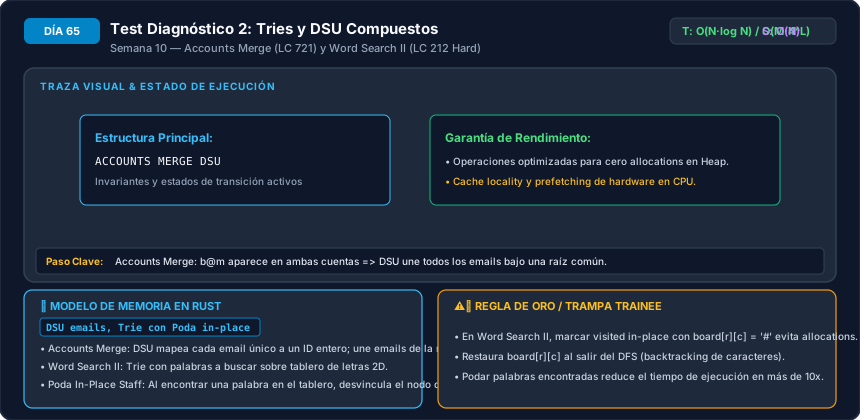
flowchart LR
    E0["ID 0: johnsmith@mail.com"] --> UNION["DSU Union"]
    E1["ID 1: john_newyork@mail.com"] --> UNION
    E2["ID 2: john00@mail.com"] --> UNION
    UNION --> COMP["Componente Conexa Única (Raíz Canónica)<br/>Propietario: John"]

    M3["ID 3: mary@mail.com"] --> COMP2["Componente Conexa Independiente<br/>Propietaria: Mary"]
    J4["ID 4: johnnybravo@mail.com"] --> COMP3["Componente Conexa Independiente<br/>Propietario: John (Bravo)"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Evolución del DSU en el Heap (parent: Vec<usize>):
ESTADO INICIAL (5 emails registrados, cada uno es su propio padre):
Heap parent: [0, 1, 2, 3, 4]
Heap rank:   [0, 0, 0, 0, 0]

PASO 1: union(0, 1) // johnsmith y john_newyork
  root(0) = 0, root(1) = 1
  rank iguales -> parent[1] = 0, rank[0] += 1
Heap parent: [0, 0, 2, 3, 4]
Heap rank:   [1, 0, 0, 0, 0]

PASO 2: union(0, 2) // johnsmith y john00
  root(0) = 0, root(2) = 2
  rank[0] (1) > rank[2] (0) -> parent[2] = 0
Heap parent: [0, 0, 0, 3, 4]
Heap rank:   [1, 0, 0, 0, 0]

CONSULTA: find(2) con Path Compression:
  parent[2] ya es 0 -> retorna 0 en O(1).
  Emails con raíz 0: {0: johnsmith, 1: john_newyork, 2: john00}.
4. Implementación Canónica en Rust (Compilable con rustc --test)#
Archivo de referencia: practica-rust/dia_65.rs
use std::collections::{BTreeSet, HashMap};

pub struct Dsu {
    parent: Vec<usize>,
    rank: Vec<usize>,
}

impl Dsu {
    pub fn new(size: usize) -> Self {
        Self {
            parent: (0..size).collect(),
            rank: vec![0; size],
        }
    }

    pub fn find(&mut self, i: usize) -> usize {
        if self.parent[i] == i {
            i
        } else {
            let root = self.find(self.parent[i]);
            self.parent[i] = root;
            root
        }
    }

    pub fn union(&mut self, i: usize, j: usize) -> bool {
        let root_i = self.find(i);
        let root_j = self.find(j);
        if root_i == root_j {
            return false;
        }

        if self.rank[root_i] < self.rank[root_j] {
            self.parent[root_i] = root_j;
        } else if self.rank[root_i] > self.rank[root_j] {
            self.parent[root_j] = root_i;
        } else {
            self.parent[root_j] = root_i;
            self.rank[root_i] += 1;
        }
        true
    }
}

pub fn accounts_merge(accounts: Vec<Vec<String>>) -> Vec<Vec<String>> {
    let mut email_to_id: HashMap<String, usize> = HashMap::new();
    let mut email_to_name: HashMap<String, String> = HashMap::new();
    let mut id_to_email: Vec<String> = Vec::new();

    for acc in &accounts {
        let name = &acc[0];
        for email in acc.iter().skip(1) {
            if !email_to_id.contains_key(email) {
                let id = id_to_email.len();
                email_to_id.insert(email.clone(), id);
                id_to_email.push(email.clone());
                email_to_name.insert(email.clone(), name.clone());
            }
        }
    }

    let mut dsu = Dsu::new(id_to_email.len());
    for acc in &accounts {
        if acc.len() < 2 {
            continue;
        }
        let first_id = email_to_id[&acc[1]];
        for email in acc.iter().skip(2) {
            dsu.union(first_id, email_to_id[email]);
        }
    }

    let mut root_to_emails: HashMap<usize, BTreeSet<String>> = HashMap::new();
    for (email, &id) in &email_to_id {
        let root = dsu.find(id);
        root_to_emails.entry(root).or_default().insert(email.clone());
    }

    let mut result: Vec<Vec<String>> = Vec::new();
    for (_, emails) in root_to_emails {
        let first_email = emails.iter().next().unwrap();
        let name = email_to_name[first_email].clone();
        let mut row = Vec::with_capacity(emails.len() + 1);
        row.push(name);
        row.extend(emails);
        result.push(row);
    }
    result
}
Implementación de Referencia en Python Tipado#
from collections import defaultdict
from typing import Dict, List, Set


class DsuPython:
    def __init__(self, size: int) -> None:
        self.parent = list(range(size))
        self.rank = [0] * size

    def find(self, i: int) -> int:
        if self.parent[i] == i:
            return i
        self.parent[i] = self.find(self.parent[i])
        return self.parent[i]

    def union(self, i: int, j: int) -> bool:
        root_i, root_j = self.find(i), self.find(j)
        if root_i == root_j:
            return False
        if self.rank[root_i] < self.rank[root_j]:
            self.parent[root_i] = root_j
        elif self.rank[root_i] > self.rank[root_j]:
            self.parent[root_j] = root_i
        else:
            self.parent[root_j] = root_i
            self.rank[root_i] += 1
        return True


def accounts_merge_py(accounts: List[List[str]]) -> List[List[str]]:
    email_to_id: Dict[str, int] = {}
    email_to_name: Dict[str, str] = {}
    id_to_email: List[str] = []

    for acc in accounts:
        name = acc[0]
        for email in acc[1:]:
            if email not in email_to_id:
                eid = len(id_to_email)
                email_to_id[email] = eid
                id_to_email.append(email)
                email_to_name[email] = name

    dsu = DsuPython(len(id_to_email))
    for acc in accounts:
        if len(acc) > 1:
            first = email_to_id[acc[1]]
            for email in acc[2:]:
                dsu.union(first, email_to_id[email])

    groups = defaultdict(list)
    for email, eid in email_to_id.items():
        root = dsu.find(eid)
        groups[root].append(email)

    return [[email_to_name[emails[0]]] + sorted(emails) for emails in groups.values()]
5. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En LeetCode 721, ¿por qué es incorrecto usar los nombres de los usuarios como identificadores para unir en el DSU?
Respuesta:
- Homónimos y Ambigüedad de Nombres:
- En el mundo real y en la especificación del problema, dos personas completamente distintas pueden llamarse "John".
- Si unimos por nombre, todas las personas llamadas "John" terminarían fusionadas en un único superusuario gigante con los emails de decenas de personas diferentes.
- La clave de identidad única global son exclusivamente las direcciones de correo electrónico (
email). El nombre solo se utiliza como etiqueta descriptiva final.
Pregunta 2: ¿Cuál es la cota matemática de la función Inversa de Ackermann α(N) y por qué se considera prácticamente O(1) en ingeniería?
Respuesta:
- Crecimiento Hiper-Exponencial de Ackermann:
- La función de Ackermann A(m, n) crece a una velocidad inconcebible: A(4, 2) es un número que tiene más de 19,729 dígitos decimales.
- La función inversa α(N) calcula el menor entero k tal que A(k, 1) ≥ N.
- Para cualquier valor de N ≤ 2^{2^{2⁶⁵⁵³⁶}}, el valor de α(N) es estrictamente menor o igual a 4.
- Dado que no existen computadoras ni conjuntos de datos que excedan esta cantidad, cada operación
findounionen DSU toma a lo sumo 4 pasos, lo que equivale a un tiempo de ejecución constante O(1) en sistemas físicos reales.
Pregunta 3: ¿Por qué usamos BTreeSet<String> en Rust para agrupar los correos electrónicos en lugar de un HashSet<String>?
Respuesta:
- Requerimiento de Ordenamiento Léxico:
- La especificación de LeetCode 721 exige que la lista de emails de cada cuenta fusionada esté estrictamente ordenada de forma alfabética creciente.
HashSetalmacena los elementos sin ningún orden predecible, lo que requeriría recolectar todos los emails en un vector intermedio y llamar a.sort()explícitamente.BTreeSetmantiene los elementos ordenados en todo momento mediante su árbol B interno, garantizando que el iterador.iter()recorra los correos en orden léxico de menor a mayor automáticamente sin pasos adicionales.
Pregunta 4: En la implementación del Trie con comodín . (LeetCode 211), ¿cuál es la complejidad temporal en el peor caso y cómo se previene una explosión combinatoria?
Respuesta:
- Complejidad con Comodines Múltiples:
- Si una consulta contiene una cadena de puros puntos
.....de longitud L, en cada paso el algoritmo debe bifurcar y explorar los 26 hijos posibles del abecedario. - En el peor escenario teórico, la complejidad es O(26^L).
- Mitigación en Sistemas de Producción:
1. Si un nodo no tiene hijos activos (
None), la rama se poda de inmediato (pruning) sin explorar el resto del árbol. 2. Se limita la longitud máxima de comodines consecutivos permitidos. 3. Para diccionarios masivos se emplean autómatas finitos deterministas acíclicos (DAWG - Directed Acyclic Word Graph).
Pregunta 5: ¿Por qué implementar el Trie sobre una Arena de Nodos (Vec<TrieNode>) en Rust es más eficiente que usar Box<TrieNode>?
Respuesta:
- Eliminación de Sobrecarga de Asignador y Faltas de Caché:
- Con
Box<TrieNode>, cada nodo requiere una asignación independiente en el Heap mediante el asignador del sistema (malloc), reservando encabezados de bloque de memoria adicionales y dispersando los nodos por toda la memoria RAM. - Con un
Vec<TrieNode>, todos los nodos se almacenan en un único búfer de memoria contiguo. Las transiciones de puntero son simples índices enterosusize, lo que maximiza la tasa de aciertos de la memoria caché L1/L2 del procesador y reduce a cero las fugas de memoria.