17. Entrega, operación y observabilidad#
Una aplicación en producción no es simplemente el binario Rust ejecutándose en memoria. Una solicitud real atraviesa redes públicas, terminación TLS en proxies inversos, balanceadores de carga, controladores de aplicación, conexiones TCP agrupadas en pools hacia bases de datos y sistemas de almacenamiento en disco. Una degradación o anomalía puede manifestarse en cualquiera de estas fronteras. La observabilidad rigurosa conserva suficiente contexto causal para discriminar hipótesis sin filtrar información confidencial ni convertir la simple respuesta "200 OK" en una promesa ingenua de disponibilidad del sistema.
Objetivo#
Al finalizar esta lección podrás:
- Mapear el ciclo de vida operativo de una solicitud a través de proxies, procesos de aplicación y motores de almacenamiento mediante telemetría correlacionada (
Request-ID,traceparent). - Distinguir y desacoplar formalmente las etapas de compilación (build), verificación automatizada (test), despliegue (deploy) y operación en vivo (runtime).
- Diseñar sondas de salud diferenciadas: sondas de vida (liveness probes) puramente locales frente a sondas de disponibilidad (readiness probes) conscientes de dependencias, neutralizando tormentas de reinicios en cascada (cascading restart storms).
- Demostrar matemáticamente por qué la media aritmética oculta las anomalías de cola pesada (fat tails) y calcular percentiles de latencia (
p50,p95,p99,p100) mediante el método Nearest-Rank. - Planificar migraciones de esquema de base de datos sin tiempo de inactividad (zero-downtime) mediante el patrón en 5 fases Expand-and-Contract.
- Definir objetivos de recuperación cuantificables (RTO y RPO) y establecer la disciplina operativa de respaldos basados en simulacros de restauración ensayados.
Antes de empezar#
Debes dominar los conceptos de contratos HTTP, transacciones SQL y mitigación de fallos de concurrencia estudiados en las lecciones 05 a 08 y 16.
Las prácticas de esta lección son revisiones analíticas locales y código verificable en Rust estándar (std-only). No se requiere conexión a servicios en la nube ni infraestructura propietaria. Los comandos y herramientas de telemetría se abordan desde sus estándares abiertos fundamentales (como OpenTelemetry y W3C Trace Context).
Si encuentras términos desconocidos durante el estudio de esta lección, consulta el glosario técnico.
Diccionario de conceptos de la lección (Glosario desde cero)#
Para construir una mentalidad operativa profesional, analizamos cada concepto fundamental bajo cuatro dimensiones: intuición cotidiana, definición técnica formal, ejemplo concreto y concepción errónea frecuente.
1. Observabilidad vs Monitoreo#
- Intuición cotidiana: Monitorear es como tener una luz roja en el tablero del automóvil que se enciende cuando el motor se sobrecalienta: te avisa que algo ya falló. Observabilidad es tener un sistema de diagnóstico que te permite interrogar a la computadora del vehículo para entender por qué subió la temperatura (¿falló el termostato, se rompió la banda de la bomba o se evaporó el refrigerante?), incluso ante una falla inédita que jamás habías visto antes.
- Definición técnica precisa:
- Monitoreo: Práctica de medir métricas predefinidas frente a umbrales estáticos conocidos para responder: "¿Está el sistema funcionando según las expectativas previstas?" (modo reactivo ante estados de fallo conocidos).
- Observabilidad: Propiedad de un sistema que permite inferir sus estados internos desconocidos basándose exclusivamente en sus salidas externas (telemetría estructurada con alto nivel de cardinalidad y contexto causal), respondiendo a la pregunta: "¿Por qué está fallando el sistema en este momento bajo esta combinación única de variables?".
- Ejemplo en telemetría:
  // Registro observable con alto contexto y cardinalidad:
  {
    "timestamp": "2026-10-18T14:30:00.120Z",
    "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
    "span_id": "00f067aa0ba902b7",
    "http_method": "POST",
    "http_route": "/api/notes",
    "http_status": 500,
    "duration_ms": 654,
    "db_pool_wait_ms": 650,
    "db_query_ms": 4,
    "error_cause": "PoolTimeout: all 20 connections occupied by long-running reports"
}- Concepción errónea: Creer que observabilidad consiste simplemente en acumular terabytes de texto plano desestructurado en un servidor de logs. Si los logs no están correlacionados por identificadores de traza ni contienen contexto estructural, buscar una falla entre millones de líneas sigue siendo una tarea a ciegas.
2. Tres pilares de la telemetría (Logs estructurados, Métricas, Trazas distribuidas)#
- Intuición cotidiana:
- Métricas: El velocímetro del automóvil (un número que cambia continuamente: 100 km/h).
- Logs: La bitácora de viaje de un explorador (anotaciones textuales de hitos específicos: "14:00 pinchazo de neumático delantero").
- Trazas: El recorrido GPS milimétrico del vehículo que conecta cada curva, frenada y parada en gasolineras a lo largo de un viaje internacional de 500 kilómetros.
- Definición técnica precisa:
- Métricas: Valores numéricos agregados a lo largo de ventanas de tiempo (contadores, medidores de nivel gauges, histogramas). Son extremadamente económicas de almacenar y procesar; ideales para tableros y alertas en tiempo real.
- Logs estructurados: Registros individuales e inmutables de eventos discretos ocurridos en el sistema, emitidos en formatos parseables (clave-valor o JSON), que documentan causas detalladas y errores.
- Trazas distribuidas / Spans: Registro del viaje completo de una solicitud individual a través de las fronteras de múltiples procesos o servicios. Un Span representa una unidad de trabajo contigua (ej. ejecutar una consulta SQL o serializar un JSON); una Traza es el árbol acíclico dirigido (DAG) compuesto por la jerarquía de todos los spans de esa solicitud.
- Concepción errónea: Pensar que las trazas reemplazan a los logs. Las métricas alertan sobre el síntoma ("latencia en p99 subió"); las trazas localizan el componente culpable ("el span de PostgreSQL tardó 800 ms"); el log estructurado de ese span explica la causa raíz ("bloqueo de fila esperando a la transacción #941").
3. Correlation ID / Request ID / traceparent (W3C Trace Context)#
- Intuición cotidiana: El código de rastreo de un paquete de encomienda internacional: el mismo número figura en el resguardo postal del remitente, en la aduana aérea, en la camioneta de reparto local y en la firma de entrega final.
- Definición técnica precisa: Identificador único global inyectado por el primer componente de infraestructura que recibe la petición (típicamente el proxy inverso de borde o la aplicación cliente). Se propaga mediante cabeceras HTTP estándar (como
X-Request-IDo la especificación formal W3Ctraceparent:00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01) hacia todos los servicios internos, bases de datos y emisores de telemetría. - Ejemplo en HTTP:
  POST /api/notes HTTP/1.1
  Host: api.example.com
  traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
X-Request-ID: 7e2d9b1a-8c43-4f9e-b7d1-561234a9ef01- Concepción errónea: Generar un identificador nuevo y desvinculado en cada capa del sistema. Si el proxy usa el ID
123, el backend usa el IDabcy la base de datos no tiene contexto, correlacionar la caída de una solicitud específica requiere comparar marcas de tiempo ambiguas.
4. Sonda de vida (Liveness) vs Sonda de disponibilidad (Readiness)#
- Intuición cotidiana:
- Liveness: Comprobar si el cajero del banco tiene pulso y está respirando. Si sufrió un desmayo, llamas a los paramédicos para revivirlo (reiniciar el contenedor).
- Readiness: Comprobar si el cajero del banco tiene billetes en su gaveta y el sistema de su terminal está conectado a la red central. Si la red se cayó, el cajero está vivo pero no puede atender clientes; colocas el letrero de "Caja cerrada temporalmente" y desvías a la gente a otra ventanilla (remover del balanceador de carga), pero no llamas a los paramédicos para darle reanimación cardiopulmonar.
- Definición técnica precisa:
- Liveness Probe (Sonda de vida): Comprobación ejecutada por el orquestador (Kubernetes/Docker) para determinar si el proceso sigue funcionando internamente o si ha entrado en un estado irrecuperable (bloqueo mutuo / deadlock, bucle infinito, corrupción de memoria). Si falla, el orquestador envía
SIGKILLy reinicia el contenedor. - Readiness Probe (Sonda de disponibilidad): Comprobación para determinar si el contenedor está en condiciones de aceptar tráfico de usuarios de inmediato. Si falla, el orquestador no mata el proceso; simplemente retira su dirección IP del balanceador de carga para que no reciba peticiones hasta que se recupere.
- Concepción errónea: Configurar la sonda de vida para que ejecute una consulta SQL compleja a la base de datos central. Si la base de datos se satura o se ralentiza, todas las sondas de vida fallarán simultáneamente, provocando el reinicio masivo y descontrolado de toda la flota de contenedores sanos.
5. Distribución de latencia: Media aritmética vs Percentiles (p50, p95, p99, p100) y método Nearest-Rank#
- Intuición cotidiana: Si en un bar hay 99 personas que ganan un salario de $1,000 mensuales y entra Bill Gates con un ingreso de $1,000,000 mensuales, el salario promedio del bar se eleva a más de $10,990. Decir que "el cliente promedio del bar gana $10,000" es un engaño estadístico que oculta la realidad de 99 de las 100 personas.
- Definición técnica precisa:
- Media aritmética: Suma de todas las duraciones observadas dividida entre el número total de muestras. En distribuciones con colas asimétricas (skewed distributions), la media se distorsiona severamente ante unos pocos valores atípicos (outliers).
- Percentil p: Valor bajo el cual se encuentra un porcentaje p de las observaciones ordenadas de menor a mayor. Por ejemplo, el percentil 95 (
p95) representa la latencia que supera al 95% de las solicitudes más rápidas y describe el umbral del 5% de las solicitudes más lentas. - Método Nearest-Rank: Método ordinal estándar para calcular percentiles en conjuntos finitos: dada una lista ordenada de n elementos, el percentil p (expresado como fracción en (0, 1]) corresponde al valor en la posición entera k = ⌈ p × n ⌉ (donde ⌈ · ⌉ es la función techo que redondea hacia arriba).
- Concepción errónea: Promediar percentiles (por ejemplo, promediar el p95 de diez servidores para obtener el p95 global del clúster). Los percentiles no son magnitudes lineales aditivas; promediar percentiles es matemáticamente inválido y distorsiona por completo la visibilidad de la cola de latencia.
6. Migración Expand-and-Contract (5 fases sin tiempo de inactividad)#
- Intuición cotidiana: Ampliar una carretera de dos carriles a cuatro carriles: primero construyes los nuevos carriles contiguos mientras los autos siguen transitando por los viejos (Expand); luego desvías el tráfico para probar la nueva superficie; finalmente demueles o repavimentas los carriles antiguos (Contract). En ningún momento se interrumpe el tránsito vehicular.
- Definición técnica precisa: Patrón arquitectónico de evolución de esquemas de base de datos que permite actualizar tablas sin tiempo de inactividad (zero-downtime) ni dependencias rígidas de despliegue entre binarios y bases de datos. Se compone de 5 fases secuenciales:
- Fase 1 (Expand): Añadir la nueva columna o tabla en modo opcional (
NULL) o con valor por defecto no destructivo. - Fase 2 (Dual Write): Desplegar la aplicación que escribe tanto en la columna antigua como en la nueva, pero continúa leyendo de la antigua.
- Fase 3 (Backfill): Ejecutar un proceso en segundo plano que migra y rellena los datos históricos en lotes controlados.
- Fase 4 (Switch Reads): Desplegar la versión de la aplicación que lee de la nueva columna y continúa manteniendo consistencia.
- Fase 5 (Contract): Eliminar el soporte de la columna antigua en el código, aplicar restricciones estrictas (
NOT NULL) y finalmente eliminar la columna antigua en la base de datos.
- Concepción errónea: Aplicar cambios de esquema mediante comandos destructivos síncronos como
ALTER TABLE notes RENAME COLUMN title TO note_titleen un solo paso durante el despliegue. Durante los segundos o minutos en que conviven contenedores con el binario antiguo y el nuevo, todas las consultas del binario antiguo fallarán catastróficamente con errores de SQL.
7. Rollback de binario vs Reversión/Restauración de datos (RTO y RPO)#
- Intuición cotidiana: Si pintas una pared blanca de color negro y luego decides volver al estado anterior, "revertir el software" es como guardar la brocha en la caja de herramientas. Guardar la brocha no hace que la pared vuelva a ser blanca: la pintura negra ya alteró físicamente la pared y requieres una labor de restauración específica para devolverla a su estado original.
- Definición técnica precisa:
- Rollback de binario: Despliegue de una versión previa del software ejecutable (ej. revertir el contenedor de la versión
v2.1av2.0). Es una operación rápida que solo reemplaza el código en memoria. - Reversión / Restauración de datos: Procedimiento de recuperación de estado que implica revertir transacciones de base de datos o restaurar un respaldo (backup) físico/lógico. Si una migración destructiva ya ejecutó un
DROP COLUMN, hacer un rollback de binario no restaura los datos perdidos; de hecho, el binario antiguo fallará de inmediato porque la columna que requiere ya no existe. - *RPO (Recovery Point Objective):* Tolerancia máxima aceptable de pérdida de datos medida en tiempo (ej. "RPO de 1 hora" significa que ante un desastre, la empresa acepta perder como máximo los datos generados en la última hora).
- *RTO (Recovery Time Objective):* Tiempo máximo admisible de interrupción del servicio desde que ocurre el desastre hasta que el sistema vuelve a operar plenamente.
- Concepción errónea: Pensar que tener copias de seguridad automáticas programadas en un servicio de almacenamiento en la nube garantiza el cumplimiento del RTO y RPO. Un respaldo cuya restauración jamás ha sido ensayada empíricamente en un entorno limpio no es un respaldo: es una hipótesis no demostrada.
8. Amplificación de fallo en cascada (Thundering herd en health checks)#
- Intuición cotidiana: Una multitud asustada en una sala de cine que corre en masa hacia una única puerta estrecha tras oír una falsa alarma: la estampida humana bloquea la puerta y aplasta a los que intentan salir, provocando una catástrofe provocada no por el peligro inicial, sino por la reacción descontrolada de la masa.
- Definición técnica precisa: Fenómeno patológico en sistemas distribuidos donde una perturbación transitoria (como un pico de carga en la base de datos o una ralentización de red) provoca que múltiples agentes clientes o mecanismos de supervisión reaccionen simultáneamente (reintentos agresivos sin retroceso exponencial, sondas de vida que matan procesos, arranques en frío sincronizados), sobrecargando aún más el componente degradado y propagando el fallo a través de todo el ecosistema.
- Concepción errónea: Resolver problemas de tiempos de espera reduciendo agresivamente el timeout de las sondas de vida a 200 ms. Cuanto más corto es el timeout en un sistema bajo congestión, más rápido colapsa la infraestructura por falsos positivos de muerte de procesos.
Modelo mental y análisis en profundidad#
flowchart LR
  U[Browser request] --> P[Proxy and TLS]
  P --> A[Application process]
  A --> D[(Database)]
  P -. request id .-> L[Correlated telemetry]
  A -. safe events and spans .-> L
  D -. latency and failures .-> L
  R[Readiness decision] --> P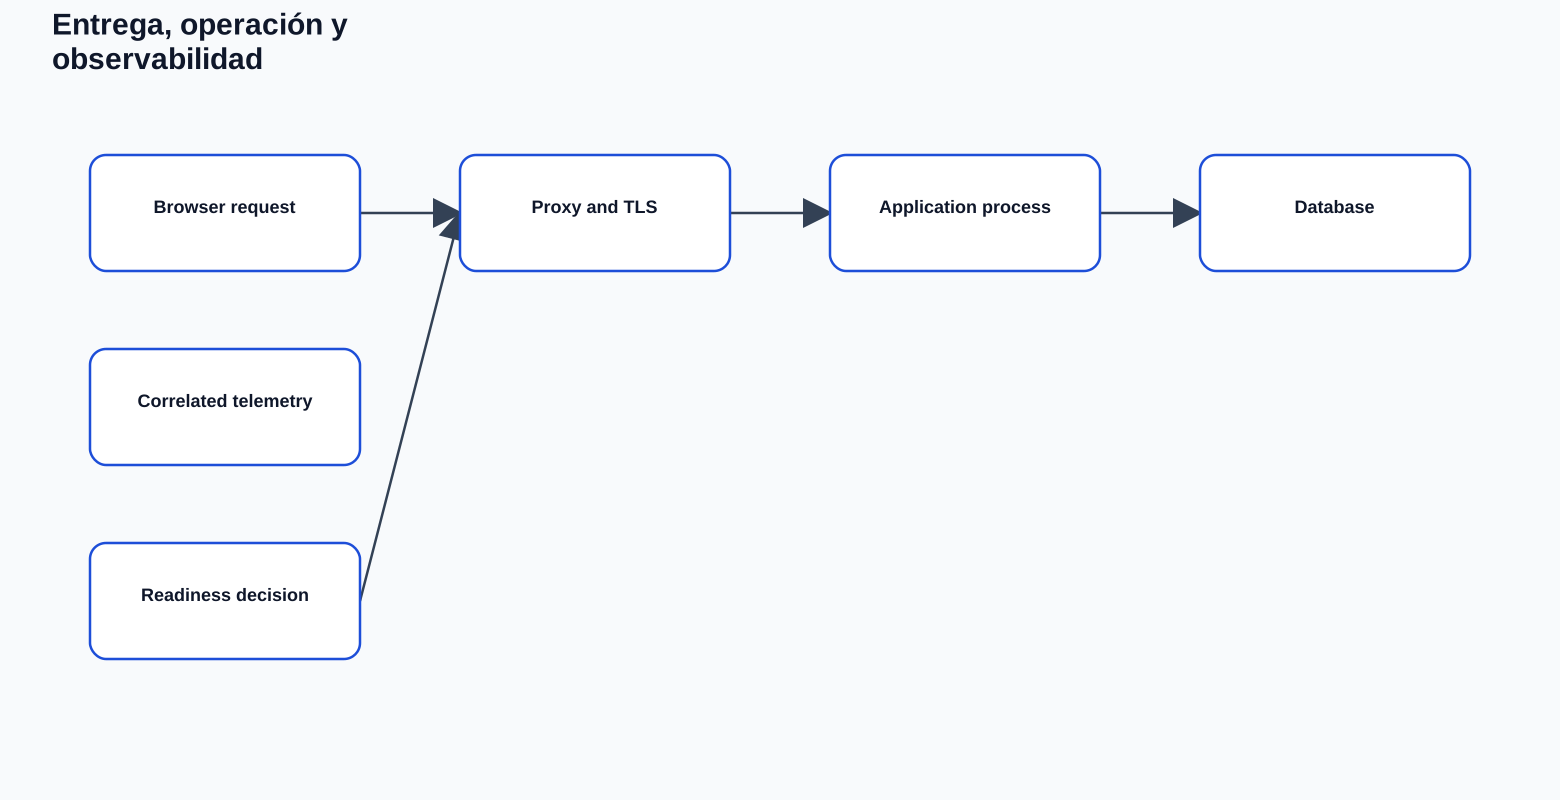
Desglose paso a paso 1: La tiranía del promedio y la matemática de colas pesadas#
Consideremos un conjunto de 100 solicitudes HTTP capturadas en una ventana de observación de producción.
Distribución Base de la Lección#
- 95 solicitudes tardan 20 ms.
- 4 solicitudes tardan 40 ms.
- 1 solicitud tarda 3000 ms (3 segundos completos, debido a contención en el pool de conexiones).
Cálculo de la Media Aritmética:#
Si un informe ejecutivo afirma: "Nuestra latencia promedio es de 50.6 ms", la métrica luce saludable. Sin embargo, para el usuario que sufrió la petición de 3000 ms, la aplicación pareció congelada.
Cálculo de Percentiles mediante el Método Nearest-Rank:#
Dado un total de n = 100 observaciones ordenadas de menor a mayor:
| Percentil | Expresión Matemática | Posición en Lista Ordenada | Valor de Latencia | Significado Operativo |
|---|---|---|---|---|
p50 (Mediana) | ⌈ 0.50 × 100 ⌉ = 50 | Posición 50 (dentro del bloque de 95) | 20 ms | El 50% de los usuarios experimenta una respuesta ultrarrápida de 20 ms. |
p95 | ⌈ 0.95 × 100 ⌉ = 95 | Posición 95 (última muestra del bloque de 20 ms) | 20 ms | El 95% de las solicitudes se atendió en 20 ms o menos. |
p96 | ⌈ 0.96 × 100 ⌉ = 96 | Posición 96 (primera muestra del bloque de 40 ms) | 40 ms | Comienza la degradación leve. |
p99 | ⌈ 0.99 × 100 ⌉ = 99 | Posición 99 (última muestra del bloque de 40 ms) | 40 ms | El 99% de las peticiones tomó 40 ms o menos. |
p100 (Máximo) | ⌈ 1.00 × 100 ⌉ = 100 | Posición 100 (la observación anómala) | 3000 ms | La cola extrema (outlier) sufre un retardo de 3 segundos. |
El Desplazamiento de Frontera (Boundary Shift):#
¿Qué ocurre si la distribución se desplaza ligeramente de modo que 94 solicitudes tardan 20 ms, 5 solicitudes tardan 40 ms y 1 solicitud tarda 3000 ms?
- Tiempo total: (94 × 20) + (5 × 40) + (1 × 3000) = 1880 + 200 + 3000 = 5080 ms.
- Nueva media aritmética: (5080) / (100) = 50.8 ms (un incremento insignificante de solo 0.2 ms).
- Nuevo cálculo de
p95:
k = ⌈ 0.95 × 100 ⌉ = 95. Como el bloque de 20 ms ahora solo ocupa las posiciones 1 a 94, la posición 95 contiene ahora 40 ms. ¡El percentil p95 reportado en el tablero se duplica instantáneamente de 20 ms a 40 ms!
Comparación con Distribución Alternativa de Idéntica Media:#
Consideremos ahora otra distribución de 100 peticiones:
- 95 solicitudes de 40 ms (3800 ms)
- 4 solicitudes de 90 ms (360 ms)
- 1 solicitud de 900 ms (900 ms)
- Tiempo total: 3800 + 360 + 900 = 5060 ms arrow Media exacta de 50.6 ms.
| Métrica | Distribución A (Cola hiperlenta) | Distribución B (Comportamiento distribuido) |
|---|---|---|
| Media | 50.6 ms | 50.6 ms |
p50 | 20 ms | 40 ms |
p95 | 20 ms | 40 ms |
p99 | 40 ms | 90 ms |
p100 / Máximo | 3000 ms | 900 ms |
Guiar decisiones de ingeniería o compromisos de nivel de servicio (SLA/SLO) basándose en la media aritmética es una negligencia operativa: oculta por completo las peticiones catastróficas que degradan la experiencia de los usuarios reales.
Desglose paso a paso 2: La tormenta de reinicios por sonda de vida defectuosa#
Analicemos la anatomía de un incidente real provocado por una mala configuración de sondas de salud:
[Cliente HTTP] ---> [Balanceador / Proxy] ---> [10 Contenedores Rust] ---> [PostgreSQL]- La configuración errónea:
El orquestador tiene configurada la siguiente sonda de vida (Liveness Probe):
- Endpoint:
GET /healthz/liveness- Implementación: El endpoint ejecutaSELECT COUNT(*) FROM users;contra la base de datos central. - Intervalo: Cada 2 segundos;timeoutSeconds: 1;failureThreshold: 2. - El incidente detonante: A las 14:00, un proceso por lotes de contabilidad ejecuta una consulta analítica pesada que adquiere bloqueos y satura la CPU de PostgreSQL durante 3 segundos.
- El colapso en cascada:
- La sonda de vida en los 10 contenedores Rust intenta ejecutar
SELECT COUNT(*). La consulta queda encolada en el pool de conexiones de la base de datos. - A los 1000 ms, las sondas de vida agotan su tiempo de espera (timeout). - Al segundo fallo consecutivo (a los 4 segundos), el orquestador concluye erróneamente: "Los 10 procesos Rust están muertos". - El orquestador envíaSIGKILLy reinicia los 10 contenedores simultáneamente. - *La tormenta de arranque en frío (Thundering Herd): - Los 10 contenedores nuevos arrancan al mismo tiempo. Cada uno inicializa su runtime de Tokio y abre un pool de 20 conexiones TCP contra PostgreSQL (10 × 20 = 200 handshakes TCP y TLS simultáneos). - La base de datos, que apenas se estaba recuperando del bloqueo analítico, es bombardeada por 200 conexiones concurrentes, colapsando su memoria y sockets. - Las nuevas sondas de vida de los contenedores recién nacidos vuelven a fallar por timeout. - El clúster entra en un ciclo infinito de reinicios destructivos (CrashLoopBackOff*).
La solución arquitectónica: Separación tajante de Liveness y Readiness#
| Sonda | Responsabilidad Estricta | Qué debe verificar | Acción del Orquestador al fallar |
|---|---|---|---|
| Liveness (Vida) | "¿Está el proceso vivo y su bucle de eventos respondiendo?" | Comprobación puramente local y en memoria: atomic flag en memoria, ausencia de deadlocks internos. CERO consultas de red o base de datos externa. | Reiniciar el proceso (SIGKILL + nuevo contenedor). |
| Readiness (Disponibilidad) | "¿Está el contenedor listo para atender tráfico de clientes ahora mismo?" | Conectividad con dependencias críticas (PostgreSQL con query ligera SELECT 1, Redis, migraciones aplicadas). | Retirar la IP del balanceador de carga. El proceso sigue vivo, permitiendo que la base de datos respire sin generar tormentas de conexiones de arranque en frío. |
Desglose paso a paso 3: Evolución de esquemas en 5 fases (Expand-and-Contract)#
Cuando un servicio atiende miles de peticiones por segundo en múltiples instancias, desplegar una nueva versión que renombra o altera una columna de base de datos de forma destructiva genera indisponibilidad inevitable.
Supongamos que deseamos evolucionar la columna owner_id: u64 en la tabla notes hacia una nueva estructura author_identifier: VARCHAR(64):
flowchart TD
  F1[Fase 1: Expand<br/>ADD COLUMN author_identifier NULL] --> F2[Fase 2: Dual Write<br/>App v2 escribe ambas columnas, lee antigua]
  F2 --> F3[Fase 3: Backfill<br/>Migración por lotes en segundo plano]
  F3 --> F4[Fase 4: Switch Reads<br/>App v3 lee nueva columna, escribe ambas]
F4 --> F5[Fase 5: Contract<br/>App v4 elimina código antiguo<br/>ALTER TABLE DROP COLUMN owner_id]- Fase 1 — Expand (Expansión de esquema):
Se ejecuta una migración no destructiva en PostgreSQL:
``
sql ALTER TABLE notes ADD COLUMN author_identifier VARCHAR(64) NULL;`*Impacto:* Instantáneo. Las versiones anteriores de la aplicación (v1`) ignoran la nueva columna y continúan funcionando sin errores. - Fase 2 — Dual Write (Doble escritura en aplicación):
Se despliega la versión de la aplicación
v2. Al crear o modificar una nota, escribe tanto enowner_idcomo enauthor_identifier: ``sql INSERT INTO notes (id, title, owner_id, author_identifier) VALUES ($1, $2, $3, $4);`Sin embargo, las lecturas siguen consultandoowner_id. Siv2falla, hacer un rollback av1es completamente seguro porqueowner_id` se mantuvo actualizado. - Fase 3 — Backfill (Relleno histórico en segundo plano):
Un script o tarea programada procesa las filas antiguas donde
author_identifier IS NULLen lotes pequeños (ej. 500 filas por transacción) para no degradar el motor: ``sql UPDATE notes SET author_identifier = 'user_' || owner_id WHERE id IN ( SELECT id FROM notes WHERE author_identifier IS NULL LIMIT 500 );`` - Fase 4 — Switch Reads (Conmutación de lecturas):
Se despliega la versión
v3. La aplicación ahora lee exclusivamente deauthor_identifiery sigue manteniendo la doble escritura de respaldo. Se verifica en métricas y logs que ninguna consulta dependa de la representación previa. - Fase 5 — Contract (Contracción y limpieza):
Se despliega la versión
v4que elimina todo rastro deowner_iddel código. Finalmente, se aplica la restricción de integridad y se retira la columna antigua en la base de datos: ``sql ALTER TABLE notes ALTER COLUMN author_identifier SET NOT NULL; ALTER TABLE notes DROP COLUMN owner_id;``
Ejemplo razonado de telemetría segura y cálculo de latencia#
El siguiente programa en Rust estándar demuestra:
- El cálculo formal de la media aritmética y percentiles mediante el método Nearest-Rank.
- La sanitización de registros estructurados para garantizar que identificadores de autorización y credenciales sensibles jamás se filtren en la telemetría operativa.
// Compilable and verified with rustc --test
use std::collections::HashMap;

#[derive(Debug, Clone)]
pub struct LatencyDistribution {
    sorted_ms: Vec<u64>,
}

impl LatencyDistribution {
    pub fn new(mut samples: Vec<u64>) -> Result<Self, &'static str> {
        if samples.is_empty() {
            return Err("Samples cannot be empty");
        }
        samples.sort_unstable();
        Ok(Self { sorted_ms: samples })
    }

    pub fn total(&self) -> u64 {
        self.sorted_ms.iter().sum()
    }

    pub fn mean(&self) -> f64 {
        self.total() as f64 / self.sorted_ms.len() as f64
    }

    /// Computes the p-th percentile using the nearest-rank method:
    /// rank = ceil(p * n), where p in (0.0, 1.0].
    pub fn nearest_rank_percentile(&self, p: f64) -> u64 {
        assert!(p > 0.0 && p <= 1.0, "Percentile p must be in (0.0, 1.0]");
        let n = self.sorted_ms.len() as f64;
        let rank = (p * n).ceil() as usize;
        let clamped_rank = rank.clamp(1, self.sorted_ms.len());
        self.sorted_ms[clamped_rank - 1]
    }
}

#[derive(Debug, Clone, PartialEq, Eq)]
pub struct SafeLogEvent {
    pub request_id: String,
    pub method: String,
    pub path: String,
    pub status: u16,
    pub duration_ms: u64,
    pub sanitized_headers: HashMap<String, String>,
}

impl SafeLogEvent {
    pub fn sanitize_and_build(
        request_id: &str,
        method: &str,
        path: &str,
        status: u16,
        duration_ms: u64,
        raw_headers: &[(&str, &str)],
    ) -> Self {
        let mut sanitized_headers = HashMap::new();
        for (key, val) in raw_headers {
            let lower = key.to_ascii_lowercase();
            // Strict sanitization: strip session tokens, cookies, auth keys
            if lower == "authorization" || lower == "cookie" || lower == "set-cookie" || lower == "x-api-key" {
                sanitized_headers.insert(key.to_string(), "[REDACTED]".to_string());
            } else {
                sanitized_headers.insert(key.to_string(), val.to_string());
            }
        }

        Self {
            request_id: request_id.to_string(),
            method: method.to_string(),
            path: path.to_string(),
            status,
            duration_ms,
            sanitized_headers,
        }
    }

    pub fn to_structured_line(&self) -> String {
        format!(
            "level=INFO request_id=\"{}\" method={} path=\"{}\" status={} duration_ms={}",
            self.request_id, self.method, self.path, self.status, self.duration_ms
        )
    }
}
Práctica independiente#
Escenario de laboratorio#
Se reporta intermitencia en el guardado de notas: "La aplicación a veces se siente instantánea y a veces tarda varios segundos". Dispones de una serie de 100 mediciones ordenadas capturadas durante la hora pico:
- Caso Base: 95 solicitudes de 20 ms, 4 de 40 ms y 1 de 3000 ms.
- Se te solicita modelar la telemetría, comprobar la media, el percentil 95, 99 y el máximo, y verificar que los encabezados de autenticación se ofusquen adecuadamente.
Disciplina TDD: RED arrow GREEN arrow REFACTOR#
- Fase RED: Escribe pruebas unitarias que afirmen que
dist.total() == 5060,dist.mean() == 50.6,p95 == 20,p99 == 40yp100 == 3000. Añade una prueba para verificar queSafeLogEventsustituya el encabezadoAuthorization: Bearer secretpor[REDACTED]. - Fase GREEN: Implementa los algoritmos de ordenamiento y filtrado de cabeceras. Ejecuta
rustc --testhasta obtener luz verde. - Fase REFACTOR: Analiza el caso de frontera (boundary shift): escribe una prueba con 94 observaciones de 20 ms y 5 de 40 ms para observar la mutación del percentil 95 de 20 ms a 40 ms.
Arnés de pruebas automatizado verificable (rustc --test)#
#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn verify_lesson17_latency_arithmetic_exact() {
        // 95 requests of 20 ms, 4 of 40 ms, 1 of 3000 ms
        let mut samples = Vec::with_capacity(100);
        samples.extend(std::iter::repeat(20).take(95));
        samples.extend(std::iter::repeat(40).take(4));
        samples.extend(std::iter::repeat(3000).take(1));

        let dist = LatencyDistribution::new(samples).unwrap();

        // Exact math checks
        assert_eq!(dist.total(), 5060);
        assert!((dist.mean() - 50.6).abs() < 1e-9);

        // Nearest-rank percentile assertions:
        // p50: ceil(0.50 * 100) = 50 -> pos 50 = 20 ms
        assert_eq!(dist.nearest_rank_percentile(0.50), 20);
        // p95: ceil(0.95 * 100) = 95 -> pos 95 = 20 ms
        assert_eq!(dist.nearest_rank_percentile(0.95), 20);
        // p96: ceil(0.96 * 100) = 96 -> pos 96 = 40 ms
        assert_eq!(dist.nearest_rank_percentile(0.96), 40);
        // p99: ceil(0.99 * 100) = 99 -> pos 99 = 40 ms
        assert_eq!(dist.nearest_rank_percentile(0.99), 40);
        // p100 / max: ceil(1.00 * 100) = 100 -> pos 100 = 3000 ms
        assert_eq!(dist.nearest_rank_percentile(1.00), 3000);
    }

    #[test]
    fn verify_boundary_shift_on_95th_request() {
        // What happens if 94 are 20 ms, 5 are 40 ms, 1 is 3000 ms?
        let mut samples = Vec::with_capacity(100);
        samples.extend(std::iter::repeat(20).take(94));
        samples.extend(std::iter::repeat(40).take(5));
        samples.extend(std::iter::repeat(3000).take(1));

        let dist = LatencyDistribution::new(samples).unwrap();

        assert_eq!(dist.total(), 5080);
        assert!((dist.mean() - 50.8).abs() < 1e-9);

        // The 95th observation is now 40 ms!
        assert_eq!(dist.nearest_rank_percentile(0.95), 40);
        assert_eq!(dist.nearest_rank_percentile(0.99), 40);
        assert_eq!(dist.nearest_rank_percentile(1.00), 3000);
    }

    #[test]
    fn verify_sanitization_of_sensitive_headers() {
        let headers = [
            ("Authorization", "Bearer eyJhbGciOi...secret"),
            ("Cookie", "sid=secret_session_token"),
            ("Accept", "application/json"),
        ];

        let event = SafeLogEvent::sanitize_and_build(
            "req-abc-123",
            "GET",
            "/api/notes",
            200,
            20,
            &headers,
        );

        assert_eq!(event.sanitized_headers.get("Authorization").unwrap(), "[REDACTED]");
        assert_eq!(event.sanitized_headers.get("Cookie").unwrap(), "[REDACTED]");
        assert_eq!(event.sanitized_headers.get("Accept").unwrap(), "application/json");

        let line = event.to_structured_line();
        assert!(line.contains("request_id=\"req-abc-123\""));
        assert!(!line.contains("secret"));
    }
}
Code smell: Sonda de vida profunda con acoplamiento de dependencias#
El síntoma en el código#
// DELIBERATELY HARMFUL HEALTH CHECK CODE SMELL
pub async fn liveness_probe(
    db: web::Data<PgPool>,
    cache: web::Data<RedisClient>,
) -> HttpResponse {
    // ANTI-PATTERN: Checking all remote downstream dependencies in a liveness check!
    let db_ok = sqlx::query("SELECT 1").execute(db.as_ref()).await.is_ok();
    let cache_ok = cache.ping().await.is_ok();

    if db_ok && cache_ok {
        HttpResponse::Ok().json(serde_json::json!({"status": "healthy"}))
    } else {
        // FATAL: Instructing Kubernetes to kill and restart this container!
        HttpResponse::ServiceUnavailable().json(serde_json::json!({"status": "unhealthy"}))
    }
}
Diagnóstico de ingeniería#
- Evidencia empírica: El orquestador reinicia decenas de contenedores en bucle (
CrashLoopBackOff) en el instante exacto en que la base de datos o el caché experimentan lentitud temporal. - Hipótesis del fallo: El autor confundió la supervivencia del proceso con la disponibilidad funcional del ecosistema.
- Consecuencia destructiva: Los reinicios masivos provocan desconexiones de clientes, pérdida de tareas en memoria y multiplican la contención sobre la base de datos por arranque en frío de pools de conexiones.
- Corrección arquitectónica mínima: Convertir
/healthz/livenessen una comprobación local y estricta en memoria. Trasladar la verificación de PostgreSQL y Redis exclusivamente a/healthz/readiness, de modo que el balanceador desvíe el tráfico sin matar procesos sanos.
Preguntas de comprensión profunda y diagnóstico socrático#
Pregunta 1: La tiranía del promedio y la matemática de colas pesadas#
- Escenario: En un informe de operaciones, dos servicios exhiben exactamente la misma latencia promedio: 50.6 ms sobre 100 peticiones.
- El Servicio A tuvo 95 peticiones de 20 ms, 4 de 40 ms y 1 de 3000 ms.
- El Servicio B tuvo 95 peticiones de 40 ms, 4 de 90 ms y 1 de 900 ms.
- Inciso A: Si una empresa firma un acuerdo de nivel de servicio (SLA) que garantiza: "El 99% de las peticiones responderá en menos de 50 ms", ¿cuál de los dos servicios cumple el SLA y cuál lo viola según el método Nearest-Rank?
- Inciso B: ¿Por qué en el Servicio A el percentil
p95es de 20 ms pero si una sola petición pasa de 20 ms a 40 ms (94 de 20 ms y 5 de 40 ms), elp95reportado se duplica a 40 ms? Explica la naturaleza discreta de esta métrica. - Guía de razonamiento: Contrasta la media aritmética ponderada con el ordenamiento posicional de percentiles. Identifica cómo los percentiles protegen al usuario frente a la ilusión del promedio.
Pregunta 2: El colapso en cascada de las sondas de vida (Liveness Storm)#
- Escenario: Un microservicio de pagos en Rust cuenta con 15 réplicas en producción. Cada réplica ejecuta cada segundo una consulta SQL compleja en su sonda de vida. Ocurre una saturación temporal de 5 segundos en PostgreSQL debido a una transacción de mantenimiento.
- Inciso A: Describe la secuencia cronológica de eventos que ocurre entre el orquestador de contenedores y PostgreSQL cuando todas las sondas de vida agotan su tiempo de espera simultáneamente.
- Inciso B: ¿Qué diferencia de comportamiento tiene el balanceador de carga cuando falla una sonda de disponibilidad (Readiness) frente a cuando falla una sonda de vida (Liveness)? ¿Por qué la sonda de disponibilidad evita la tormenta de reinicios?
- Guía de razonamiento: Modela el estado del proceso en el sistema operativo versus el estado de la conexión de red en el balanceador. Explica por qué matar un proceso jamás cura la sobrecarga de una base de datos remota.
Pregunta 3: El mito del "Rollback del binario" ante migraciones de datos destructivas#
- Escenario: Un desarrollador aplica una migración en producción que ejecuta
ALTER TABLE users DROP COLUMN billing_address;. Tras el despliegue del nuevo binariov2, un bug en el módulo de facturación obliga a realizar un rollback inmediato al binariov1. - Inciso A: ¿Por qué el despliegue del binario
v1empeora el incidente y causa fallos generalizados con errores500 Internal Server Erroren todas las consultas de usuarios? - Inciso B: Describe cómo las 5 fases de una migración Expand-and-Contract hubieran evitado este desastre permitiendo un rollback limpio a
v1en cualquier instante de las primeras 4 fases. - Guía de razonamiento: Recuerda que el código de la aplicación y el estado en el disco de la base de datos tienen ciclos de vida independientes. Revertir el ejecutable no reconstruye los datos ni las columnas destruidas en las páginas de almacenamiento.
Pregunta 4: Sanitización de telemetría y límites de privacidad#
- Escenario: Para facilitar la depuración de incidencias en producción, un equipo decide configurar un interceptor global que serializa en logs estructurados el mapa completo de encabezados HTTP recibidos en cada solicitud.
- Inciso A: ¿Qué riesgos de seguridad inmediata y de cumplimiento regulatorio (ej. GDPR, PCI-DSS) se generan si un atacante o un empleado tiene acceso a la herramienta de visualización de logs (ej. Kibana o Datadog)?
- Inciso B: Diseña la política de ofuscación (redaction): ¿qué encabezados deben ser obligatoriamente censurados y qué metadatos seguros sí deben conservarse para permitir la correlación técnica de peticiones?
- Guía de razonamiento: Evalúa la superficie de exposición de los sistemas de logging. Establece qué datos son estrictamente necesarios para diagnosticar la infraestructura sin vulnerar el secreto de las credenciales de los usuarios.
Pregunta 5: Definición formal de RTO / RPO y la falacia del respaldo no probado#
- Escenario: La dirección de una empresa declara: "Respaldamos la base de datos todas las noches a las 02:00 AM mediante pg_dump hacia un bucket S3 cifrado; por lo tanto, nuestro riesgo de pérdida de datos es cero".
- Inciso A: Si la base de datos sufre un fallo catastrófico de disco a la 01:50 AM del día siguiente, ¿cuál fue el RPO (Recovery Point Objective) real que experimentó la empresa en ese incidente?
- Inciso B: Un nuevo ingeniero de confiabilidad (SRE) solicita presupuesto para realizar un simulacro de restauración (Restore Drill) en un entorno aislado. El gerente responde que es innecesario porque el script de subida a S3 reporta
"Exit code 0". Explica por qué el SRE insiste en que un respaldo jamás probado no califica como respaldo operativo. - Guía de razonamiento: Analiza la diferencia entre la creación de un archivo y la capacidad empírica de reconstruir un estado consistente a partir de él en un plazo de tiempo compatible con el RTO del negocio.
Criterio de salida#
Puedes considerar superada esta lección cuando:
- Trazas el flujo completo de una solicitud a través de proxies, aplicación y base de datos correlacionando eventos con
Request-IDotraceparentsin registrar secretos. - Separas conceptual y prácticamente las sondas de vida (Liveness) y de disponibilidad (Readiness), explicando por qué una sonda de vida jamás debe realizar consultas a dependencias externas de red.
- Calculas matemáticamente percentiles de latencia utilizando el método Nearest-Rank y explicas por qué la media aritmética es engañosa frente a colas pesadas.
- Diseñas migraciones de base de datos seguras bajo el patrón Expand-and-Contract en 5 fases y explicas por qué un rollback de código no revierte una mutación de esquema destructiva.
- Todas las pruebas automatizadas de latencia y sanitización compilan y pasan en verde con
rustc --test.
Lecturas oficiales#
- OpenTelemetry Documentation: conceptos fundamentales de traces, metrics, logs y propagación de contexto W3C.
- W3C Trace Context Specification: estándar universal para la cabecera
traceparent. - The Twelve-Factor App: Config & Logs: principios de separación de configuración, artefactos y tratamiento de logs como flujos de eventos.
- PostgreSQL Documentation on Indexes and Zero-Downtime Operations: costos de mantenimiento y técnicas seguras de migración.
Siguiente paso#
Avanza a la última lección del módulo: 18. Diagnóstico integral: seguir evidencia por capas, donde integrarás todas las dimensiones del curso en una investigación forense full-stack. Si deseas consultar el desglose completo de cálculos y respuestas, revisa la guía de respuestas de operaciones.