Sesión 57: Grokking Algorithms Cap. 10 — K-Nearest Neighbors (KNN), Métricas de Distancia Vectorial y Clasificación/Regresión (LeetCode 973)#
Tiempo estimado: 70-80 minutos. Nivel: De Junior/Trainee a Staff Specialist. Herramientas obligatorias: Hoja cuadriculada, lápiz, regla y calculadora básica.
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Consulta rápida: Glosario Maestro | Guía de Diagramas
K-Nearest Neighbors (KNN — Algoritmo de los K Vecinos Más Cercanos)#
- (a) En palabras simples (intuición): Imagina que llegas a un barrio nuevo y quieres saber si es seguro o ruidoso. En lugar de interrogar a toda la ciudad, simplemente tocas el timbre de las 3 o 5 casas más cercanas a la tuya. Si 4 de los 5 vecinos te dicen que es un barrio tranquilo, concluyes por mayoría de votos que es tranquilo.
- (b) Definición técnica paso a paso: Algoritmo de aprendizaje supervisado no paramétrico y perezoso (lazy learner). No computa una función matemática previa durante el "entrenamiento" (el entrenamiento consiste en simplemente almacenar los datos en memoria en O(1)). Dada una consulta Q, calcula la distancia métrica entre Q y los N puntos de entrenamiento en el espacio vectorial D-dimensional, extrae los K puntos con menor distancia y determina:
- Clasificación: La clase con mayor frecuencia relativa o ponderada por distancia inversa.
- Regresión: El promedio aritmético ponderado de las variables dependientes continuas de esos K vecinos.
- (c) Cómo funciona en Rust (memoria y tipos): Los puntos de entrenamiento se almacenan contiguamente en un vector en el Heap (
Vec<KnnSample<T>>). Durante la fase de consulta, para no ordenar todo el vector en O(N log N), se emplea una cola de prioridadstd::collections::BinaryHeapde capacidad fija K, la cual actúa como Max-Heap almacenando tuplas o estructuras(distancia, label). - (d) Error típico de Junior: Creer que KNN "aprende coeficientes" como una regresión lineal o una red neuronal. Al no haber entrenamiento previo, si el dataset tiene 1,000,000 de registros, cada predicción requerirá calcular 1,000,000 de distancias si no se cuenta con árboles de partición espacial (como KD-Trees o Ball-Trees).
Espacio Vectorial y Dimensión (D)#
- (a) En palabras simples (intuición): Cada dato es una lista de características numéricas. Si describes a una persona por (edad, altura), estás en un espacio de 2 dimensiones (D=2, un plano). Si agregas (peso, salario, horas de sueño), ahora es un espacio de 5 dimensiones (D=5). Cada persona es una coordenada en ese espacio.
- (b) Definición técnica paso a paso: Estructura matemática formada por un conjunto de vectores donde se definen operaciones de suma y multiplicación por escalares. En analítica de datos, cada punto A = (x₁, x₂, …, x_D) ∈ ℝ^D representa una observación donde cada eje i corresponde a una característica medible (feature).
- (c) Cómo funciona en Rust (memoria y tipos): Se modela como un slice de números de punto flotante
&[f64]o un buffer contiguo en el HeapVec<f64>. En código de alto rendimiento se prefieren arreglos de tamaño fijo[f64; D]o buffers tipados con alineación SIMD para vectorizar el cálculo de diferencias en registros AVX de la CPU. - (d) Error típico de Junior: Comparar vectores que tienen distinto número de elementos o mezclar variables que no son numéricas sin haberlas codificado previamente (one-hot encoding o ordinal encoding).
Distancia Euclidiana (Norma L₂) y Monotonía Cuadrática#
- (a) En palabras simples (intuición): Es la distancia geométrica en línea recta entre dos puntos, exactamente la que medirías colocando una regla recta sobre una hoja de papel (el Teorema de Pitágoras de la secundaria generalizado a cualquier cantidad de dimensiones).
- (b) Definición técnica paso a paso: La métrica canónica definida en el espacio euclidiano:
- Invariante de Monotonía Cuadrática: Dado que la función f(z) = √(z) es estrictamente monótona creciente para todo z ≥ 0, se cumple que d_{L₂}(A, B) < d_{L₂}(A, C) ⟺ d_{L₂}²(A, B) < d_{L₂}²(A, C). En búsquedas del punto más cercano (como en LeetCode 973), calcular la raíz cuadrada es un desperdicio de ciclos de CPU; basta con comparar las sumas de cuadrados enteros x² + y².
- (c) Cómo funciona en Rust (memoria y tipos): La suma de cuadrados de enteros de 32 bits (x, y ∈ [-10⁴, 10⁴]) puede alcanzar 2 · 10⁸, lo cual cabe en un entero con signo de 32 bits (
i32), pero para prevenir overflow en dimensiones mayores o coordenadas grandes se promueven los cálculos intermedios ai64. - (d) Error típico de Junior: Invocar
.sqrt()innecesariamente en cada iteración de un bucle de alta frecuencia, perdiendo hasta un 60% de rendimiento por micro-operaciones de coma flotante por hardware.
Distancia Manhattan (Norma L₁ / Taxicab Distance)#
- (a) En palabras simples (intuición): Es la distancia que recorre un automóvil en una ciudad con avenidas perpendiculares (como el mapa cuadriculado de Manhattan). No puedes atravesar los rascacielos en diagonal; debes avanzar cuadra por cuadra hacia el este y luego hacia el norte.
- (b) Definición técnica paso a paso: Métrica que suma las diferencias absolutas directas entre cada coordenada:
- (c) Cómo funciona en Rust (memoria y tipos): Se implementa acumulando
.abs()sobre las diferencias entre iteradores con.zip(). No requiere multiplicaciones ni raíces cuadradas, lo que la hace extremadamente rápida a nivel de silicio. - (d) Error típico de Junior: Usarla creyendo que representa la distancia física más corta en el mundo real. Es una métrica de red ortogonal, útil en grillas y robótica en almacenes, pero inapropiada para trayectorias de vuelo balístico o satelital.
Similitud Coseno (Cosine Similarity) vs Distancia Coseno#
- (a) En palabras simples (intuición): Imagina que dos amigos leen un libro de ciencia ficción. El amigo A lee un resumen de 5 páginas. El amigo B lee la enciclopedia completa de 1,000 páginas sobre el mismo tema. La distancia euclidiana dirá que son personas completamente diferentes porque el amigo B leyó millones de palabras más. La similitud coseno mide el ángulo de sus intereses: al apuntar en la misma dirección temática, el coseno de su ángulo es casi $1.0$ (idénticos gustos).
- (b) Definición técnica paso a paso: Mide el coseno del ángulo formado por dos vectores en un espacio multidimensional:
Su valor está confinado en [-1.0, 1.0]. La distancia coseno correspondiente se define como 1 - Cosine Similarity.
- (c) Cómo funciona en Rust (memoria y tipos): Se computan tres acumuladores en un solo recorrido de slice: producto escalar
dot, suma de cuadrados de A y suma de cuadrados de B. Se debe manejar defensivamente el caso donde la norma de alguno sea $0.0$ retornando unResult::Errpara evitar divisiones entre cero (NaN). - (d) Error típico de Junior: Usar distancia euclidiana para comparar embeddings de texto o documentos sin normalizar la longitud del texto.
Normalización Min-Max (La Regla de Oro)#
- (a) En palabras simples (intuición): Si comparas personas evaluando su edad (entre 18 y 80 años) y su salario anual (entre $15,000 y $1,000,000 de dólares), una pequeña diferencia de $5,000 en salario elevará la distancia euclidiana al cuadrado en 25,000,000, dejando a la edad con una influencia de cero. Normalizar significa comprimir todas las reglas de medir para que todas vayan de 0 a 1.
- (b) Definición técnica paso a paso: Transformación lineal por dimensión:
Donde min(X) y max(X) son los valores mínimo y máximo de la columna en el conjunto de entrenamiento.
- (c) Cómo funciona en Rust (memoria y tipos): Requiere un primer pase para calcular los vectores
min_vals: Vec<f64>ymax_vals: Vec<f64>sobre las columnas, seguido de una transformación que mapea cada fila. Si max - min == 0, se asigna $0.0$ para evitar división entre cero. - (d) Error típico de Junior: Calcular el mínimo y el máximo de todo el dataset como un escalar global en lugar de computarlo columna por columna de manera independiente.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Geometría de las Distancias Vectoriales#
Visualicemos en un plano bidimensional cómo se comportan las métricas entre el punto origen A = (1, 1) y el destino B = (4, 5):
           Eje Y
             ^
           5 |                     * B = (4, 5)
             |                    /|
           4 |                   / |
             |                  /  |  dy = |5 - 1| = 4
           3 |                 /   |
             |                /    |
           2 |               /     |
             |              /      |
           1 |  * A = (1,1) ------+
             +---------------------------> Eje X
                1     2     3     4
dx = |4 - 1| = 3- Distancia Euclidiana:
d_{L₂} = √(dx² + dy²) = √(3² + 4²) = √(9 + 16) = √(25) = 5.0
- Distancia Manhattan:
d_{L₁} = |dx| + |dy| = |3| + |4| = 7.0
- Relación Métrica Fundamental:
Para cualquier par de puntos en cualquier dimensión, siempre se cumple la desigualdad:
d_{L₂}(A, B) ≤ d_{L₁}(A, B) ≤ √(D) · d_{L₂}(A, B)La distancia euclidiana es el camino más corto posible en el espacio continuo.
La Maldición de la Dimensionalidad (Curse of Dimensionality)#
¿Por qué KNN falla catastróficamente si el vector de características tiene 100 o 1,000 dimensiones?
- Supongamos un hipercubo unitario de dimensión D con aristas de longitud 1.
- Para capturar una fracción r = 0.1 (el 10%) del volumen total de datos alrededor de un punto, la longitud de la arista del subcubo vecino debe ser:
- En dimensión D = 1: e₁(0.1) = 0.1 (necesitamos buscar en el 10% del rango de la recta).
- En dimensión D = 10: e₁₀(0.1) = 0.1^{0.1} ≈ 0.794 (¡necesitas abarcar casi el 80% de cada eje!).
- En dimensión D = 100: e₁₀₀(0.1) = 0.1^{0.01} ≈ 0.977 (¡necesitas abarcar el 98% de todo el espacio!).
- Conclusión de Silicio: En espacios de alta dimensión, todos los puntos se vuelven equidistantes entre sí. No existen vecinos "cercanos"; todos los puntos están en la periferia aislados. Para mitigar esto, se aplica reducción de dimensiones (PCA) o proyecciones aleatorias (LSH).
Análisis de Complejidad: Búsqueda Ingenua vs Max-Heap para LeetCode 973#
Deseamos encontrar los K puntos más cercanos al origen entre N puntos disponibles:
| Estrategia | Tiempo | Memoria Adicional | Mecánica y Traspaso de Caché |
|---|---|---|---|
Ordenar todo el arreglo (sort_by) | O(N log N) | O(1) in-place o O(N) | Ineficiente si K ll N. Si N = 10⁶ y K = 5, ordena 999,995 puntos inútiles. |
| Max-Heap acotado de tamaño K | O(N log K) | O(K) | Óptimo para Streaming. Mantiene solo los K mejores candidatos en memoria RAM. |
| Quickselect (Partición de Hoare) | O(N) promedio / O(N²) peor | O(1) | Modifica el arreglo de entrada. No soporta fuentes de datos en tiempo real (streams). |
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama de Flujo del Algoritmo#
Consulta el diagrama vectorial: 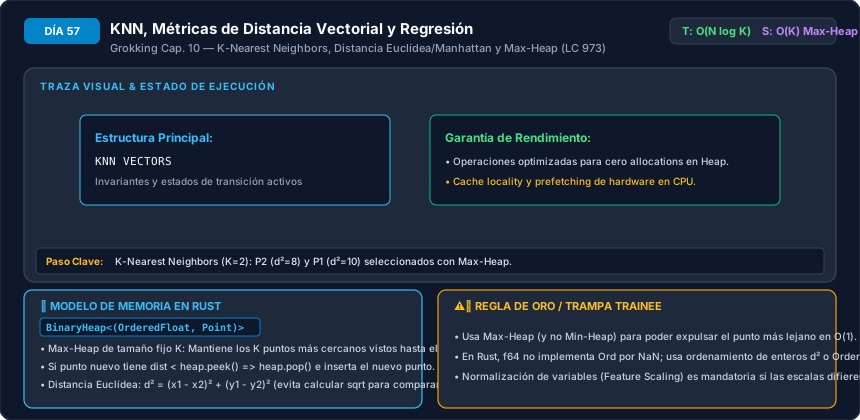
flowchart TD
    START(["Punto entrante P con dist² = d"]) --> CHK{"¿heap.len() < K?"}
    CHK -->|Sí| PUSH["heap.push(d, P)<br/>Complejidad: O(log K)"]
    CHK -->|No| CMP{"¿d < heap.peek().dist²?"}
    CMP -->|Sí| SWAP["heap.pop() // Desaloja el peor de los K<br/>heap.push(d, P)<br/>Complejidad: O(log K)"]
    CMP -->|No| SKIP["Ignorar punto P<br/>Complejidad: O(1)"]
    PUSH --> NEXT(["Siguiente punto"])
    SWAP --> NEXT
    SKIP --> NEXT
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Supongamos K = 2 y procesamos los puntos P₁(1, 3), P₂(-2, 2), P₃(0, 1) para hallar los 2 más cercanos al origen:
Distancias al cuadrado (dist_sq = x² + y²):
P1: (1, 3)  -> 1² + 3² = 1 + 9  = 10
P2: (-2, 2) -> (-2)² + 2² = 4 + 4 = 8
P3: (0, 1)  -> 0² + 1² = 0 + 1  = 1

CUADRO 1: heap.len() < K (Inserta P1)
Stack:
  k = 2
  heap: [ptr, cap: 2, len: 1]
Heap:
  Slot 0: PointDist { dist_sq: 10, x: 1, y: 3 }  <-- MAX (Tope del heap)

CUADRO 2: heap.len() < K (Inserta P2)
Stack:
  heap: [ptr, cap: 2, len: 2]
Heap:
  Slot 0: PointDist { dist_sq: 10, x: 1, y: 3 }  <-- MAX (10 > 8, se mantiene arriba)
  Slot 1: PointDist { dist_sq: 8, x: -2, y: 2 }

CUADRO 3: Procesa P3 (dist_sq = 1) -> heap está lleno (len == 2)
  ¿P3.dist_sq (1) < heap.peek().dist_sq (10)? SÍ.
  1. heap.pop() desaloja Slot 0 (P1 fuera).
  2. heap.push(P3) inserta P3.
  3. Rebalanceo sift-down:
Heap:
  Slot 0: PointDist { dist_sq: 8, x: -2, y: 2 }  <-- Nuevo MAX en el tope
  Slot 1: PointDist { dist_sq: 1, x: 0, y: 1 }

Resultado final extraído del Heap: P2(-2, 2) y P3(0, 1).
4. Implementación Canónica en Rust (Compilable con rustc --test)#
Archivo de referencia: practica-rust/dia_57.rs
use std::cmp::Ordering;
use std::collections::BinaryHeap;

/// Distancia Euclidiana (Norma L2) entre dos vectores de igual dimensión.
/// Formula: sqrt( sum_i (a[i] - b[i])^2 )
pub fn euclidean_distance(a: &[f64], b: &[f64]) -> Result<f64, &'static str> {
    if a.len() != b.len() || a.is_empty() {
        return Err("Vectors must be non-empty and of identical length");
    }
    let sum_sq: f64 = a.iter().zip(b.iter()).map(|(x, y)| (x - y).powi(2)).sum();
    Ok(sum_sq.sqrt())
}

/// Distancia Manhattan (Norma L1) entre dos vectores.
/// Formula: sum_i |a[i] - b[i]|
pub fn manhattan_distance(a: &[f64], b: &[f64]) -> Result<f64, &'static str> {
    if a.len() != b.len() || a.is_empty() {
        return Err("Vectors must be non-empty and of identical length");
    }
    let sum_abs: f64 = a.iter().zip(b.iter()).map(|(x, y)| (x - y).abs()).sum();
    Ok(sum_abs)
}

/// Similitud Coseno entre dos vectores en el rango [-1.0, 1.0].
/// Formula: (a . b) / (||a|| * ||b||)
pub fn cosine_similarity(a: &[f64], b: &[f64]) -> Result<f64, &'static str> {
    if a.len() != b.len() || a.is_empty() {
        return Err("Vectors must be non-empty and of identical length");
    }
    let mut dot_product = 0.0;
    let mut norm_a_sq = 0.0;
    let mut norm_b_sq = 0.0;

    for (&x, &y) in a.iter().zip(b.iter()) {
        dot_product += x * y;
        norm_a_sq += x * x;
        norm_b_sq += y * y;
    }

    let norm_a = norm_a_sq.sqrt();
    let norm_b = norm_b_sq.sqrt();

    if norm_a == 0.0 || norm_b == 0.0 {
        return Err("Cannot compute cosine similarity with zero-magnitude vector");
    }

    Ok(dot_product / (norm_a * norm_b))
}

/// Elemento representativo para LeetCode 973
#[derive(Debug, PartialEq, Eq)]
struct PointDist {
    dist_sq: i64,
    x: i32,
    y: i32,
}

impl PartialOrd for PointDist {
    fn partial_cmp(&self, other: &Self) -> Option<Ordering> {
        Some(self.cmp(other))
    }
}

impl Ord for PointDist {
    fn cmp(&self, other: &Self) -> Ordering {
        // En Rust BinaryHeap es un Max-Heap: el valor más grande queda en la cima
        self.dist_sq.cmp(&other.dist_sq)
    }
}

/// LeetCode 973: K Closest Points to Origin resuelto con Max-Heap en O(N log K)
pub fn k_closest(points: Vec<Vec<i32>>, k: i32) -> Vec<Vec<i32>> {
    let k = k as usize;
    if k == 0 || points.is_empty() {
        return Vec::new();
    }

    let mut max_heap: BinaryHeap<PointDist> = BinaryHeap::with_capacity(k);

    for pt in points {
        let x = pt[0];
        let y = pt[1];
        let dist_sq = (x as i64) * (x as i64) + (y as i64) * (y as i64);

        if max_heap.len() < k {
            max_heap.push(PointDist { dist_sq, x, y });
        } else if let Some(top) = max_heap.peek() {
            if dist_sq < top.dist_sq {
                max_heap.pop();
                max_heap.push(PointDist { dist_sq, x, y });
            }
        }
    }

    max_heap.into_iter().map(|pd| vec![pd.x, pd.y]).collect()
}

#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn test_distances() {
        let a = vec![1.0, 2.0];
        let b = vec![4.0, 6.0];
        assert_eq!(euclidean_distance(&a, &b).unwrap(), 5.0);
        assert_eq!(manhattan_distance(&a, &b).unwrap(), 7.0);
    }

    #[test]
    fn test_k_closest() {
        let points = vec![vec![1, 3], vec![-2, 2]];
        let res = k_closest(points, 1);
        assert_eq!(res, vec![vec![-2, 2]]);
    }
}
Implementación de Referencia en Python Tipado#
import heapq
import math
from typing import List, Tuple


def euclidean_distance(v1: List[float], v2: List[float]) -> float:
    """Distancia Euclidiana L2 en O(D)."""
    if len(v1) != len(v2) or not v1:
        raise ValueError("Vectores incompatibles o vacíos")
    return math.sqrt(sum((a - b) ** 2 for a, b in zip(v1, v2)))


def cosine_similarity(v1: List[float], v2: List[float]) -> float:
    """Similitud Coseno entre dos vectores en [-1.0, 1.0]."""
    dot = sum(a * b for a, b in zip(v1, v2))
    norm1 = math.sqrt(sum(a * a for a in v1))
    norm2 = math.sqrt(sum(b * b for b in v2))
    if norm1 == 0.0 or norm2 == 0.0:
        raise ValueError("Norma cero no permitida")
    return dot / (norm1 * norm2)


def k_closest_points_to_origin(points: List[List[int]], k: int) -> List[List[int]]:
    """LeetCode 973 resuelto con Max-Heap en O(N log K)."""
    # En Python, heapq es Min-Heap por defecto; invertimos dist_sq para simular Max-Heap
    max_heap: List[Tuple[int, int, int]] = []
    for x, y in points:
        dist_sq = x * x + y * y
        if len(max_heap) < k:
            heapq.heappush(max_heap, (-dist_sq, x, y))
        elif dist_sq < -max_heap[0][0]:
            heapq.heappushpop(max_heap, (-dist_sq, x, y))
    return [[x, y] for _, x, y in max_heap]
5. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En LeetCode 973, ¿por qué es rigurosamente superior usar un Max-Heap de tamaño K en lugar de un Min-Heap con todos los N elementos?
Respuesta:
- Consumo de Memoria: Un Min-Heap que almacena todos los elementos ocupa O(N) de memoria adicional en el Heap. Si N = 10⁸ y K = 10, almacenar todos los elementos requiere gigabytes de RAM. Un Max-Heap de tamaño K solo requiere almacenar exactamente K elementos en el Heap (O(K)), permitiendo procesar secuencias continuas de datos infinitas (streaming).
- Tiempo Computacional: Con el Max-Heap acotado, cada inserción cuesta O(log K). Al procesar N elementos, el tiempo total es O(N log K). Dado que K ll N, O(N log K) es sustancialmente menor que O(N log N) y reduce las faltas de caché (cache misses) al operar sobre un árbol binario diminuto que reside íntegramente en la caché L1/L2 del procesador.
Pregunta 2: ¿Qué fenómeno geométrico explica por qué la Similitud Coseno es insensible a la duplicación literal del texto en un documento?
Respuesta:
- Invariancia de Escalar: Sea A el vector de frecuencias de palabras de un texto. Si el texto se concatena consigo mismo duplicando cada palabra, el nuevo vector resultante es A' = 2A.
- Al computar la similitud coseno con otro vector cualquiera B:
- El escalar $2$ se cancela algebraicamente en el numerador y el denominador. Geométricamente, multiplicar un vector por un escalar positivo altera su magnitud (su longitud euclidiana), pero no altera en lo absoluto su ángulo de orientación en el hiperespacio.
Pregunta 3: ¿Por qué en KNN la elección de K impar es crítica para clasificación binaria y qué riesgo asume un K demasiado pequeño o demasiado grande?
Respuesta:
- Empates en votación: Si hay 2 clases (A y B) y seleccionamos K=4, es matemáticamente factible un empate $2$ a $2$, lo que exigiría heurísticas de desempate arbitrarias. Con K=3 o K=5, la suma de votos es impar y siempre existirá una mayoría estricta.
- *Riesgo con K=1 (Overfitting / Sobreajuste)*: El modelo es hipersensible al ruido. Si un dato anómalo o corrupto está etiquetado incorrectamente, cualquier consulta adyacente adoptará esa clase corrupta, creando fronteras de decisión caóticas.
- *Riesgo con K=N (Underfitting / Subajuste)*: Los vecinos más cercanos pierden relevancia y el algoritmo predecirá siempre la clase dominante mayoritaria de todo el dataset, ignorando por completo la posición espacial de la consulta.
Pregunta 4: Al implementar un Max-Heap en Rust con tipos de punto flotante (f64), ¿por qué f64 no implementa el trait Ord por defecto y cómo se resuelve de forma segura?
Respuesta:
- El estándar IEEE-754 y
NaN: En punto flotante, el valorf64::NAN(Not a Number) no satisface la propiedad matemática de orden total (tricotomía). En Rust,NaN == NaNevalúa afalse, y las comparacionesNaN < xoNaN > xretornan todasfalse. - Debido a esto,
f64solo implementaPartialOrd, noOrd. - Como
BinaryHeap<T>requiere obligatoriamente queT: Ordpara mantener los invariantes del montículo sin entrar en pánico o corromper el árbol, no podemos insertarf64directamente sin envolverlo en una estructura que maneje el desempate con.unwrap_or(Ordering::Equal)o utilizando enteros cuando sea posible (como eldist_sq: i64en LeetCode 973).
Pregunta 5: En un sistema de producción con N = 10⁷ vectores de embeddings de 1536 dimensiones (estándar de OpenAI), ¿por qué es inviable usar KNN exacto y qué alternativa arquitectónica implementan los ingenieros Staff?
Respuesta:
- Inviabilidad Computacional: Un KNN exacto requeriría calcular 10⁷ × 1536 ≈ 1.53 × 10¹⁰ multiplicaciones de coma flotante por cada petición. Si recibes 1,000 consultas por segundo, el sistema colapsaría de inmediato.
- Solución Staff (Búsqueda de Vecinos Más Cercanos Aproximada - ANN):
- Se renuncia al 100% de precisión exacta a cambio de una precisión del 99% en tiempo sublineal O(log N).
- Se emplean estructuras de grafos navegables de mundos pequeños jerárquicos (HNSW — Hierarchical Navigable Small World) o cuantización de producto (PQ — Product Quantization) implementadas en motores vectoriales como Faiss, Milvus, Qdrant o pgvector.