Sesión 45: Cracking the Coding Interview (Capítulo 10, Parte 1) — Búsqueda y Ordenamiento: Rotated Array, In-Place Merges y Sparse Search#
Navegación rápida:
- ← Sesión 44: CTCI Ch5 — Bit Manipulation Avanzada: Inversión, Siguiente Número y Conversión
- Sesión 46: CTCI Ch10 — Búsqueda en Matriz Ordenada y Rango en Flujo de Datos →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 65-80 minutos.
- Código fuente compilado y probado:
practica-rust/dia_45.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
En esta sesión exploramos las técnicas avanzadas de búsqueda binaria sobre estructuras rotadas o dispersas y la manipulación de arreglos contiguos sin memoria auxiliar. Consulta el Glosario Maestro y la Guía de Diagramas.
In-Place Back-to-Front Merge (Fusión de Atrás hacia Adelante)#
- (a) En palabras simples (intuición): Imagina que tienes una fila de asientos en el cine donde los primeros asientos están ocupados y los últimos están vacíos. Quieres intercalar a un nuevo grupo de amigos de forma ordenada por estatura. Si empiezas sentando gente por la izquierda, obligas a levantarse y moverse a todos los que ya estaban sentados. Pero si empiezas por los asientos vacíos del fondo (la derecha), puedes colocar a los más altos primero sin empujar ni molestar a nadie.
- (b) Definición técnica paso a paso: Técnica algorítmica para fusionar dos arreglos ordenados A y B dentro del espacio preasignado de A sin requerir un arreglo temporal. Se ubican tres punteros:
idx_a: Último elemento con datos reales en A (m - 1).idx_b: Último elemento en B (n - 1).write_idx: Última posición física del buffer disponible (m + n - 1).
Se comparan A[idx_a] y B[idx_b] y se escribe el mayor en A[writeᵢdx], decrementando los punteros hacia la izquierda en tiempo O(M + N) y espacio O(1).
- (c) Cómo funciona en Rust (memoria y tipos): Se opera sobre un slice mutable
&mut [i32]. Al no haber reasignaciones ni extensiones dinámicas del vector, la memoria Heap permanece intacta. - (d) Error típico de Junior: Intentar fusionar de izquierda a derecha (0 → N), lo que sobrescribe elementos de A antes de haberlos comparado, u obliga a usar
insert()desplazando en O(N²).
Search in Rotated Sorted Array (Invariante de la Mitad Monótona)#
- (a) En palabras simples (intuición): Tomas una baraja ordenada de cartas del 1 al 10 y cortas el mazo en algún punto arbitrario, poniendo la parte de abajo arriba (por ejemplo:
6, 7, 8, 9, 10, 1, 2, 3, 4, 5). Si partes este mazo por la mitad exacta, al menos una de las dos mitades sigue estando perfectamente ordenada de menor a mayor. Revisas si tu carta está dentro de esa mitad normal; si no, sabes con certeza que debe estar en la otra mitad chueca. - (b) Definición técnica paso a paso: Búsqueda binaria modificada para arreglos rotados en un pivote desconocido (CTCI 10.3 / LC 33). En cada iteración con índices
left,mid,right: - Si A[left] ≤ A[mid], la sub-secuencia [left, mid] es estrictamente creciente. El objetivo cae dentro si A[left] ≤ target < A[mid].
- En caso contrario, la sub-secuencia [mid, right] es monótonamente creciente. El objetivo cae dentro si A[mid] < target ≤ A[right].
- (c) Cómo funciona en Rust (memoria y tipos): Requiere calcular
mid = left + (right - left) / 2para evitar desbordamiento aritmético enusize. El retorno se modela conOption<usize>. - (d) Error típico de Junior: Evaluar target contra los extremos sin verificar primero cuál mitad conserva el orden monótono.
Degeneración por Duplicados en Rotated Array (LeetCode 81)#
- (a) En palabras simples (intuición): ¿Qué pasa si las cartas del mazo son casi todas doses:
[2, 2, 2, 0, 2, 2, 2]? La carta de la izquierda es 2, la del medio es 2 y la de la derecha es 2. ¿Cuál mitad está ordenada y dónde se esconde el 0? Ninguna pista matemática te lo dice; estás obligado a dar un paso corto hacia adentro descartando los bordes. - (b) Definición técnica paso a paso: Condición de ambigüedad cuando A[left] == A[mid] == A[right]. Es imposible deducir si el pivote reside a la izquierda o a la derecha. La única reducción segura es
left += 1; right -= 1;. En el caso peor donde todos los elementos son iguales, la complejidad temporal se degrada de O(log N) a O(N). - (c) Cómo funciona en Rust (memoria y tipos): Se implementa con un salto condicional
continueque encoge los límites respetando la frontera de subdesbordamiento deusize. - (d) Error típico de Junior: Asumir que la búsqueda binaria en arrays rotados siempre es O(log N); en presencia de duplicados, el peor caso es estrictamente O(N).
Sparse Search (Búsqueda en Arreglos de Cadenas Dispersas / CTCI 10.5)#
- (a) En palabras simples (intuición): Buscas una palabra en un diccionario donde un travieso borró muchas páginas dejando espacios en blanco (
""). Abres el libro por la mitad y encuentras una hoja en blanco. No sabes si tu palabra va antes o después porque la hoja no dice nada. Tienes que hojear con dos dedos (uno a la izquierda y otro a la derecha) hasta topar con la palabra más cercana con texto real para orientarte. - (b) Definición técnica paso a paso: Variante de búsqueda binaria sobre un arreglo ordenado lexicográficamente que contiene cadenas vacías intercaladas. Si strings[mid] == "", se expanden simultáneamente dos punteros auxiliares
mid_leftymid_righthasta hallar la primera cadena no vacía dentro del rango [left, right]. Si se localiza, se asignamida dicha posición y se procede con la comparación lexicográfica estándar. - (c) Cómo funciona en Rust (memoria y tipos): Se procesa sobre slices de referencias de string
&[&str], comparando constrings[mid] == target. - (d) Error típico de Junior: Expandir los punteros de búsqueda de cadenas no vacías fuera de las fronteras [left, right], lo que provoca que la búsqueda binaria oscile o entre en bucles infinitos.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
Demostración Matemática: El Invariante de la Mitad Monótona#
Sea un arreglo ordenado A = [x₀, x₁, …, x_{n-1}] rotado k posiciones:
Existe un único punto de discontinuidad (el pivote donde un número mayor precede a uno menor).
Cuando calculamos el punto medio mid = ⌊ (L + R) / 2 ⌋:
- El punto de discontinuidad solo puede estar en una de las dos mitades: en [L, mid] o en [mid, R].
- Por el principio del palomar, la otra mitad no contiene el pivote y, en consecuencia, está estrictamente ordenada.
Caso 1: A[L] ≤ A[mid]#
La mitad izquierda [L, mid] no contiene el pivote de ruptura.
- ¿El objetivo target se encuentra entre A[L] y A[mid]?
Caso 2: A[L] > A[mid]#
La discontinuidad está en la mitad izquierda, lo que garantiza que la mitad derecha [mid, R] está perfectamente ordenada:
- ¿El objetivo target se encuentra entre A[mid] y A[R]?
In-Place Back-to-Front Merge: ¿Por qué Jamás Sobrescribe Datos Válidos?#
Demostremos por qué el puntero de escritura jamás colisiona con el puntero de lectura de A:
Sea m la cantidad de elementos de A y n la cantidad de elementos de B. El buffer total mide m + n.
En cualquier momento de la ejecución:
- Han sido procesados k_b elementos de B y k_a elementos de A.
- El índice de escritura actual es:
- El índice del elemento que se está leyendo en A es:
Restemos ambas posiciones:
Dado que k_b es la cantidad de elementos de B ya escritos, y como máximo se pueden haber escrito todos los elementos de B (k_b ≤ n):
La igualdad writeᵢdx == idx_a solo ocurre cuando k_b = n, lo que significa que todos los elementos de B ya fueron insertados. A partir de ese instante, los elementos restantes de A ya están exactamente en la posición ordenada que les corresponde, por lo que el algoritmo puede detenerse de inmediato. ¡Es imposible que un elemento de A sea sobrescrito antes de ser leído!
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama de Decisiones en Rotated Array#
Consulta el diagrama vectorial: 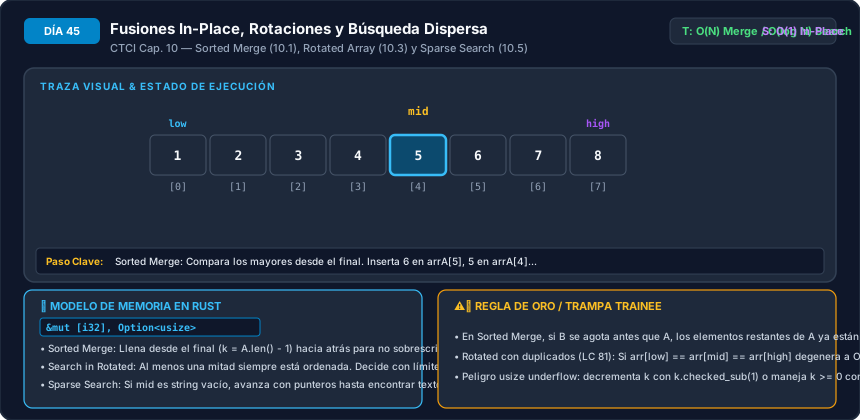
flowchart TD
    START["Evaluar mid = left + (right - left)/2"] --> CHECK{"nums[mid] == target"}
    CHECK -->|Sí| FOUND["Retornar Some(mid)"]
    CHECK -->|No| DUP{"¿nums[left] == nums[mid] == nums[right]?"}
    DUP -->|Sí: Ambigüedad| SHRINK["left += 1; right -= 1;<br/>(Descartar extremos)"]
    DUP -->|No| LEFT_ORDER{"¿nums[left] <= nums[mid]?"}
    LEFT_ORDER -->|Sí: Mitad Izquierda Ordenada| IN_LEFT{"¿nums[left] <= target < nums[mid]?"}
    IN_LEFT -->|Sí| R_MOVE["right = mid - 1"]
    IN_LEFT -->|No| L_MOVE["left = mid + 1"]
    LEFT_ORDER -->|No: Mitad Derecha Ordenada| IN_RIGHT{"¿nums[mid] < target <= nums[right]?"}
    IN_RIGHT -->|Sí| L_MOVE2["left = mid + 1"]
    IN_RIGHT -->|No| R_MOVE2["right = mid - 1"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Trazado del merge in-place de a = [1, 3, 5, 0, 0, 0] (m = 3) con b = [2, 4, 6] (n = 3):
ESTADO INICIAL:
Stack: idx_a = 2 (val 5), idx_b = 2 (val 6), write_idx = 5
Buffer Heap (a): [ 1,  3,  5,  _,  _,  _ ]
Buffer Heap (b): [ 2,  4,  6 ]

PASO 1: Compara a[2] (5) vs b[2] (6). 6 > 5 -> a[5] = 6. idx_b = 1, write_idx = 4.
Buffer a: [ 1,  3,  5,  _,  _,  6 ]

PASO 2: Compara a[2] (5) vs b[1] (4). 5 > 4 -> a[4] = 5. idx_a = 1, write_idx = 3.
Buffer a: [ 1,  3,  5,  _,  5,  6 ]

PASO 3: Compara a[1] (3) vs b[1] (4). 4 > 3 -> a[3] = 4. idx_b = 0, write_idx = 2.
Buffer a: [ 1,  3,  5,  4,  5,  6 ]

PASO 4: Compara a[1] (3) vs b[0] (2). 3 > 2 -> a[2] = 3. idx_a = 0, write_idx = 1.
Buffer a: [ 1,  3,  3,  4,  5,  6 ]

PASO 5: Compara a[0] (1) vs b[0] (2). 2 > 1 -> a[1] = 2. idx_b = -1, write_idx = 0.
Buffer a: [ 1,  2,  3,  4,  5,  6 ]

TERMINACIÓN: idx_b < 0. Se detiene el algoritmo.
Resultado en Heap: [1, 2, 3, 4, 5, 6]. 0 bytes de memoria auxiliar asignados.
4. Las 3 Trampas Clásicas en Entrevistas y Cómo Evitarlas#
Trampa 1: Subdesbordamiento de usize al Decrementar Punteros en Rust#
- El error: Escribir
right = mid - 1en Rust cuandomid == 0. - Por qué falla: En Rust, el tipo
usizees sin signo. Simides 0, la expresiónmid - 1provoca un pánico por underflow en modo debug, o se envuelve ausize::MAX(18,446,744,073,709,551,615) en release, causando accesos fuera de rango fatales (out of bounds). - La solución: Comprobar explícitamente
if mid == 0 { break; }antes de restar:
  if mid == 0 { break; }
  right = mid - 1;
Trampa 2: Continuar el Bucle en Sorted Merge cuando idx_b < 0#
- El error: Mantener el bucle mientras
idx_a >= 0 || idx_b >= 0. - Por qué falla: Si los elementos restantes pertenecen a A (
idx_b < 0), dichos elementos ya están en sus posiciones definitivas y ordenadas. Moverlos a sí mismos es código redundante e innecesario. - La solución: La condición del bucle debe ser estrictamente
while idx_b >= 0. En cuanto se agotan los elementos de B, la fusión está completa.
Trampa 3: Usar (left + right) / 2 Causando Desbordamiento Aritmético#
- El error: Calcular el punto medio con
let mid = (left + right) / 2. - Por qué falla: En arreglos gigantes o colecciones en memoria virtual de 32 bits, si left + right > 2³² - 1, la suma desborda a valores negativos o causa pánico.
- La solución: Utilizar siempre la fórmula matemáticamente equivalente a prueba de desbordamientos:
let mid = left + (right - left) / 2;5. Implementación Canónica en Rust y Comparativa con Python#
Implementación en Rust (practica-rust/dia_45.rs)#
/// CTCI 10.1 & LeetCode 88: Fusión In-Place de Atrás hacia Adelante.
pub fn sorted_merge(a: &mut [i32], m: usize, b: &[i32]) {
    let n = b.len();
    if n == 0 {
        return;
    }

    let mut idx_a = m as isize - 1;
    let mut idx_b = n as isize - 1;
    let mut write_idx = (m + n) as isize - 1;

    while idx_b >= 0 {
        if idx_a >= 0 && a[idx_a as usize] > b[idx_b as usize] {
            a[write_idx as usize] = a[idx_a as usize];
            idx_a -= 1;
        } else {
            a[write_idx as usize] = b[idx_b as usize];
            idx_b -= 1;
        }
        write_idx -= 1;
    }
}

/// CTCI 10.3 / LeetCode 33 & 81: Búsqueda binaria en arreglo rotado con duplicados.
pub fn search_rotated_array(nums: &[i32], target: i32) -> Option<usize> {
    if nums.is_empty() {
        return None;
    }

    let mut left = 0usize;
    let mut right = nums.len() - 1;

    while left <= right {
        let mid = left + (right - left) / 2;

        if nums[mid] == target {
            return Some(mid);
        }

        // Manejo de duplicados en extremos
        if nums[left] == nums[mid] && nums[mid] == nums[right] {
            left += 1;
            if right == 0 {
                break;
            }
            right -= 1;
            continue;
        }

        if nums[left] <= nums[mid] {
            if nums[left] <= target && target < nums[mid] {
                if mid == 0 {
                    break;
                }
                right = mid - 1;
            } else {
                left = mid + 1;
            }
        } else {
            if nums[mid] < target && target <= nums[right] {
                left = mid + 1;
            } else {
                if mid == 0 {
                    break;
                }
                right = mid - 1;
            }
        }
    }

    None
}

/// LeetCode 153: Mínimo en arreglo rotado ordenado.
pub fn find_min_rotated(nums: &[i32]) -> Option<i32> {
    if nums.is_empty() {
        return None;
    }

    let mut left = 0usize;
    let mut right = nums.len() - 1;

    if nums[left] <= nums[right] {
        return Some(nums[left]);
    }

    while left < right {
        let mid = left + (right - left) / 2;
        if nums[mid] > nums[right] {
            left = mid + 1;
        } else {
            right = mid;
        }
    }

    Some(nums[left])
}
Implementación de Referencia en Python (practica/dia_45_sorting_searching_rotated.py)#
from typing import List


def sorted_merge(a: List[int], b: List[int], last_a_idx: int) -> None:
    """CTCI 10.1: Fusión in-place de atrás hacia adelante."""
    idx_a = last_a_idx
    idx_b = len(b) - 1
    write_idx = last_a_idx + len(b)

    while idx_b >= 0:
        if idx_a >= 0 and a[idx_a] > b[idx_b]:
            a[write_idx] = a[idx_a]
            idx_a -= 1
        else:
            a[write_idx] = b[idx_b]
            idx_b -= 1
        write_idx -= 1


def search_rotated_array(nums: List[int], target: int) -> int:
    """CTCI 10.3 / LC 33: Búsqueda binaria en arreglo rotado."""
    left, right = 0, len(nums) - 1

    while left <= right:
        mid = left + (right - left) // 2
        if nums[mid] == target:
            return mid

        if nums[left] == nums[mid] == nums[right]:
            left += 1
            right -= 1
            continue

        if nums[left] <= nums[mid]:
            if nums[left] <= target < nums[mid]:
                right = mid - 1
            else:
                left = mid + 1
        else:
            if nums[mid] < target <= nums[right]:
                left = mid + 1
            else:
                right = mid - 1

    return -1
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En LeetCode 153 (Find Minimum in Rotated Sorted Array), ¿por qué comparamos nums[mid] > nums[right] y NO nums[mid] > nums[left]?
Respuesta:
- Causa raíz y asimetría de la rotación: El valor mínimo representa el punto de discontinuidad (pivote) del arreglo.
- Si comparas
nums[mid]connums[left], no puedes distinguir un arreglo no rotado de uno rotado en la mitad derecha. Por ejemplo, en[2, 3, 4, 5, 1],nums[mid] = 4 > nums[left] = 2y el mínimo está a la derecha. Pero en[1, 2, 3, 4, 5], tambiénnums[mid] = 3 > nums[left] = 1, pero el mínimo está en el extremo izquierdo. Comparar conleftes ambiguo. - En cambio, comparar con
nums[right]es inequívoco: sinums[mid] > nums[right], la propiedad de orden global fue violada en el lado derecho, garantizando que el punto de inflexión está forzosamente en[mid + 1, right].
Pregunta 2: ¿Por qué en Sparse Search (CTCI 10.5) la expansión simultánea en abanico (mid_left y mid_right) preserva la complejidad promedio en O(log N) pero degenera a O(N) en el peor caso?
Respuesta:
- Caso promedio: Si las cadenas vacías están distribuidas de forma esparcida, la distancia desde
midhasta el primer string no vacío más cercano es pequeña (O(1) pasos). En ese escenario, ubicar un string real toma tiempo constante y la búsqueda binaria descarta la mitad del arreglo en cada paso, manteniendo O(log N). - Caso patológico: Si el arreglo contiene un único string válido rodeado de N - 1 cadenas vacías (e.g.
["", "", "", "target", "", "", ""]), el bucle en abanico debe recorrer secuencialmente las posiciones vacías hasta agotar el espacio lineal, requiriendo Θ(N) operaciones de lectura.
Pregunta 3: ¿Por qué en Rust es mandatorio convertir los índices a isize al implementar algoritmos de punteros bidireccionales como In-Place Sorted Merge?
Respuesta:
- Causa raíz de tipos en Rust: El tipo nativo para indexar colecciones en Rust es
usize, un entero sin signo que no puede admitir valores negativos. - Durante el merge de atrás hacia adelante, la condición de parada de un puntero ocurre cuando ya procesó el elemento 0 y cae a -1.
- Si mantuviéramos
usize, la resta0usize - 1causaría un pánico en ejecución por underflow. Trabajar conisizepermite comparar de manera seguraidx_b >= 0y convertir ausize(idx as usize) únicamente en el instante preciso de acceder a la memoria del slice.
Pregunta 4: ¿Por qué en la búsqueda en arreglo rotado con duplicados (LeetCode 81), el peor caso teórico es estrictamente O(N) y no existe ningún algoritmo que pueda resolverlo en O(log N)?
Respuesta:
- Prueba por teoría de la información: Considera la entrada A = [1, 1, 1, …, 1, 0, 1, …, 1] y target = 0.
- Los extremos y el punto medio tienen todos el valor $1$. Dado que cada celda examinada responde exactamente $1$, ningún sondeo binario aporta información sobre si el valor $0$ está ubicado en la mitad izquierda o derecha.
- Para no incurrir en un falso negativo, el algoritmo debe inspeccionar potencialmente cada una de las N celdas del arreglo en busca del valor anómalo, lo que impone una cota inferior insalvable de Ω(N).
Pregunta 5: En In-Place Sorted Merge, ¿qué pasaría si el arreglo A tuviera espacio de buffer al inicio en lugar de al final? ¿Cómo se adaptaría la dirección de los punteros?
Respuesta:
- Simetría del invariante: Si el buffer vacío estuviese al principio (índices [0..n-1] vacíos y datos válidos en [n..m+n-1]), la estrategia se invertiría de forma especular:
- Se colocarían los punteros de lectura en los menores elementos de cada arreglo (el inicio:
idx_a = n,idx_b = 0). - El puntero de escritura arrancaría en
write_idx = 0. - Se escribiría de izquierda a derecha (0 → m + n - 1), colocando los menores primero. Por el mismo análisis algebraico de conservación de huecos, jamás se sobrescribirían los datos de A hacia la derecha.
7. Ejercicios de Práctica Independiente y Casos Límite#
- Paso Límite 1: Arreglo Rotado de Tamaño 1 y 2:
- Evalúa
search_rotated_array(&[1], 0)ysearch_rotated_array(&[3, 1], 1). Verifica que los casos base convergen inmediatamente sin pánicos de índice. - Paso Límite 2: Arreglo con Rotación Completa (k = 0):
- Para
nums = [1, 2, 3, 4, 5, 6], comprueba quefind_min_rotated(&nums)retornaSome(1)en la primera comprobación sin ejecutar el bucle completo. - Paso Límite 3: Sparse Search con Cadenas Vacías en los Extremos:
- Verifica que
sparse_search(&["", "", "alpha", ""], "alpha")localice correctamente el índice 2 y descarte las cadenas vacías de los extremos.
Navegación final: