Sesión 44: Cracking the Coding Interview (Capítulo 5, Parte 2 & 10.8) — Bit Manipulation Avanzada: Inversión, Swap y Memoria Acotada#
Navegación rápida:
- ← Sesión 43: CTCI Ch5 — Bit Manipulation: Fundamentos y Trucos Binarios
- Sesión 45: CTCI Ch10 — Búsqueda y Ordenamiento: Rotated Array y Búsqueda Binaria Modificada →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 65-80 minutos.
- Código fuente compilado y probado:
practica-rust/dia_44.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
En esta sesión profundizamos en el uso de operadores bitwise para resolver problemas de optimización extrema, secuencias binarias contiguas e ingeniería de memoria acotada. Consulta el Glosario Maestro y la Guía de Diagramas.
Flip Bit to Win (Inversión de un Bit para Secuencia Máxima)#
- (a) En palabras simples (intuición): Tienes una fila de luces donde casi todas están encendidas, pero hay algunos focos fundidos (ceros). Tienes un solo foco de repuesto. ¿Cuál foco fundido te conviene reemplazar para que la hilera continua de luces encendidas sea la más larga posible?
- (b) Definición técnica paso a paso: Problema de ventana deslizante binaria sobre un entero de 32 bits (CTCI 5.3). Se analiza la secuencia de bits manteniendo dos contadores:
current_len: Cantidad de 1s consecutivos en el bloque actual.prev_len: Cantidad de 1s consecutivos en el bloque anterior, separados por exactamente un 0.
Al encontrar un 0, la ventana potencial mide prev_len + current_len + 1. Si hay dos ceros seguidos, prev_len colapsa a 0.
- (c) Cómo funciona en Rust (memoria y tipos): Se procesa en un bucle fijo de 32 iteraciones sobre un
u32. No realiza asignaciones en el Heap (O(1) espacio, tiempo determinista en registros). - (d) Error típico de Junior: Olvidar el caso donde el entero está compuesto íntegramente por 1s (
!0u32o0xFFFFFFFF). En este caso no hay ceros para invertir, pero la longitud máxima es 32, no 0 ni 33.
Distancia de Hamming / Conversión de Bits (CTCI 5.6)#
- (a) En palabras simples (intuición): Comparas dos palabras binarias de la misma longitud. Cuentas cuántas letras difieren en la misma posición. Por ejemplo, en qué interruptores la casa A tiene la luz prendida mientras la casa B la tiene apagada.
- (b) Definición técnica paso a paso: Métrica que cuantifica el número mínimo de sustituciones necesarias para transformar una cadena de bits A en otra B. Se computa en dos pasos matemáticos exactos:
- diff = A oplus B (la operación XOR enciende un 1 únicamente donde los bits difieren).
- Contar la cantidad de 1s en diff (Hamming Weight) mediante Brian Kernighan o la instrucción de hardware
POPCNT.
- (c) Cómo funciona en Rust (memoria y tipos): La expresión
(a ^ b).count_ones()compila a dos instrucciones de procesador:xorseguido depopcnt. - (d) Error típico de Junior: Iterar bit a bit con un bucle de 32 pasos en lugar de limpiar directamente los bits 1 con
diff &= diff - 1.
Pairwise Swap (Intercambio de Bits Pares e Impares / CTCI 5.7)#
- (a) En palabras simples (intuición): Imagina a niños sentados en parejas en un autobús: niño 0 con niño 1, niño 2 con niño 3, etc. Les pides a todas las parejas que intercambien sus asientos al mismo tiempo.
- (b) Definición técnica paso a paso: Operación bitwise en O(1) que traslada todos los bits en posiciones impares (1, 3, 5...) hacia la derecha (posiciones 0, 2, 4...) y todos los bits en posiciones pares hacia la izquierda. Se realiza mediante dos máscaras hexadecimales fijas:
- Máscara de bits impares:
0xAAAAAAAA(10101010…₂). - Máscara de bits pares:
0x55555555(01010101…₂).
- (c) Cómo funciona en Rust (memoria y tipos): Se debe usar el tipo
u32. Si se utilizara un entero con signoi32, el desplazamiento a la derecha del bit de signo (bit 31) rellenaría con 1s por desplazamiento aritmético en lugar de ceros. - (d) Error típico de Junior: Desplazar antes de aplicar la máscara (
(n >> 1) & 0xAAAAAAAA), lo cual mezcla los bits antes de filtrarlos y genera un resultado incorrecto.
BitVector (Vector de Bits y Memoria Acotada / CTCI 10.8)#
- (a) En palabras simples (intuición): Si necesitas saber si 32,000 personas vinieron hoy a un evento, en lugar de anotar sus nombres o usar 32,000 variables booleanas (que gastarían 32 KB de RAM porque cada
boolocupa 1 byte entero en memoria), usas una cuadrícula de números de 32 bits donde cada bit individual representa a una persona. Con solo 1,000 números enteros guardas el estado de las 32,000 personas en menos de 4 Kilobytes. - (b) Definición técnica paso a paso: Estructura de datos compacta que implementa un arreglo de bits empaquetados dentro de enteros de tamaño de palabra nativo (
u32ou64). Para una posición de bit globalpos: - Índice de palabra (Word Index): pos gg 5 (equivalente a ⌊ pos / 32 ⌋).
- Índice de bit dentro de la palabra (Bit Index): pos & 0x1F (equivalente a pos ±od{32}).
- (c) Cómo funciona en Rust (memoria y tipos): Un
Vec<u32>de tamaño ⌈ N / 32 ⌉. Ahorra un factor de 8× comparado conVec<bool>, ya que unboolen Rust ocupa 1 byte (8 bits) para asegurar alineación de memoria direccionable. - (d) Error típico de Junior: Usar el operador de división
/ 32y módulo% 32en bucles de alto rendimiento, ignorando que los desplazamientos>> 5y las máscaras& 0x1Fson instrucciones de ciclo único en el hardware.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
Anatomía de las Máscaras Hexadecimales: 0xAAAAAAAA y 0x55555555#
¿Por qué los valores 0xAAAAAAAA y 0x55555555 son constantes mágicas universales en ingeniería de sistemas?
Analicemos la base hexadecimal frente a su representación binaria de 4 bits (nibble):
- La letra hexadecimal
Aequivale a 10 en base decimal:
Observa que los bits 1 y 3 (posiciones impares) están encendidos, mientras que los bits 0 y 2 están apagados.
- El dígito hexadecimal
5equivale a 5 en base decimal:
Observa que los bits 0 y 2 (posiciones pares) están encendidos, mientras que los bits 1 y 3 están apagados.
Al repetir A 8 veces para formar un número de 32 bits:
0xAAAAAAAA = 1010 1010 1010 1010 1010 1010 1010 1010
0x55555555 = 0101 0101 0101 0101 0101 0101 0101 0101
Son máscaras complementarias perfectas:
Al aplicar n & 0xAAAAAAAA, apagamos instantáneamente todos los bits pares dejando intactos los impares. Al desplazar a la derecha >> 1, los bits impares caen exactamente en las casillas pares adyacentes. Análogamente, (n & 0x55555555) << 1 eleva los bits pares a casillas impares. La unión | fusiona ambos flujos en un único ciclo de reloj.
Deducción Matemática de Memoria para CTCI 10.8 (Find Duplicates en 4 KB)#
Enunciado clásico: Tienes un arreglo con números del 1 al N, donde N ≤ 32,000. El arreglo contiene duplicados y dispones únicamente de 4 Kilobytes de memoria RAM. Encuentra todos los duplicados.
- Cálculo de Memoria Estándar:
- Si usamos un
HashSet<i32>oVec<bool>: - Unboolen memoria direccionable por bytes ocupa 1 byte:32,000 bytes ≈ 31.25 KB > 4 KB (Descalificado) - Cálculo con Bit Vector:
- Cada número solo necesita un estado booleano: ¿ya fue visto o no?
- 1 bit por número.
- Cantidad total de bits requeridos: 32,000 bits.
- Conversión a bytes:
(32,000 bits) / (8 bits/byte) = 4,000 bytes- Conversión a Kilobytes (KiB binario):4,000 bytes ≈ 3.906 KB ≤ 4 KB- ¡Cabe holgadamente dentro del límite estricto de 4 KB (4,096 bytes)!
- Cantidad de palabras
u32:⌈ 32,000 / 32 ⌉ = 1,000 enteros u321,000 × 4 bytes/u32 = 4,000 bytes
3. Visualización de Arquitectura y Memoria en Rust#
Diagrama de Flujo: BitVector Direccionamiento de Bits#
Consulta el diagrama vectorial: 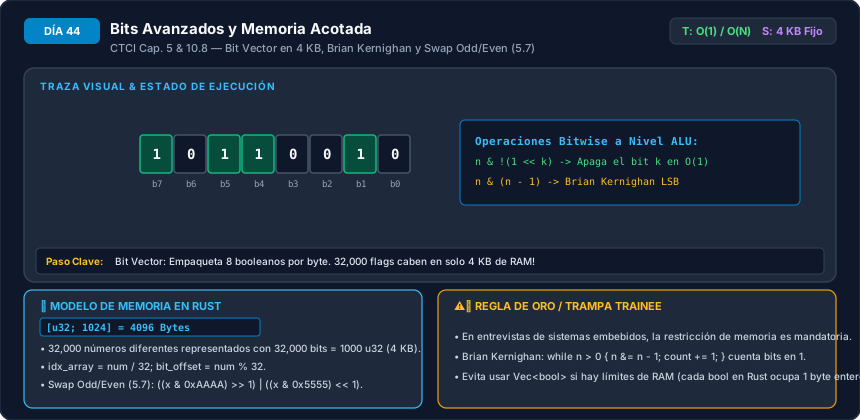
flowchart TD
    INPUT["Índice global: pos (ej: 75)"] --> WORD["Word Index: pos >> 5<br/>75 >> 5 = 2"]
    INPUT --> BIT["Bit Offset: pos & 0x1F<br/>75 & 31 = 11"]
    WORD --> MEM["Acceso a words[2] en Heap"]
    BIT --> OP{"Operación"}
    OP -->|GET| READ["(words[2] >> 11) & 1"]
    OP -->|SET| WRITE["words[2] |= (1 << 11)"]
    OP -->|CLEAR| CLR["words[2] &= !(1 << 11)"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Examinemos el estado de la memoria al ejecutar bit_vector.set(75):
STACK (Estructura BitVector):
[ size: 32000 | ptr: 0x55aa_0000 | cap: 1000 | len: 1000 ]

HEAP (Buffer continuo de words: Vec<u32>):
Dirección     Índice    Valor Binario (u32)
0x55aa_0000   words[0]  0b0000_..._0000 (cubre bits 0..31)
0x55aa_0004   words[1]  0b0000_..._0000 (cubre bits 32..63)
0x55aa_0008   words[2]  0b0000_..._0000 (cubre bits 64..95)  <-- AQUÍ RESIDE EL BIT 75
...
0x55aa_0FA0   words[999] (cubre bits 31968..31999)

OPERACIÓN EN REGISTROS CPU:
1. pos = 75
2. word_idx = 75 >> 5 = 2
3. bit_idx  = 75 & 0x1F = 11 (porque 64 + 11 = 75)
4. mask     = 1u32 << 11 = 0b0000_0000_0000_0000_0000_1000_0000_0000
5. words[2] |= mask
Estado de words[2] tras la operación: bit 11 queda permanentemente en 1.
Memoria total consumida en Heap: exactamente 4,000 bytes.
4. Las 3 Trampas Clásicas en Entrevistas y Cómo Evitarlas#
Trampa 1: Usar Desplazamiento con Signo en Pairwise Swap#
- El error: Declarar el parámetro como
i32y hacer(n & 0xAAAAAAAA) >> 1. - Por qué falla: Si el bit más significativo (bit 31) es 1, el número es negativo. En Rust, desplazar a la derecha un entero con signo realiza un desplazamiento aritmético, duplicando el bit 1 de signo en lugar de rellenar con un 0 en la posición 31. Esto corrompe el bit adyacente.
- La solución: Trabajar exclusivamente con tipos sin signo
u32para forzar un desplazamiento lógico (relleno de ceros):
let odd_shifted = (n & 0xAAAAAAAAu32) >> 1;Trampa 2: Desbordamiento de Índices en Operaciones Módulo Potencia de 2#
- El error: Escribir
pos % 32en código de infraestructura crítica creyendo que el compilador siempre optimizará el módulo. - Por qué falla: Con enteros con signo, el operador
%preserva el signo negativo, lo que impide al compilador emitir una máscaraANDdirecta si no demuestra positividad. - La solución: Usar siempre la máscara bitwise
pos & 0x1F(donde 0x1F = 31 = 2⁵ - 1). Para cualquier potencia de dos 2ᵏ, la operación x ±od{2ᵏ} equivale a x & (2ᵏ - 1).
Trampa 3: No Contemplar Números con Ceros Consecutivos en Flip Bit to Win#
- El error: Suponer que cada 0 encontrado divide dos secuencias de unos válidas que pueden unirse.
- Por qué falla: Si hay dos o más ceros consecutivos (e.g.
...110011...), invertir un solo 0 no une ambos bloques, solo permite extender el bloque inmediato adyacente en +1. - La solución: Si el bit siguiente al 0 también es 0, reiniciar
prev_len = 0:
  let next_bit = (num >> 1) & 1;
  prev_len = if next_bit == 1 { current_len } else { 0 };
  current_len = 0;
5. Implementación Canónica en Rust y Comparativa con Python#
Implementación en Rust (practica-rust/dia_44.rs)#
/// CTCI 5.3: Secuencia más larga contigua de 1s al invertir a lo sumo un bit 0 a 1.
pub fn flip_bit_to_win(mut num: u32) -> u32 {
    if num == !0u32 {
        return 32;
    }
    if num == 0 {
        return 1;
    }

    let mut current_len = 0;
    let mut prev_len = 0;
    let mut max_len = 1;

    for _ in 0..32 {
        let bit = num & 1;
        if bit == 1 {
            current_len += 1;
        } else {
            let next_bit = (num >> 1) & 1;
            prev_len = if next_bit == 1 { current_len } else { 0 };
            current_len = 0;
        }

        let combined = prev_len + current_len + 1;
        if combined > max_len {
            max_len = combined;
        }
        num >>= 1;
    }

    max_len.min(32)
}

/// CTCI 5.6: Hamming Distance / Conversion Distance.
pub fn conversion_distance(a: u32, b: u32) -> u32 {
    let mut diff = a ^ b;
    let mut count = 0;
    while diff != 0 {
        diff &= diff - 1;
        count += 1;
    }
    count
}

/// CTCI 5.7: Intercambio de bits pares e impares.
pub fn pairwise_swap(n: u32) -> u32 {
    let odd_mask = 0xAAAAAAAAu32;
    let even_mask = 0x55555555u32;

    let odd_shifted = (n & odd_mask) >> 1;
    let even_shifted = (n & even_mask) << 1;

    odd_shifted | even_shifted
}

/// CTCI 10.8: BitVector de alta densidad de memoria.
#[derive(Debug, Clone)]
pub struct BitVector {
    size: usize,
    words: Vec<u32>,
}

impl BitVector {
    pub fn new(size: usize) -> Self {
        let num_words = (size + 31) >> 5;
        Self {
            size,
            words: vec![0u32; num_words],
        }
    }

    pub fn get(&self, pos: usize) -> bool {
        if pos >= self.size {
            return false;
        }
        let word_idx = pos >> 5;
        let bit_idx = pos & 0x1F;
        (self.words[word_idx] >> bit_idx) & 1 == 1
    }

    pub fn set(&mut self, pos: usize) {
        if pos >= self.size {
            return;
        }
        let word_idx = pos >> 5;
        let bit_idx = pos & 0x1F;
        self.words[word_idx] |= 1u32 << bit_idx;
    }

    pub fn memory_bytes(&self) -> usize {
        self.words.len() * std::mem::size_of::<u32>()
    }
}
Implementación de Referencia en Python (practica/dia_44_bit_manipulation_avanzada.py)#
from typing import List


def flip_bit_to_win(num: int) -> int:
    """CTCI 5.3: Longitud máxima de 1s invirtiendo a lo sumo un bit 0."""
    num_32 = num & 0xFFFFFFFF
    if num_32 == 0xFFFFFFFF:
        return 32
    if num_32 == 0:
        return 1

    current_len = 0
    prev_len = 0
    max_len = 1

    for _ in range(32):
        bit = num_32 & 1
        if bit == 1:
            current_len += 1
        else:
            next_bit = (num_32 >> 1) & 1
            prev_len = current_len if next_bit == 1 else 0
            current_len = 0

        max_len = max(max_len, prev_len + current_len + 1)
        num_32 >>= 1

    return min(max_len, 32)


def conversion_distance(a: int, b: int) -> int:
    """CTCI 5.6: Cantidad de bits a invertir (Hamming Distance)."""
    diff = (a ^ b) & 0xFFFFFFFF
    count = 0
    while diff != 0:
        diff &= diff - 1
        count += 1
    return count


def pairwise_swap(n: int) -> int:
    """CTCI 5.7: Intercambio de bits pares con impares."""
    n_32 = n & 0xFFFFFFFF
    odd_shifted = (n_32 & 0xAAAAAAAA) >> 1
    even_shifted = (n_32 & 0x55555555) << 1
    return (odd_shifted | even_shifted) & 0xFFFFFFFF
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: En CTCI 5.7 (Pairwise Swap), ¿por qué es matemáticamente imposible que el desplazamiento hacia la izquierda (n & 0x55555555) << 1 colisione o sobrescriba algún bit del desplazamiento hacia la derecha (n & 0xAAAAAAAA) >> 1 al unirlos con |?
Respuesta:
- Causa raíz y ortogonalidad espacial:
- La máscara
0xAAAAAAAAcaptura únicamente bits en índices impares {1, 3, 5, …, 31}. Al desplazarlos hacia la derecha por 1 posición, sus nuevos índices son estrictamente pares {0, 2, 4, …, 30}. - La máscara
0x55555555captura únicamente bits en índices pares {0, 2, 4, …, 30}. Al desplazarlos hacia la izquierda por 1 posición, sus nuevos índices son estrictamente impares {1, 3, 5, …, 31}. - Disyunción perfecta: Los conjuntos de posiciones activas resultantes son mutuamente excluyentes (intersección vacía). En consecuencia, el operador
|opera como una suma booleana sin acarreo, garantizando que jamás se produzca colisión ni pérdida de información.
Pregunta 2: ¿Por qué en un sistema con arquitectura de 64 bits (x86_64) un BitVector que utiliza palabras u64 mejora el rendimiento respecto a uno con palabras u32?
Respuesta:
- Alineación de registros del procesador: Los registros generales en arquitecturas de 64 bits (
RAX,RBX, etc.) tienen 64 bits de ancho. Al operar conu64, la CPU procesa el doble de bits por instrucción de carga (movq) y por instrucción lógica (orq,andq). - Fórmulas de direccionamiento para
u64: - Índice de palabra: pos gg 6 (división entre 64).
- Offset de bit: pos & 0x3F (módulo 64 con 63 = 2⁶ - 1).
- Reduce a la mitad las operaciones de bucle al aplicar operaciones masivas como uniones (
OR) o intersecciones (AND) entre dos vectores de bits completos.
Pregunta 3: En CTCI 5.3 (Flip Bit to Win), ¿por qué evaluamos prev_len + current_len + 1 y cómo se evita contar un 33-avo bit inexistente?
Respuesta:
- Causa raíz: El término +1 representa el bit 0 que estamos convirtiendo hipotéticamente en 1. Ese bit actúa como puente unificador entre la secuencia de 1s previa (
prev_len) y la secuencia de 1s actual (current_len). - Control de cota superior: Si una palabra contiene 32 unos consecutivos, no hay ceros que invertir. Un análisis ingenuo sumaría 32 + 1 = 33, lo cual violaría el tamaño físico del registro. Por eso, al inicio detectamos si
num == !0u32retornando directamente 32, y al final aplicamosmax_len.min(32).
Pregunta 4: ¿Por qué en lenguajes como JavaScript o Python no basta con aplicar (a ^ b) para calcular la Distancia de Hamming con números negativos?
Respuesta:
- Representación de precisión infinita (Python): Los enteros negativos en Python tienen una cantidad virtualmente infinita de 1s a la izquierda (-1 = … 11111111₂). Si aplicas Brian Kernighan directamente sobre un número negativo sin enmascarar, el bucle
while diff != 0jamás terminará porque siempre habrá un bit 1 a la izquierda. - Solución obligatoria: Es indispensable forzar una máscara de 32 bits
diff = (a ^ b) & 0xFFFFFFFFpara truncar la representación al ancho exacto del registro de silicio. En Rust esto no ocurre porque los tipos primitivos (u32,i32) tienen cotas físicas de memoria fijas por especificación de lenguaje.
Pregunta 5: Si el problema de CTCI 10.8 exigiera procesar hasta N = 1,000,000 con un límite estricto de solo 32 KB de memoria RAM, ¿alcanzaría un BitVector estándar? ¿Qué alternativa algorítmica se debe usar?
Respuesta:
- Análisis de Capacidad:
Un vector de bits directo no cabe en los 32 KB disponibles.
- Solución Staff / Algoritmo Multi-Pase (External Sorting / Chunking):
- Dividir el rango de valores [1, 1,000,000] en 4 segmentos o pasadas consecutivas de 250,000 números cada una.
- Para 250,000 bits: 250,000 / 8 = 31,250 bytes ≈ 30.51 KB ≤ 32 KB.
- Se lee el arreglo de entrada completo 4 veces: en la pasada 1 se buscan duplicados en [1, 250000]; en la pasada 2 en [250001, 500000], reutilizando exactamente el mismo bloque de 32 KB de RAM.
7. Ejercicios de Práctica Independiente y Casos Límite#
- Paso Límite 1: Número Alternante Perfecto:
- Para N = 0xAAAAAAAA, verifica que
pairwise_swap(0xAAAAAAAA)retorna exactamente0x55555555. - Paso Límite 2: BitVector con Posición 0:
- Comprueba que
bit_vector.set(0)solo modifica el bit menos significativo dewords[0]sin corromper el resto. - Paso Límite 3: Next Number con el Mismo Peso de Hamming (CTCI 5.4): - Dado un entero positivo, encuentra el siguiente número mayor y el siguiente número menor que tengan exactamente la misma cantidad de bits en 1 utilizando manipulaciones de bits y conteo de ceros y unos no invasivo.
Navegación final: