Sesión 16: Grokking Algorithms (Capítulo 5) — Hash Tables Avanzadas, Rehashing y Diseño O(1)#
Navegación rápida:
- ← Sesión 15: Divide y Vencerás, Quicksort y Quickselect
- Sesión 17: CTCI Ch3 — Stacks, Queues y Three in One →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 60-75 minutos.
- Código fuente compilado y probado:
practica-rust/dia_16.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Las tablas hash son la estructura de datos más utilizada en producción en todos los lenguajes modernos. Consulta el Glosario Maestro y la Guía de Diagramas.
Función Hash (Hash Function)#
- (a) En palabras simples (intuición): Una trituradora determinista. Le metes cualquier libro o palabra y siempre produce el mismo número entero de tamaño fijo. Si cambias una sola letra, el número resultante cambia radicalmente.
- (b) Definición técnica paso a paso: Función matemática determinista H(k): mathcal{K} → ℤ que transforma un espacio de claves arbitrario de longitud variable mathcal{K} en un entero de tamaño fijo (ej. 64 bits), distribuyendo los valores uniformemente sobre el rango para minimizar colisiones.
- (c) Cómo funciona en Rust (memoria y tipos): Rust define el trait
std::hash::Hashpara tipos que pueden ser hasheados, ystd::hash::Hasherpara el algoritmo que computa los bytes. Por defecto, Rust usa SipHash-1-3, diseñado para mitigar ataques de denegación de servicio por colisión inducida (HashDoS). - (d) Error típico de Junior: Asumir que dos objetos con el mismo hash son idénticos. El hash reduce un espacio infinito a 64 bits, por lo que colisiones distintas son matemáticamente inevitables.
Factor de Carga (Load Factor - α)#
- (a) En palabras simples (intuición): El porcentaje de ocupación de un estacionamiento. Si un estacionamiento para 100 autos tiene 30 autos ocupados, es fácil encontrar lugar; si tiene 95 autos, tardarás mucho dando vueltas para encontrar un espacio libre.
- (b) Definición técnica paso a paso: Razón matemática entre el número de elementos almacenados N y la capacidad física total C de la tabla:
En direccionamiento abierto, cuando α ≥ 0.7, la longitud media de las cadenas de búsqueda crece abruptamente, degradando el acceso O(1) hacia O(N).
- (c) Cómo funciona en Rust (memoria y tipos): La biblioteca estándar de Rust (
std::collections::HashMap, basada en SwissTable) mantiene un factor de carga máximo de 7/8 = 87.5% gracias a sus grupos de sondeo acelerados con SIMD de 16 celdas. - (d) Error típico de Junior: Creer que una tabla hash puede llenarse al 100% sin penalización de rendimiento.
Rehashing y Redimensionamiento Amortizado#
- (a) En palabras simples (intuición): Mudarte a una casa con el doble de cuartos porque la actual ya no da abasto. Tienes que empacar todas tus cosas y reasignarlas a los nuevos cuartos según el nuevo plano.
- (b) Definición técnica paso a paso: Proceso dinámico en el cual, al superarse el umbral de factor de carga, se reserva un nuevo bloque contiguo de memoria con el doble de capacidad (2C) y se recalculan los índices de todas las claves preexistentes mediante H(k) ±od{2C}.
- (c) Cómo funciona en Rust (memoria y tipos): Requiere reservar un nuevo
Vecen el Heap, mover las entradas y descartar el buffer anterior. Aunque una operación puntual de rehashing cuesta O(N), su frecuencia geométrica decreciente garantiza un costo amortizado O(1) por inserción. - (d) Error típico de Junior: Pensar que el redimensionamiento es una simple copia contigua de memoria (
memcpy). Debido al cambio en el divisor del módulo, cada clave cambia de casilla.
Resolución de Colisiones: Separate Chaining vs Open Addressing#
- (a) En palabras simples (intuición): Si tu casillero asignado ya está ocupado:
- Separate Chaining: Cuelgas una bolsa debajo del casillero y metes el paquete allí junto a los demás.
- Open Addressing: Caminas al siguiente casillero contiguo desocupado y lo metes ahí.
- (b) Definición técnica paso a paso:
- Separate Chaining: Cada índice almacena un puntero a una lista enlazada o árbol binario. Tolera factores de carga altos (α > 1.0), pero gasta memoria extra en punteros y pierde localidad de caché.
- Open Addressing (Linear Probing): Todos los elementos residen en el arreglo principal. Ante una colisión, se inspecciona la celda (i + 1) ±od C. Maximiza la localidad espacial de caché L1/L2 pero sufre de clustering primario.
- (c) Cómo funciona en Rust (memoria y tipos): La implementación canónica de Rust moderna usa SwissTable (Open Addressing con Control Bytes SIMD), eliminando punteros auxiliares y logrando máxima velocidad de silicio.
- (d) Error típico de Junior: Elegir Separate Chaining creyendo que siempre es superior sin considerar el costo de cache misses en memoria de hardware.
Lápida (Tombstone)#
- (a) En palabras simples (intuición): Una señal de "en mantenimiento" en un asiento desocupado que le indica al inspector que siga buscando a las personas que entraron después, en lugar de creer que el vagón termina ahí.
- (b) Definición técnica paso a paso: Marcador de estado especial colocado en una celda de Open Addressing cuando un elemento es eliminado. Distingue una celda eliminada de una celda
Empty(virgen), permitiendo que las búsquedas continúen sondeando celdas posteriores que colisionaron previamente. - (c) Cómo funciona en Rust (memoria y tipos): Se representa elegantemente con un enum discriminado:
enum EntryState<K, V> { Empty, Occupied(K, V), Tombstone }. - (d) Error típico de Junior: Borrar un elemento colocando
Empty(None), lo cual corta prematuramente la cadena de búsqueda y "hace invisibles" a las claves que colisionaron después.
Técnica Swap-and-Pop en O(1)#
- (a) En palabras simples (intuición): Si quieres sacar un libro de en medio de una pila vertical sin que se caiga todo, tomas el último libro de arriba, lo pones en el hueco del que vas a sacar, y retiras el libro del medio.
- (b) Definición técnica paso a paso: Algoritmo para eliminar un elemento arbitrario de un arreglo contiguo en tiempo O(1). Consiste en sobrescribir el elemento a borrar con el último elemento del arreglo y luego llamar a
pop(). Requiere un HashMap que mantenga actualizados los índices de cada elemento. - (c) Cómo funciona en Rust (memoria y tipos): Es la base de
Vec::swap_remove(index), que intercambia el elemento objetivo con el último y reduce la longitud en 1 sin desplazar elementos en memoria. - (d) Error típico de Junior: Usar
Vec::remove(index)que desplaza todos los elementos posteriores en O(N).
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
La Matemática de la Dirección Física en RAM#
En silicio, una tabla hash no es magia: es un arreglo contiguo en memoria direccionado por aritmética de punteros.
- La clave k pasa por la función hash determinista:
h = H(k)
- El entero resultante se mapea al rango [0, C - 1] mediante el operador módulo:
idx = h ±od C(Si C es potencia de 2, h ±od C = h & (C - 1), lo cual se evalúa en un solo ciclo de CPU).
- La CPU calcula la dirección de memoria exacta sumando el desplazamiento base:
Dirección Física = Base + (idx × sizeof(Bucket))
¡El procesador lee la celda de memoria en un solo salto directo sin recorrer ninguna lista!
El Principio del Palomar y el Conflicto Inevitable#
Si tienes 10 palomas y 9 palomares, al menos un palomar albergará 2 palomas. En computación:
- El número de cadenas de texto posibles es infinito (∞).
- La capacidad del arreglo de la tabla hash es un entero finito C (ej. 1,024 casillas).
Por lo tanto, es matemáticamente imposible evitar que dos claves diferentes generen el mismo índice. Toda tabla hash en producción debe tener una política estricta de resolución de colisiones.
Demostración del Costo Amortizado O(1) en Rehashing#
Cuando la tabla duplica su tamaño cada vez que α ≥ 0.7:
- Inserciones que no redimensionan cuestan $1$ operación.
- Tras insertar N elementos, los redimensionamientos ocurrieron en tamaños 1, 2, 4, 8, …, N.
El trabajo total acumulado de todas las mudanzas es:
El costo total para insertar N elementos es:
Dividiendo por N operaciones:
3. Visualización Paso a Paso y Gráfica de Memoria en Rust#
Diagramas de Arquitectura#
- Gráfico SVG vectorial:
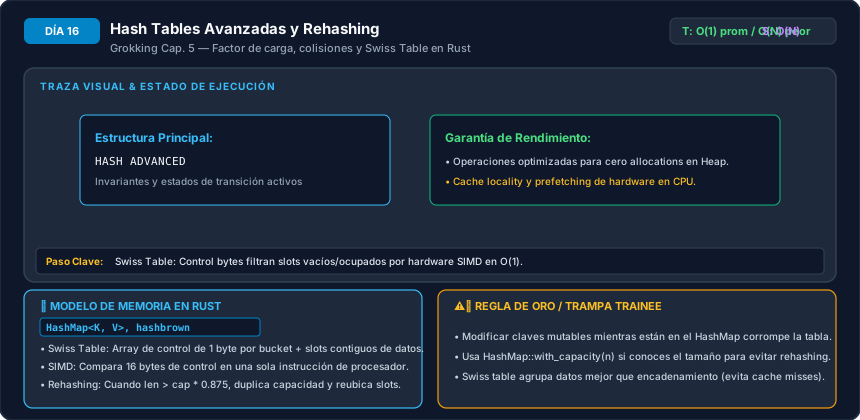 - Código fuente del diagrama: Fuente Mermaid
Flujo de Linear Probing con Lápida (Tombstone)#
flowchart TD
    A["Insertar Clave K con Hash=2"] --> B{"¿Bucket 2 libre?"}
    B -- Sí --> C["Guardar en Bucket 2"]
    B -- No (Colisión) --> D["Sondeo Lineal: Probar Bucket (2+1)=3"]
    D --> E{"¿Bucket 3 es Tombstone o Empty?"}
    E -- Sí --> F["Reutilizar Bucket 3"]
    E -- Ocupado --> G["Probar Bucket 4..."]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
Estructura CustomHashMap con capacidad inicial 4:
STACK                                            HEAP (Memoria Contigua de Buckets)
+-------------------------------+               +---------+---------+---------+---------+
| CustomHashMap                 |               | [0]     | [1]     | [2]     | [3]     |
|   buckets: Vec<EntryState> ---+-------------->| Empty   | Empty   | Empty   | Empty   |
|   len: 0                      |               +---------+---------+---------+---------+
|   capacity: 4                 |
|   max_load_factor: 0.70       |
+-------------------------------+

1. Insertar ("k1", 10) con hash_key = 2:
   Heap[2] = Occupied("k1", 10), len = 1

2. Insertar ("k2", 20) con hash_key = 2 (¡Colisión en 2!):
   Sondea (2 + 1) % 4 = 3 -> Heap[3] está Empty -> Ocupa Heap[3]
   Heap[3] = Occupied("k2", 20), len = 2

3. Eliminar "k1" (índice 2):
   Si pusiéramos Empty en Heap[2], una búsqueda de "k2" iría al índice 2,
   vería Empty y diría erróneamente "k2 no existe".
   Por eso colocamos un Tombstone:
   Heap[2] = Tombstone, len = 1:
   +---------+---------+-------------+--------------------+
   | [0]     | [1]     | [2]         | [3]                |
   | Empty   | Empty   | [TOMBSTONE] | Occupied("k2", 20) |
   +---------+---------+-------------+--------------------+

4. Buscar "k2":
   Hash inicial = 2.
   Heap[2] es Tombstone -> El sondeo IGNORA el Tombstone y sigue a Heap[3].
   Heap[3] coincide con "k2" -> ¡Encontrado con éxito en O(1)!
4. Implementación Canónica en Rust + Comparativa con Python#
Implementación Canónica en Rust (practica-rust/dia_16.rs)#
//! Día 16: Hash Tables Avanzadas, Rehashing y Diseño O(1) en Rust.
//! Compilable y verificable con `rustc --test`.

use std::collections::hash_map::DefaultHasher;
use std::collections::HashMap;
use std::hash::{Hash, Hasher};

#[derive(Debug, Clone, PartialEq, Eq)]
pub enum EntryState<K, V> {
    Empty,
    Occupied(K, V),
    Tombstone,
}

#[derive(Debug, Clone)]
pub struct CustomHashMap<K, V> {
    buckets: Vec<EntryState<K, V>>,
    len: usize,
    capacity: usize,
    max_load_factor: f64,
}

impl<K: Hash + Eq + Clone, V: Clone> CustomHashMap<K, V> {
    const DEFAULT_CAPACITY: usize = 8;
    const DEFAULT_LOAD_FACTOR: f64 = 0.70;

    pub fn new() -> Self {
        Self::with_capacity(Self::DEFAULT_CAPACITY)
    }

    pub fn with_capacity(capacity: usize) -> Self {
        let cap = capacity.max(4);
        Self {
            buckets: vec![EntryState::Empty; cap],
            len: 0,
            capacity: cap,
            max_load_factor: Self::DEFAULT_LOAD_FACTOR,
        }
    }

    pub fn len(&self) -> usize { self.len }
    pub fn capacity(&self) -> usize { self.capacity }
    pub fn load_factor(&self) -> f64 { self.len as f64 / self.capacity as f64 }

    fn hash_key(&self, key: &K) -> usize {
        let mut hasher = DefaultHasher::new();
        key.hash(&mut hasher);
        (hasher.finish() as usize) % self.capacity
    }

    pub fn insert(&mut self, key: K, value: V) -> Option<V> {
        if (self.len + 1) as f64 / self.capacity as f64 >= self.max_load_factor {
            self.rehash(self.capacity * 2);
        }

        let mut idx = self.hash_key(&key);
        let mut first_tombstone: Option<usize> = None;

        for _ in 0..self.capacity {
            match &mut self.buckets[idx] {
                EntryState::Occupied(existing_key, existing_val) => {
                    if *existing_key == key {
                        return Some(std::mem::replace(existing_val, value));
                    }
                }
                EntryState::Tombstone => {
                    if first_tombstone.is_none() {
                        first_tombstone = Some(idx);
                    }
                }
                EntryState::Empty => {
                    let target_idx = first_tombstone.unwrap_or(idx);
                    self.buckets[target_idx] = EntryState::Occupied(key, value);
                    self.len += 1;
                    return None;
                }
            }
            idx = (idx + 1) % self.capacity;
        }

        if let Some(target_idx) = first_tombstone {
            self.buckets[target_idx] = EntryState::Occupied(key, value);
            self.len += 1;
            None
        } else {
            self.rehash(self.capacity * 2);
            self.insert(key, value)
        }
    }

    pub fn get(&self, key: &K) -> Option<&V> {
        let mut idx = self.hash_key(key);
        for _ in 0..self.capacity {
            match &self.buckets[idx] {
                EntryState::Occupied(existing_key, val) => {
                    if existing_key == key { return Some(val); }
                }
                EntryState::Tombstone => {}
                EntryState::Empty => return None,
            }
            idx = (idx + 1) % self.capacity;
        }
        None
    }

    pub fn remove(&mut self, key: &K) -> Option<V> {
        let mut idx = self.hash_key(key);
        for _ in 0..self.capacity {
            match &mut self.buckets[idx] {
                EntryState::Occupied(existing_key, _) => {
                    if existing_key == key {
                        let old_entry = std::mem::replace(&mut self.buckets[idx], EntryState::Tombstone);
                        if let EntryState::Occupied(_, val) = old_entry {
                            self.len -= 1;
                            return Some(val);
                        }
                    }
                }
                EntryState::Tombstone => {}
                EntryState::Empty => return None,
            }
            idx = (idx + 1) % self.capacity;
        }
        None
    }

    fn rehash(&mut self, new_capacity: usize) {
        let old_buckets = std::mem::replace(&mut self.buckets, vec![EntryState::Empty; new_capacity]);
        self.capacity = new_capacity;
        self.len = 0;

        for entry in old_buckets {
            if let EntryState::Occupied(k, v) = entry {
                self.insert(k, v);
            }
        }
    }
}

// RandomizedSet: LeetCode 380 con Swap-and-Pop O(1)
#[derive(Debug, Default)]
pub struct RandomizedSet {
    values: Vec<i32>,
    val_to_idx: HashMap<i32, usize>,
}

impl RandomizedSet {
    pub fn new() -> Self { Self::default() }

    pub fn insert(&mut self, val: i32) -> bool {
        if self.val_to_idx.contains_key(&val) { return false; }
        self.val_to_idx.insert(val, self.values.len());
        self.values.push(val);
        true
    }

    pub fn remove(&mut self, val: i32) -> bool {
        let &target_idx = match self.val_to_idx.get(&val) {
            Some(idx) => idx,
            None => return false,
        };

        let last_idx = self.values.len() - 1;
        let last_val = self.values[last_idx];

        self.values[target_idx] = last_val;
        self.val_to_idx.insert(last_val, target_idx);

        self.values.pop();
        self.val_to_idx.remove(&val);
        true
    }

    pub fn get_at(&self, idx: usize) -> Option<i32> {
        self.values.get(idx).copied()
    }
}
Implementación Canónica en Python (practica/dia_16_advanced_hash_tables.py)#
import random
from typing import List, Dict

class RandomizedSet:
    """LeetCode 380: Insert Delete GetRandom en O(1) tiempo estricto."""
    def __init__(self) -> None:
        self._values: List[int] = []
        self._val_to_index: Dict[int, int] = {}

    def insert(self, val: int) -> bool:
        if val in self._val_to_index:
            return False
        self._val_to_index[val] = len(self._values)
        self._values.append(val)
        return True

    def remove(self, val: int) -> bool:
        if val not in self._val_to_index:
            return False

        idx = self._val_to_index[val]
        last_val = self._values[-1]

        # Swap-and-Pop en O(1)
        self._values[idx] = last_val
        self._val_to_index[last_val] = idx

        self._values.pop()
        del self._val_to_index[val]
        return True

    def get_random(self) -> int:
        return random.choice(self._values)
5. Las 3 Trampas Clásicas en Entrevistas#
- Afirmar que Rehashing Copia la Memoria Directamente: - Al redimensionar la tabla de capacidad C a 2C, el operador módulo cambia (hash ±od C ≠ hash ±od{2C}). Cada clave debe recalcular su posición final.
- Intentar
getRandom()en O(1) sobre una Hash Table Pura: - En una tabla hash pura no puedes elegir un elemento aleatorio en O(1) porque las claves están dispersas con huecos vacíos. Convertir las claves a lista cuesta O(N). - Solución: Estructura híbridaVec+HashMapcon técnica Swap-and-Pop. - Usar Claves Mutables:
- Si una clave muta sus campos internos mientras está dentro de una tabla hash, su valor de dispersión cambia. La clave quedará atrapada en el índice viejo y se volverá ilocalizable para siempre (fuga de memoria silenciosa). En Rust, el compilador previene esto exigiendo que las claves implementen
Hash + Eqy tomen propiedad o préstamos inmutables.
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: ¿Por qué en una tabla con Open Addressing y Linear Probing no podemos colocar simplemente Empty cuando eliminamos un elemento?
Respuesta Técnica Detallada: En direccionamiento abierto, la condición de parada (terminator) para concluir que una clave no existe en la tabla es encontrar una celda con estado Empty. Si tres claves A, B, C colisionan en el mismo índice base k, el algoritmo las acomodará secuencialmente en las casillas k, k+1, k+2. Si eliminamos B y marcamos la casilla k+1 como Empty: Cuando un usuario busque la clave C, el algoritmo computará el hash base k, verá que k está ocupada por A, avanzará a k+1, encontrará Empty y detendrá la búsqueda inmediatamente, retornando None. ¡La clave C se vuelve completamente invisible a pesar de estar almacenada en la casilla k+2! Al marcar la casilla con una Lápida (Tombstone), el sondeo sabe que debe ignorar la casilla eliminada y continuar explorando hacia adelante.
Pregunta 2: ¿Cuál es el costo amortizado de una inserción en una tabla hash que duplica su capacidad cuando el factor de carga alcanza 0.70?
Respuesta Técnica Detallada: El costo amortizado es estrictamente O(1). Aunque la operación de rehashing individual tiene un costo temporal de O(N) porque debe redistribuir los N elementos en el nuevo arreglo, los redimensionamientos ocurren a intervalos geométricamente crecientes (N, 2N, 4N, …). Para que ocurra un nuevo rehashing de tamaño 2N, se tuvieron que haber realizado previamente al menos 0.30 × N operaciones de inserción regulares que costaron O(1). Distribuyendo el costo del rehashing entre todas las operaciones previas que lo financiaron, cada inserción soporta una sobrecarga constante pequeña, garantizando O(1) amortizado.
Pregunta 3: ¿Por qué Rust utiliza SipHash por defecto en std::collections::HashMap en lugar de algoritmos más rápidos como MurmurHash o FNV?
Respuesta Técnica Detallada: Por seguridad criptográfica contra ataques de denegación de servicio (HashDoS Attacks). Algoritmos rápidos como MurmurHash o FNV son lineales y predecibles. Un atacante malintencionado que envía datos HTTP (como parámetros POST en un formulario web) puede generar matemáticamente miles de claves que colisionan exactamente en el mismo bucket. Esto degrada las operaciones de inserción y búsqueda del servidor de O(1) a O(N), disparando el uso de CPU al 100% y colgando el servicio. SipHash-1-3 utiliza una clave secreta aleatoria generada por el sistema operativo en cada arranque del programa, haciendo que sea computacionalmente inviable para un atacante predecir colisiones masivas. Para casos donde el rendimiento en microbenchmarks internos es crítico y las claves provienen de fuentes confiables, los desarrolladores de Rust pueden sustituir SipHash por un hasher rápido como ahash o fxhash.
Pregunta 4: En el diseño de LeetCode 380 (RandomizedSet), ¿por qué es obligatoria la técnica de Swap-and-Pop en lugar de simplemente eliminar el elemento del vector con remove(idx)?
Respuesta Técnica Detallada: Un arreglo contiguo (Vec<T>) almacena sus elementos en bloques adyacentes de memoria física. Cuando eliminas un elemento en una posición intermedia idx mediante vec.remove(idx): La CPU debe desplazar físicamente todos los elementos que se encuentran a la derecha de idx una posición hacia la izquierda mediante memmove para cerrar el hueco. Esta operación requiere mover N - idx - 1 elementos, lo que tiene un costo temporal de O(N). La técnica Swap-and-Pop resuelve esto en O(1) estricto:
- Copia el valor del último elemento en la posición
idxa borrar. - Actualiza el mapa con la nueva posición del elemento que fue movido.
- Llama a
vec.pop(), lo que simplemente decrementa la longitud interna del vector en 1 sin desplazar ningún bloque de memoria.
Pregunta 5: ¿Cómo gestiona SwissTable (la arquitectura interna del HashMap de Rust) las colisiones de forma más eficiente que el sondeo lineal tradicional?
Respuesta Técnica Detallada: SwissTable desacopla el almacenamiento de los datos de su metadato de control:
- Mantiene un arreglo paralelo de Control Bytes de 1 byte por bucket (7 bits del hash superior
H2y 1 bit de estado: Vacío, Lleno, Borrado). - Agrupa los control bytes en bloques contiguos de 16 bytes alineados.
- Emplea instrucciones vectoriales SIMD del procesador (
_mm_cmpeq_epi8en x86) para comparar 16 celdas simultáneamente en un solo ciclo de reloj de hardware. - Si ninguna de las 16 celdas coincide, el puntero salta en bloques completos sin tener que deserializar ni comparar las claves reales completas en memoria, reduciendo drásticamente los accesos a la RAM principal.
7. Puente a LeetCode y Práctica de Código#
- LeetCode 380 — Insert Delete GetRandom O(1) (Medium):
- Diseño híbrido de
Vec+HashMapcon técnica Swap-and-Pop. - LeetCode 705 — Design HashSet (Easy): - Implementa un conjunto hash desde cero utilizando direccionamiento abierto o encadenamiento.
- LeetCode 706 — Design HashMap (Easy): - Implementa un mapa clave-valor con rehashing dinámico.
- LeetCode 128 — Longest Consecutive Sequence (Medium):
- Búsqueda en tiempo lineal O(N) utilizando un HashSet para detectar inicios de secuencia (
num - 1 not in set).
8. Tarea en Papel para Hoy#
Dibuja en papel una tabla hash de direccionamiento abierto con capacidad 7 y función hash H(x) = x ±od 7:
- Inserta la siguiente secuencia:
10,17,24. - Muestra cómo se resuelven las colisiones lineales en las casillas contiguas.
- Elimina el número
17colocando una Lápida[DELETED]. - Traza paso a paso la búsqueda de
24confirmando que la lápida permite que la búsqueda tenga éxito.
Navegación: