Sesión 15: Grokking Algorithms (Capítulo 4) — Divide y Vencerás, Quicksort y Quickselect#
Navegación rápida:
- ← Sesión 14: Consolidación y Simulacro Técnico de Semana 2
- Sesión 16: Grokking Ch5 — Hash Tables Avanzadas y Rehashing →
- Glosario Maestro
- Guía de Diagramas de Arquitectura
- Tiempo estimado de estudio: 60-75 minutos.
- Código fuente compilado y probado:
practica-rust/dia_15.rs
1. Diccionario de Conceptos del Día (Desde Cero para Junior / Trainee)#
Iniciamos la Semana 3 entrando al paradigma algorítmico más poderoso de las ciencias de la computación: la descomposición recursiva. Consulta el Glosario Maestro y la Guía de Diagramas para más detalles.
Divide y Vencerás (Divide and Conquer - D&C)#
- (a) En palabras simples (intuición): Si tienes que limpiar una mansión de 10 habitaciones tú solo, te abrumas; pero si divides la tarea asignando cada habitación a un equipo independiente y combinas los cuartos limpios, el trabajo se vuelve manejable y estructurado.
- (b) Definición técnica paso a paso: Estrategia de diseño algorítmico basada en 3 fases formales: (1) Dividir el problema original en subproblemas disjuntos más pequeños del mismo tipo, (2) Vencer resolviendo recursivamente cada subproblema (alcanzando de forma inevitable un caso base trivial), y (3) Combinar las soluciones parciales para construir la solución global.
- (c) Cómo funciona en Rust (memoria y tipos): La recursión empuja marcos de pila (stack frames) con argumentos que suelen ser sub-rebanadas (
&mut [T]). Si no se divide de forma mutuamente excluyente, el Borrow Checker bloquea la compilación por alias mutables simultáneos. - (d) Error típico de Junior: Olvidar o definir incorrectamente el caso base, provocando una recursión infinita que satura la pila y causa un Stack Overflow.
Pivote de Quicksort (Pivot)#
- (a) En palabras simples (intuición): El punto de referencia en una fila de personas. Dices: "todos los que midan menos de 1.75 m a mi izquierda, los más altos a mi derecha". Cuando terminan de moverse, tú ya estás exactamente en tu lugar final de la fila sin necesidad de moverte nunca más.
- (b) Definición técnica paso a paso: Elemento elegido de un arreglo para desacoplar el espacio de búsqueda. Durante la partición, los elementos menores o iguales al pivote se colocan antes que él y los mayores después. Tras la partición, el pivote reside en su posición definitiva absoluta en el arreglo.
- (c) Cómo funciona en Rust (memoria y tipos): Se almacena en una variable local por copia o referencia (
let pivot = arr[high]). Al particionar mediante intercambios en memoria (arr.swap(i, j)), se reorganiza el slice sin asignar memoria adicional en el Heap. - (d) Error típico de Junior: Asumir que los sub-arreglos a la izquierda y derecha del pivote quedan ordenados tras la partición; solo están separados respecto al valor del pivote, no internamente ordenados.
Partición Lomuto vs Partición Hoare#
- (a) En palabras simples (intuición): Lomuto es como un guardia que empuja lentamente a la gente pequeña al fondo de la sala con un solo puntero de barrido. Hoare es como dos inspectores que caminan desde los extremos opuestos y hacen que dos personas intercambien lugares cada vez que una está fuera de orden.
- (b) Definición técnica paso a paso:
- Lomuto: Elige el último elemento como pivote. Mantiene un puntero de frontera i e itera j desde el inicio. Realiza en promedio tres veces más operaciones
swap, pero es conceptualmente simple e intuitivo. - Hoare: Usa dos punteros que convergen desde ambos extremos hacia el centro. Realiza aproximadamente un tercio de los
swapsde Lomuto y es más eficiente en CPU, pero su índice de parada no garantiza colocar el pivote en su celda final fija en una sola pasada. - (c) Cómo funciona en Rust (memoria y tipos): En Rust,
arr.swap(i, j)verifica límites en modo debug y se traduce a un intercambio de registros de procesador en ensamblador optimizado. - (d) Error típico de Junior: Mezclar las condiciones de parada de Lomuto y Hoare, produciendo bucles infinitos cuando los elementos son iguales al pivote.
Partición de 3 Vías (Dutch National Flag / Dijkstra)#
- (a) En palabras simples (intuición): Separar una canasta de canicas rojas, blancas y azules en tres secciones continuas contiguas.
- (b) Definición técnica paso a paso: Técnica atribuida a Edsger Dijkstra que particiona el arreglo en tres zonas disjuntas: menores que el pivote (
< pivot), iguales al pivote (== pivot), y mayores que el pivote (> pivot). - (c) Cómo funciona en Rust (memoria y tipos): Emplea tres índices (
low,mid,high) sobre un slice mutable&mut [T]. Si un arreglo contiene miles de valores repetidos, reduce el tiempo de Quicksort de O(N²) a O(N). - (d) Error típico de Junior: Usar Quicksort estándar de 2 vías en arreglos con claves homogéneas (como arreglos llenos de ceros), sufriendo una degradación catastrófica a O(N²).
Quickselect (Algoritmo de Selección de Hoare)#
- (a) En palabras simples (intuición): Si buscas al quinto estudiante más alto del colegio, no necesitas ordenar a todos los alumnos; solo particionas y descartas la mitad donde seguro no está el quinto.
- (b) Definición técnica paso a paso: Algoritmo derivado de Quicksort para encontrar el k-ésimo elemento menor sin ordenar toda la colección. En cada paso de partición, determina si el índice del pivote es menor, igual o mayor que k, descartando la mitad innecesaria y recurriendo solo en el subrango objetivo.
- (c) Cómo funciona en Rust (memoria y tipos): Se implementa de forma iterativa con un bucle
while start <= endsobre sub-rebanadas mutables, garantizando tiempo O(N) promedio y espacio auxiliar estricto O(1). - (d) Error típico de Junior: Ordenar toda la colección con
arr.sort()(O(N log N)) para responder una consulta de un solo elemento k.
Localidad Espacial y Línea de Caché L1/L2 (Spatial Locality)#
- (a) En palabras simples (intuición): Cuando lees una palabra de un libro, la vista no enfoca una letra aislada; absorbe la línea completa circundante. La CPU hace lo mismo con la memoria RAM.
- (b) Definición técnica paso a paso: Principio de hardware por el cual cuando un procesador solicita un byte en memoria, la controladora carga una línea de caché completa (usualmente 64 bytes) a las memorias ultrarrápidas L1/L2. Algoritmos que acceden a celdas contiguas (como Quicksort sobre arreglos) sufren mínimos cache misses.
- (c) Cómo funciona en Rust (memoria y tipos): Los slices
[i32]almacenan sus enteros contiguos en RAM (4 bytes * N), permitiendo que una sola línea de caché aloje hasta 16 elementos seguidos. - (d) Error típico de Junior: Comparar Quicksort con Mergesort o Heapsort solo por su complejidad teórica O(N log N) sin entender que las constantes ocultas de Quicksort son mucho menores debido a la localidad de caché.
split_at_mut en Rust (División Segura de Slices)#
- (a) En palabras simples (intuición): Cortar una tabla de madera por la mitad para dársela a dos carpinteros. Cada uno puede clavar y pintar su mitad de forma segura sin interferir con el otro.
- (b) Definición técnica paso a paso: Método estándar de la biblioteca
core::slicede Rust que divide un slice mutable&mut [T]en dos sub-rebanadas mutables disjuntas(&mut [T], &mut [T])en un índice determinado, garantizando en tiempo de compilación que no existen referencias mutables solapadas. - (c) Cómo funciona en Rust (memoria y tipos): Descompone el puntero base y la longitud interna en dos pares
(ptr, len1)y(ptr + len1, len2). Permite recursión paralela o bilateral en Quicksort sin recurrir a bloquesunsafe. - (d) Error típico de Junior: Intentar hacer
quicksort(&mut arr[..p])yquicksort(&mut arr[p+1..])en dos líneas separadas sinsplit_at_mut, lo cual dispara el errorE0499: cannot borrow *arr as mutable more than once at a time.
2. Desglose Conceptual desde Primeros Principios (Sin Asumir Nada)#
El Principio Inductivo de Divide y Vencerás#
Todo algoritmo de D&C se basa en una hipótesis de inducción matemática:
- Paso 0 (Caso Base): Para N ≤ 1, el arreglo ya está trivialmente ordenado. No se requiere ninguna operación.
- Paso Inductivo: Suponiendo que sabemos ordenar cualquier arreglo de longitud menor a N:
- Particionamos el arreglo alrededor del pivote en O(N) operaciones de comparación e intercambio.
- Si la partición divide el problema en dos mitades de tamaño aproximadamente N/2, el costo temporal viene dado por la relación de recurrencia del Teorema Maestro:
T(N) = 2T(N/2) + O(N)- Resolviendo la recurrencia: la altura del árbol de llamadas es log₂ N. En cada nivel del árbol se procesan exactamente N elementos acumulados.Costo total = N × log₂ N = O(N log N)
La Anatomía del Peor Caso: O(N²)#
¿Cuándo colapsa Quicksort? Cuando la partición es patológicamente desequilibrada:
- Si el arreglo ya está ordenado (
[1, 2, 3, 4, 5]) y seleccionamos siempre el último elemento como pivote: - Nivel 1: Sub-arreglos de tamaño N - 1 y $0$. Costo: N.
- Nivel 2: Sub-arreglos de tamaño N - 2 y $0$. Costo: N - 1.
- Nivel N: Costo: $1$.
- Además del tiempo cuadrático, la pila de llamadas (Call Stack) consume O(N) marcos, arriesgando un desbordamiento fatal (Stack Overflow).
- Mitigación: Mediana de Tres (Median of Three: elegir la mediana entre el primer, medio y último elemento) o elección aleatoria del pivote (Randomized Quicksort).
La Matemática de Quickselect: ¿Por Qué es O(N) en Promedio?#
A diferencia de Quicksort, que desciende por ambas ramas del árbol de recursión, Quickselect desecha una rama completa en cada partición:
Expresando la suma del trabajo realizado:
¡El trabajo total converge a una constante multiplicada por N!
3. Visualización Paso a Paso y Gráfica de Memoria en Rust#
Diagramas de Arquitectura#
- Gráfico SVG vectorial:
 - Código fuente del diagrama: Fuente Mermaid
Árbol de Recursión y Partición Lomuto#
flowchart TD
    A["[3, 8, 2, 5, 1, 4] | Pivote = 4"] --> B["Partición Lomuto: [3, 2, 1] - (4) - [8, 5]"]
    B --> C["Sub-rama Izquierda: [3, 2, 1]"]
    B --> D["Pivote (4) en posición final índice 3"]
    B --> E["Sub-rama Derecha: [8, 5]"]
    C --> F["Pivote = 1 -> [1] y [3, 2] -> Ordenado"]
    E --> G["Pivote = 5 -> [5] y [8] -> Ordenado"]
Visualización Cuadro por Cuadro de Memoria en Rust (Stack vs Heap)#
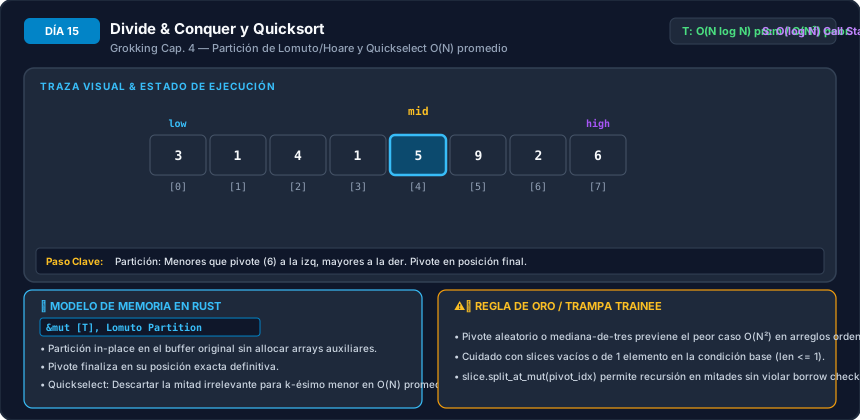
Imaginemos un vector en memoria dinámica vec = vec![10, 80, 30, 90, 40, 50, 70]:
STACK                                            HEAP (Memoria Contigua)
+------------------------+                      +----+----+----+----+----+----+----+
| vec: Vec<i32>          |                      | 0  | 1  | 2  | 3  | 4  | 5  | 6  |
|  ptr: -----------------+--------------------->| 10 | 80 | 30 | 90 | 40 | 50 | 70 |
|  cap: 7                |                      +----+----+----+----+----+----+----+
|  len: 7                |                        ^                             ^
+------------------------+                       low                           high
                                                (Pivote arr[high] = 70)

Llamada a quicksort_lomuto(&mut vec[..]):
Stack Frame 1:
- arr: Slice (&mut [i32]) -> { ptr: Heap[0], len: 7 }
- partition_lomuto reorganiza in-place mediante swap de registros CPU.
- Tras la partición, pivote 70 queda en índice 5:
  Heap: [ 10 | 30 | 40 | 50 | 70 | 90 | 80 ]
                               ^
                          pivote final (idx 4 o 5 según partición)

Uso de arr.split_at_mut(p):
- left  -> Slice { ptr: Heap[0], len: p }       (elementos < pivote)
- rest  -> Slice { ptr: Heap[p], len: 7 - p }
- right -> &mut rest[1..] -> Slice { ptr: Heap[p+1], len: 6 - p }

¡CERO llamadas a malloc! CERO copias de datos en Heap.
Toda la subdivisión ocurre reconfigurando punteros y longitudes en el Stack.
4. Implementación Canónica en Rust + Comparativa con Python#
Implementación Canónica en Rust (practica-rust/dia_15.rs)#
//! Día 15: Divide y Vencerás, Quicksort y Quickselect en Rust.
//! Compilable y verificable con `rustc --test`.

/// Partición Lomuto estándar sobre un slice mutable.
pub fn partition_lomuto(arr: &mut [i32]) -> usize {
    let len = arr.len();
    if len <= 1 {
        return 0;
    }

    let pivot = arr[len - 1];
    let mut i = 0;

    for j in 0..len - 1 {
        if arr[j] <= pivot {
            arr.swap(i, j);
            i += 1;
        }
    }

    arr.swap(i, len - 1);
    i
}

/// Quicksort in-place usando `split_at_mut` para garantizar borrow checking sin unsafe.
pub fn quicksort_lomuto(arr: &mut [i32]) {
    if arr.len() <= 1 {
        return;
    }

    let p = partition_lomuto(arr);

    // split_at_mut divide el slice en dos sub-rebanadas disjuntas
    let (left, rest) = arr.split_at_mut(p);
    let right = &mut rest[1..]; // Excluye el pivote rest[0] ya colocado

    quicksort_lomuto(left);
    quicksort_lomuto(right);
}

/// Partición de Tres Vías (Dutch National Flag) para duplicados masivos.
pub fn partition_3way(arr: &mut [i32], pivot: i32) -> (usize, usize) {
    let mut low = 0;
    let mut mid = 0;
    let mut high = arr.len();

    while mid < high {
        if arr[mid] < pivot {
            arr.swap(low, mid);
            low += 1;
            mid += 1;
        } else if arr[mid] == pivot {
            mid += 1;
        } else {
            high -= 1;
            arr.swap(mid, high);
        }
    }

    (low, high)
}

/// Quicksort con Partición de Tres Vías: O(N) si todos los elementos son idénticos.
pub fn quicksort_3way(arr: &mut [i32]) {
    if arr.len() <= 1 {
        return;
    }

    let pivot = arr[arr.len() / 2];
    let (eq_start, eq_end) = partition_3way(arr, pivot);

    let (left, rest) = arr.split_at_mut(eq_start);
    let right = &mut rest[eq_end - eq_start..];

    quicksort_3way(left);
    quicksort_3way(right);
}

/// Quickselect: Retorna el k-ésimo elemento más pequeño (0-indexado) en O(N) promedio.
pub fn quickselect(arr: &mut [i32], k: usize) -> Option<i32> {
    if arr.is_empty() || k >= arr.len() {
        return None;
    }

    let mut start = 0;
    let mut end = arr.len() - 1;

    while start <= end {
        let p_rel = partition_lomuto(&mut arr[start..=end]);
        let p_abs = start + p_rel;

        if p_abs == k {
            return Some(arr[p_abs]);
        } else if p_abs < k {
            start = p_abs + 1;
        } else {
            if p_abs == 0 {
                break;
            }
            end = p_abs - 1;
        }
    }

    None
}

/// Quickselect para encontrar el k-ésimo elemento más grande (1-indexado).
pub fn find_kth_largest(arr: &mut [i32], k: usize) -> Option<i32> {
    if arr.is_empty() || k == 0 || k > arr.len() {
        return None;
    }
    let target_idx = arr.len() - k;
    quickselect(arr, target_idx)
}

#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn test_quicksort_lomuto_basic() {
        let mut arr = [10, 80, 30, 90, 40, 50, 70];
        quicksort_lomuto(&mut arr);
        assert_eq!(arr, [10, 30, 40, 50, 70, 80, 90]);
    }

    #[test]
    fn test_quicksort_3way_duplicates() {
        let mut arr = [5, 2, 5, 3, 5, 1, 5, 4, 5];
        quicksort_3way(&mut arr);
        assert_eq!(arr, [1, 2, 3, 4, 5, 5, 5, 5, 5]);
    }

    #[test]
    fn test_quickselect_find_kth() {
        let mut arr = [3, 2, 1, 5, 6, 4];
        assert_eq!(quickselect(&mut arr, 0), Some(1));
        assert_eq!(find_kth_largest(&mut arr, 2), Some(5));
    }
}
Implementación Canónica en Python (practica/dia_15_divide_and_conquer_quicksort.py)#
from typing import List, Optional

def quicksort_in_place(arr: List[int], low: int = 0, high: Optional[int] = None) -> None:
    """Quicksort in-place con partición Lomuto."""
    if high is None:
        high = len(arr) - 1

    if low < high:
        pivot_idx = _partition_lomuto(arr, low, high)
        quicksort_in_place(arr, low, pivot_idx - 1)
        quicksort_in_place(arr, pivot_idx + 1, high)

def _partition_lomuto(arr: List[int], low: int, high: int) -> int:
    pivot = arr[high]
    i = low
    for j in range(low, high):
        if arr[j] <= pivot:
            arr[i], arr[j] = arr[j], arr[i]
            i += 1
    arr[i], arr[high] = arr[high], arr[i]
    return i

def quickselect(arr: List[int], k: int) -> int:
    """Retorna el k-ésimo elemento más pequeño (0-indexado) en O(N) promedio."""
    if not arr or k < 0 or k >= len(arr):
        raise ValueError("k fuera de límites")

    nums = arr[:]
    low, high = 0, len(nums) - 1

    while low <= high:
        p_idx = _partition_lomuto(nums, low, high)
        if p_idx == k:
            return nums[p_idx]
        elif p_idx < k:
            low = p_idx + 1
        else:
            high = p_idx - 1

    raise RuntimeError("Error en partición")
5. Las 3 Trampas Clásicas en Entrevistas#
- La Pesadilla del Arreglo Ordenado (O(N²) Peor Caso): - Si eliges siempre el último o primer elemento como pivote en arreglos ya ordenados, la partición genera subproblemas de tamaños N - 1 y $0$. El tiempo colapsa a O(N²) y la pila de llamadas se desborda (Stack Overflow). - Solución: Implementar Mediana de Tres (Median of Three) o pivote aleatorio.
- Duplicados Masivos y Degradación Cuadrática:
- En una partición Lomuto clásica, un arreglo lleno de elementos idénticos (
[5, 5, 5, 5, 5]) pone todos los elementos a la izquierda del pivote, produciendo particiones de N - 1 y $0$. - Solución: Utilizar Partición de 3 Vías (Dutch National Flag) que agrupa todos los duplicados en O(N) en el centro. - Off-by-One en Quickselect (K-ésimo Menor vs Mayor):
- En LeetCode 215 ("Kth Largest"), el k-ésimo mayor (1-indexado) equivale al índice
len - ken orden ascendente 0-indexado. Olvidar esta conversión produce el complemento opuesto de la respuesta.
6. Preguntas de Comprensión Profunda y Diagnóstico Socrático#
Pregunta 1: ¿Por qué Quicksort suele ser en la práctica significativamente más rápido que Mergesort y Heapsort, a pesar de que los tres tienen una cota asintótica de O(N log N)?
Respuesta Técnica Detallada: La respuesta radica en la arquitectura física del hardware y la jerarquía de memoria:
- Localidad Espacial de Caché: Quicksort particiona elementos contiguos en RAM. Cuando la CPU accede a una celda, la controladora carga una línea de caché completa (64 bytes). Las iteraciones consecutivas encuentran los datos directamente en la caché ultrarrápida L1/L2 (1-3 ciclos de reloj), evitando costosas lecturas a la RAM principal (~200 ciclos).
- Cero Reservas Dinámicas: Quicksort es completamente in-place. Mergesort requiere asignar un arreglo auxiliar en el Heap de tamaño O(N) y copiar elementos de ida y vuelta en cada nivel, lo cual sobrecarga el administrador de memoria del sistema operativo (malloc / free).
- Heapsort y Saltos de Caché: Heapsort navega por un árbol binario implícito donde los hijos del nodo i están en 2i + 1 y 2i + 2. A medida que el árbol crece, estos accesos saltan distancias enormes en memoria, provocando fallos de caché continuos (cache misses).
Por estas razones, los factores constantes de Quicksort son sustancialmente menores.
Pregunta 2: ¿Cómo demuestra la serie geométrica que Quickselect se ejecuta en tiempo lineal O(N) promedio mientras que Quicksort requiere O(N log N)?
Respuesta Técnica Detallada: Analicemos el árbol de recursión de ambos algoritmos:
- En Quicksort, tras realizar una partición de costo N, el algoritmo debe resolver ambos sub-arreglos de tamaño aproximado N/2. La suma en cada nivel es:
Total: N × log₂ N = O(N log N).
- En Quickselect, tras realizar la partición de costo N, el algoritmo inspecciona el índice p del pivote y descarta completamente una de las dos mitades. El trabajo restante es solo sobre una mitad:
Factorizando N:
La suma infinita de la serie geométrica con razón r = 1/2 converge exactamente a:
Por lo tanto:
Pregunta 3: ¿Por qué el compilador de Rust rechaza compilar Quicksort si intentas escribir quicksort(&mut arr[..p]) y quicksort(&mut arr[p+1..]) de forma directa, y cómo lo soluciona split_at_mut?
Respuesta Técnica Detallada: El principio cardinal del sistema de tipos de Rust establece que solo puede existir una única referencia mutable activa a cualquier dato en un instante dado (regla de exclusión mutua de aliasing). Cuando escribes:
quicksort(&mut arr[..p]);
quicksort(&mut arr[p + 1..]);
El analizador de préstamos (Borrow Checker) opera a nivel de variable base (arr). Desde el punto de vista estático del compilador, ambas líneas intentan tomar un préstamo mutable exclusivo sobre el mismo objeto contenedor arr. El compilador no inspecciona en tiempo de compilación el valor numérico dinámico de las variables p y p+1 para deducir que los rangos son numéricamente disjuntos. slice::split_at_mut(mid) resuelve esto encapsulando un bloque interno seguro que divide el puntero base y las longitudes: Retorna una tupla (&mut [T], &mut [T]) donde cada elemento tiene tipos de vida y referencias independientes garantizadas por la biblioteca estándar, permitiendo que ambas mitades se presten a sub-funciones recursivas simultáneamente.
Pregunta 4: En un arreglo donde todos los elementos son exactamente iguales (ej. un arreglo de 100,000 ceros), ¿por qué la partición Lomuto colapsa a O(N^2) y cómo lo soluciona la partición de tres vías de Dijkstra?
Respuesta Técnica Detallada: En la partición Lomuto, la condición de comparación es if arr[j] <= pivot. Si todos los elementos son idénticos a pivot:
- La condición
arr[j] <= pivotse evalúa como verdadera para absolutamente todos los elementos. - El puntero i avanza en cada una de las iteraciones.
- Al final, el pivote se intercambia consigo mismo en el extremo derecho (
arr.len() - 1). - La partición devuelve un sub-arreglo izquierdo de tamaño N - 1 y un sub-arreglo derecho de tamaño $0$.
- La recursión apenas reduce el problema en 1 elemento por nivel, requiriendo N niveles de recursión con costo O(N) cada uno → O(N²).
La partición de 3 vías de Dijkstra clasifica los elementos en tres grupos: < pivot, == pivot, > pivot. Cuando todos los elementos son iguales, el primer barrido coloca todos los elementos en la sección central == pivot. Como la sección == pivot ya contiene elementos en su posición final ordenada, Quicksort no recurre sobre ellos. Los sub-arreglos izquierdo (< pivot) y derecho (> pivot) resultan vacíos, terminando el algoritmo en una sola pasada O(N).
Pregunta 5: ¿Cómo diseñarías una prueba de estrés unitaria para garantizar que una implementación de Quickselect no entre en un bucle infinito en casos de frontera?
Respuesta Técnica Detallada: Una suite de pruebas rigurosa debe cubrir los siguientes casos límite (boundary conditions):
- Colección vacía:
quickselect(&mut [], 0)debe retornarNoneo error seguro de forma inmediata sin causar panic por indexación. - Colección unitaria:
quickselect(&mut [42], 0)debe retornarSome(42). - Índice k fuera de límites:
quickselect(&mut [1, 2, 3], 5)debe retornarNonede forma segura. - Elementos extremos: k = 0 (mínimo global) y k = len - 1 (máximo global).
- Colección con duplicados masivos:
[5, 5, 5, 5, 5]para k = 2. - Colección inversamente ordenada:
[9, 8, 7, 6, 5, 4, 3, 2, 1]para todo k ∈ [0, 8].
Si el cálculo del nuevo rango en el bucle iterativo (start = p + 1 o end = p - 1) no excluye estrictamente el índice del pivote, en colecciones de dos elementos ([2, 1]) el algoritmo puede repetir el mismo rango indefinidamente. La prueba de colecciones ordenadas e invertidas detecta este error al instante.
7. Puente a LeetCode y Práctica de Código#
- LeetCode 912 — Sort an Array (Medium): - Implementa Quicksort con selección de pivote aleatorio o Mediana de 3 para evitar los casos adversarios de prueba diseñados para forzar O(N²).
- LeetCode 215 — Kth Largest Element in an Array (Medium): - Resuélvelo primero con Quickselect en O(N) promedio y compara su rendimiento frente a un Min-Heap de tamaño K (O(N log K)).
- LeetCode 75 — Sort Colors (Medium): - Aplicación pura y directa de la Partición de 3 Vías (Dutch National Flag) en una sola pasada O(N) y espacio O(1).
8. Tarea en Papel para Hoy#
Toma una hoja y realiza a mano la traza completa de Quickselect para encontrar el segundo elemento más grande (k = 2, 1-indexado) en: nums = [7, 10, 4, 3, 20, 15]
- Calcula el índice objetivo 0-indexado:
len(nums) - k = 6 - 2 = 4. - Dibuja la partición con pivote
15y muestra en qué sub-arreglo decide continuar el algoritmo. - Confirma que el resultado final es
15.
Navegación: